第 1 页|标题与摘要
中文译文 · 对应英文原报告第 1 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
阅读说明:本文基于我提供的39页报告及与AI的讨论整理。桌面三栏依次为英文原文、中文译文、我的译法与批注。点击英文页面可打开PDF对应页,也可放大原图。译文中的“我们”指原作者团队;右栏问题为我的提问归纳,回答是讨论后的补充解释。
没有第二次完整训练:递归自我改进止步于前沿预训练吗?
SII-GAIR|SII & XinxuAI
摘要
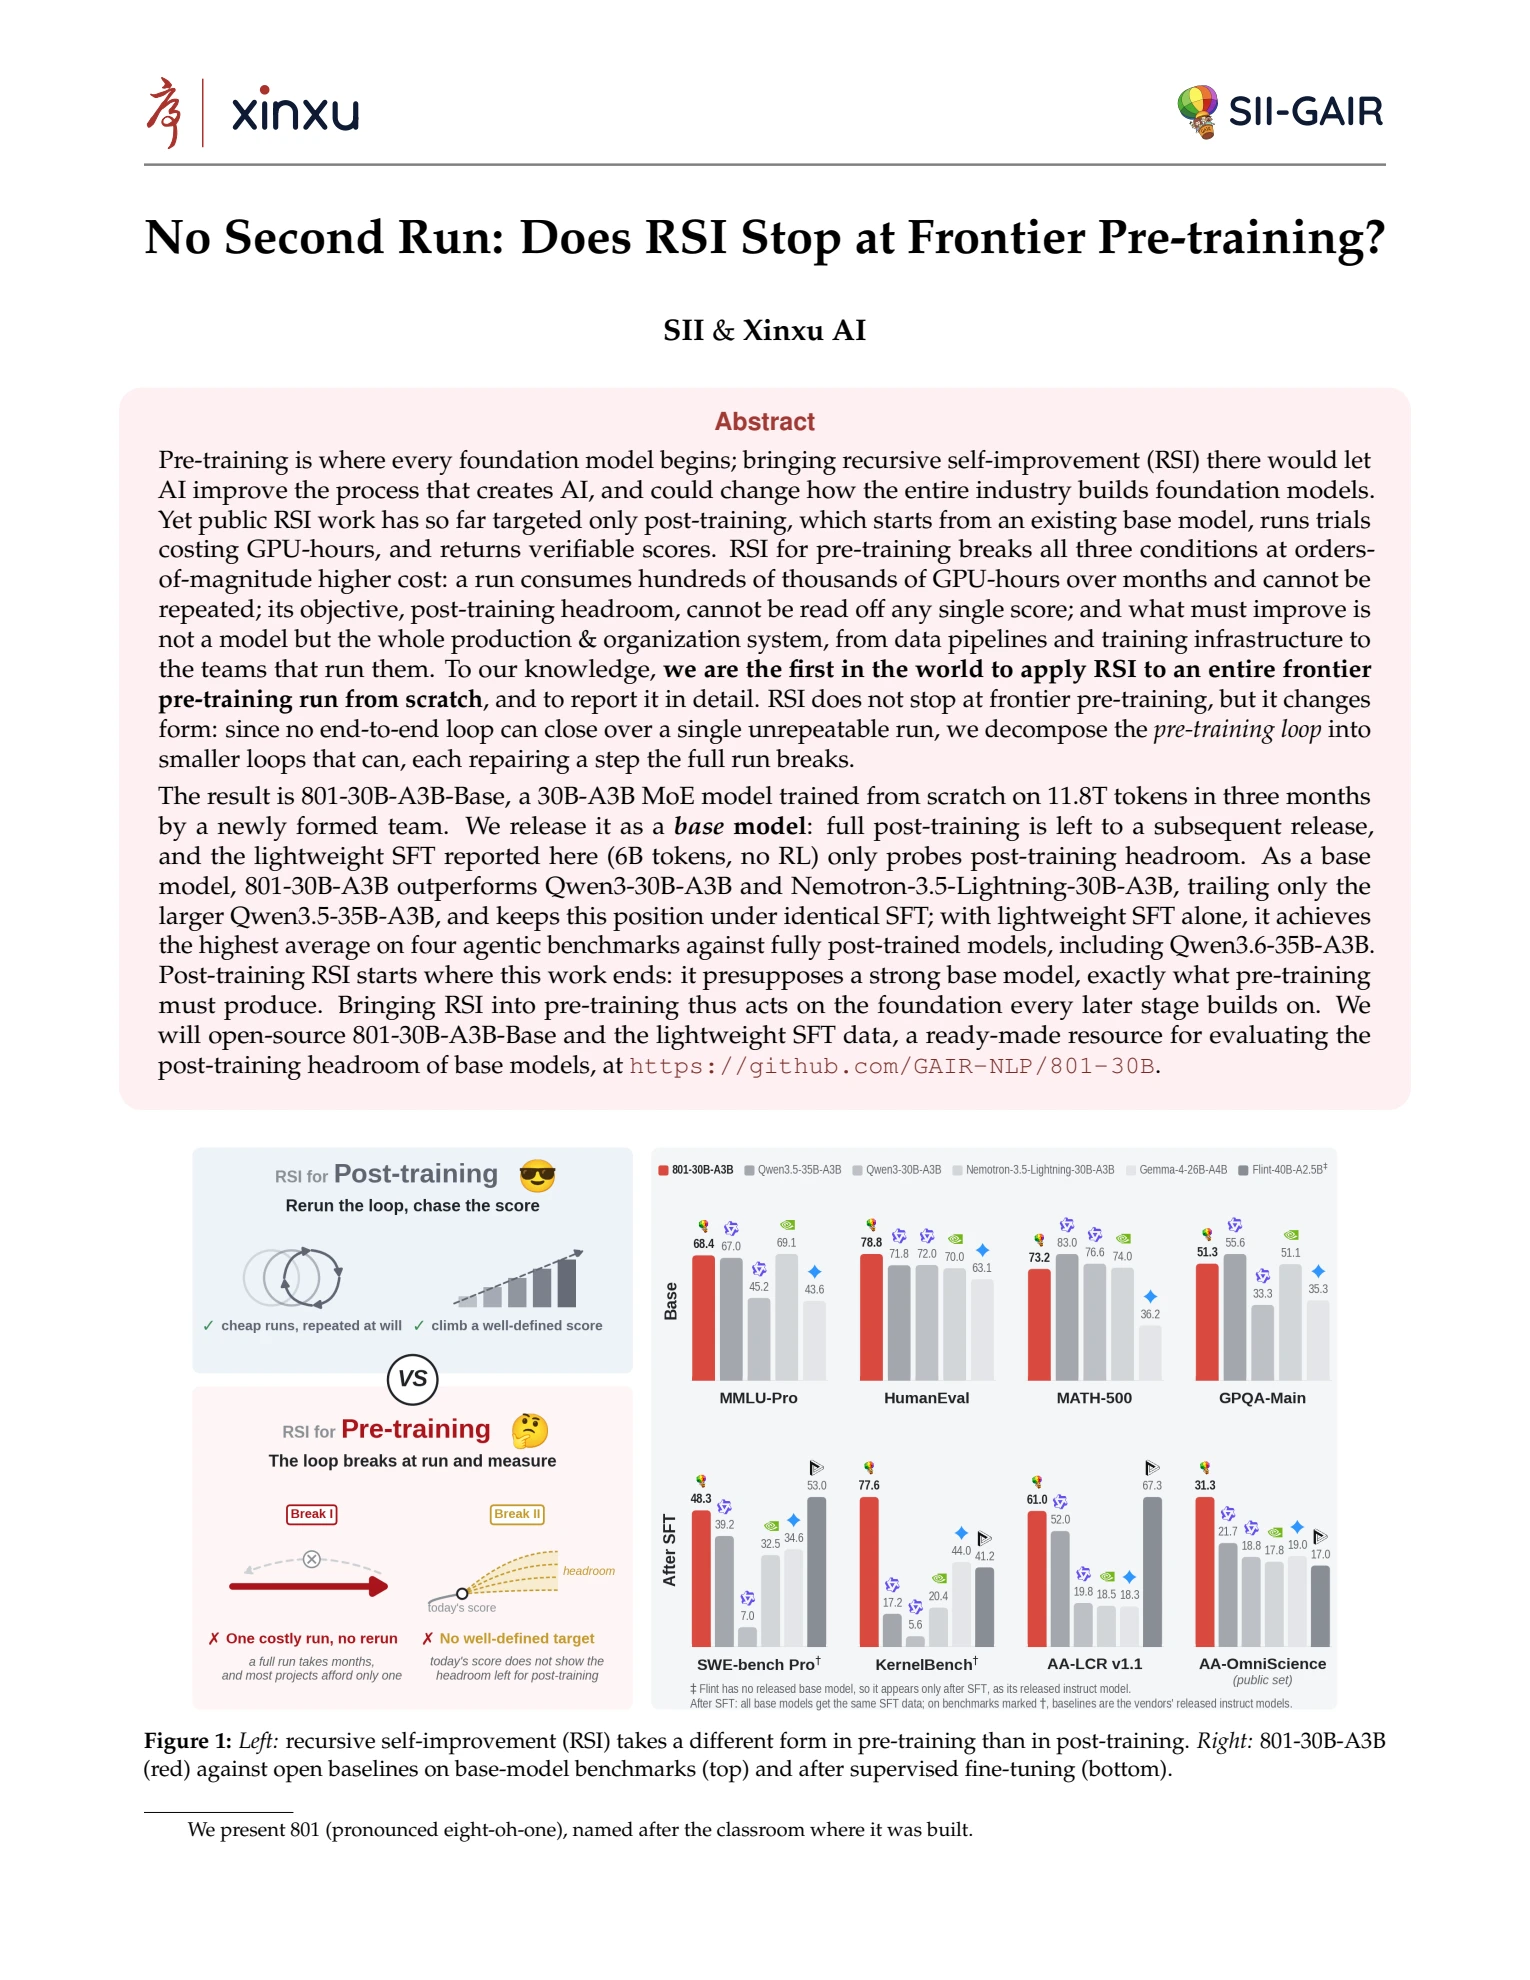
预训练是一切基础模型的起点;将递归自我改进(RSI)引入这一阶段,就能让 AI 改进创造 AI 本身的过程,并可能改变整个行业构建基础模型的方式。然而,公开的 RSI 研究迄今仅着眼于后训练:从已有基础模型出发,以 GPU 小时为单位开展试验,并得到可验证的分数。预训练中的 RSI 打破了这三个条件,成本还高出数个数量级:一次训练历时数月,消耗数十万 GPU 小时,无法重复;其目标是后训练潜力,不能从任何单一分数中读出;需要改进的也不是某个模型,而是涵盖数据流水线、训练基础设施及其运营团队的整套生产与组织系统。据我们所知,我们是全球首个将 RSI 应用于从零开始的完整前沿预训练过程、并详细报告这一实践的团队。RSI 并未止步于前沿预训练,而是改变了形式:既然一次不可重复的完整训练无法构成端到端闭环,我们就将预训练拆成能够闭合的较小循环,分别修复完整训练所破坏的循环环节。
成果是 801-30B-A3B-Base:一个新组建的团队用三个月,从零开始在 11.8T token 上训练出总参数 30B、激活参数 3B 的 MoE 模型。我们将其作为基础模型发布,完整后训练留待后续版本;本报告中的轻量 SFT(6B token,无 RL)仅用于探测后训练潜力。作为基础模型,801-30B-A3B 超过 Qwen3-30B-A3B 和 Nemotron-3.5-Lightning-30B-A3B,仅落后于更大的 Qwen3.5-35B-A3B;采用相同 SFT 后仍保持这一排名。仅经过轻量 SFT,它在四项智能体基准上的平均分就超过了所比较的完整后训练模型,包括 Qwen3.6-35B-A3B。
后训练 RSI 从本研究结束的地方起步:它预设已经存在一个强大的基础模型,而这恰恰是预训练必须产出的成果。因此,将 RSI 引入预训练,就是改进所有后续阶段赖以建立的根基。我们将开源 801-30B-A3B-Base 和轻量 SFT 数据;后者可直接用于评估基础模型的后训练潜力。地址:https://github.com/GAIR-NLP/801-30B。
图 1:左图展示 RSI 在预训练与后训练中的不同形式。右图将 801-30B-A3B(红色)与开放基线模型对比:上方为基础模型基准,下方为监督微调后的结果。
我们将模型命名为 801(读作 eight-oh-one),以纪念构建它的那间教室。
第 2 页|引言:预训练的特殊约束
中文译文 · 对应英文原报告第 2 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
1 引言
递归自我改进(RSI)指系统将自身经验和反馈转化为持久改变,从而增强自身能力。这一概念正迅速走向实践。智能体已经在神经网络架构(Xu 等,2026b)、GPU 内核(Yu 等,2026;Fu 等,2026a)、智能体运行框架(Xia 等,2026)以及最接近模型构建的后训练本身(NeoHorse Team 等,2026;Rank 等,2026;Huang 等,2026)上运行“提出→执行→测量→更新”的循环。这些循环涉及预训练时,采用的都是小规模代理:在小模型上验证数据整理和选择策略(Mi 等,2026;Xu 等,2026c;Meng 等,2026),或开展以分钟计的单 GPU 训练(Karpathy,2026;Guo 等,2026)。这些场景有三个共同条件:从已有基础模型或玩具规模模型出发,每次试验成本不超过若干 GPU 小时,并能得到可验证的分数。预训练是一切基础模型的起点,却不满足任何一个条件。将 RSI 引入其中,意味着让 AI 改进创造 AI 本身的过程;但据我们所知,尚无公开研究在完整的前沿预训练中尝试过这一点。
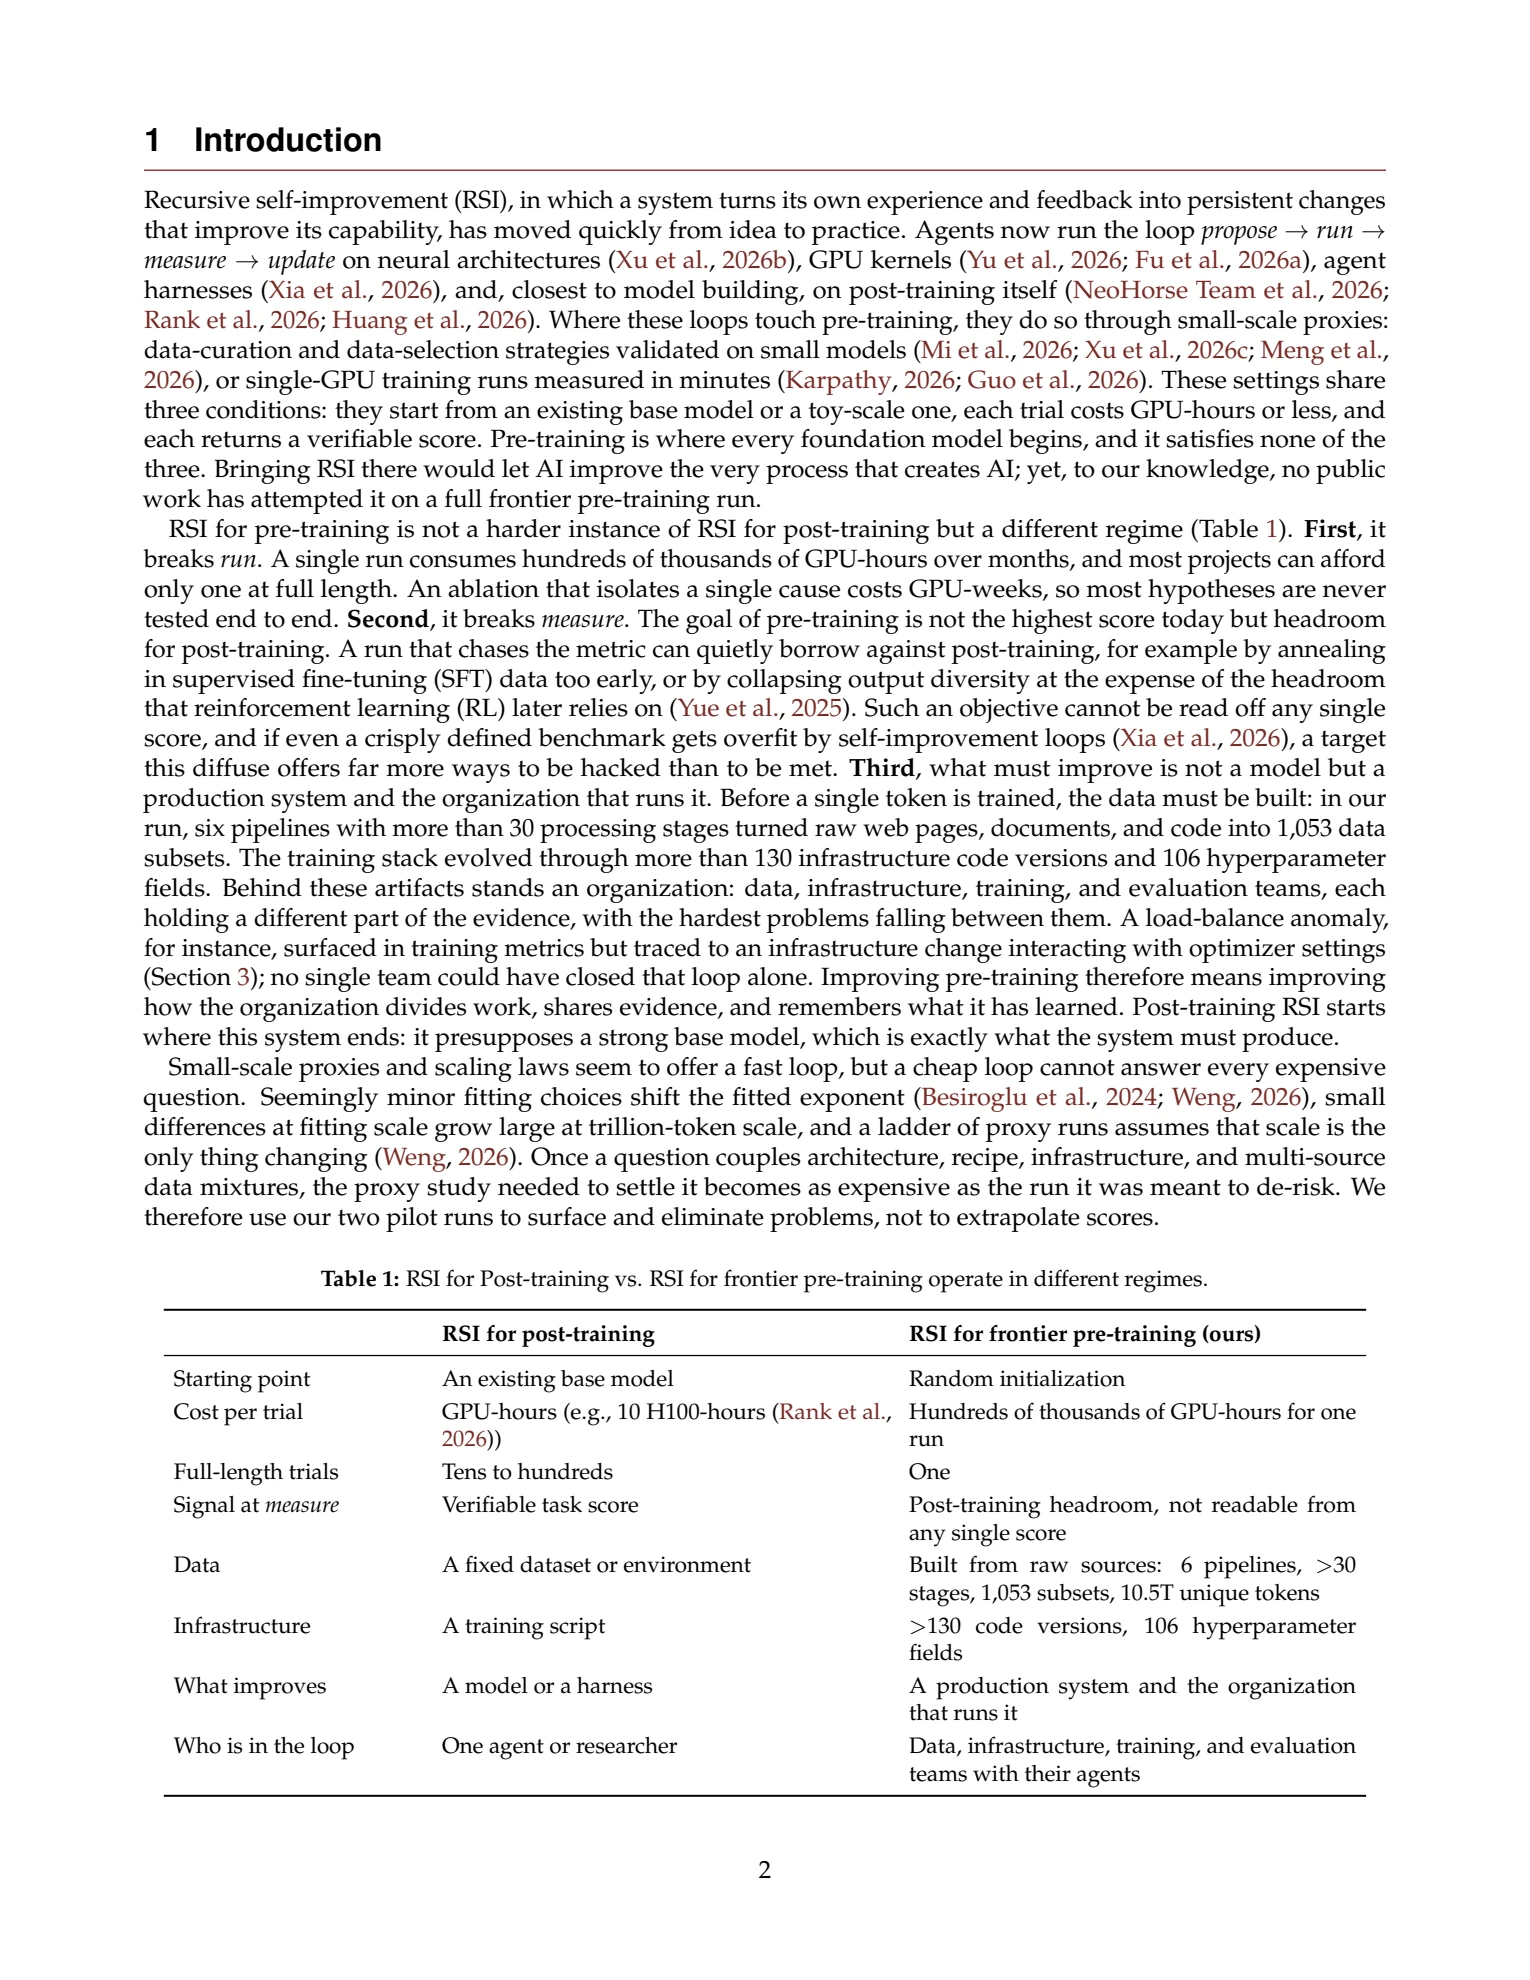
预训练 RSI 并非后训练 RSI 的更困难版本,而是另一种运行范式(表 1)。首先,它破坏了“执行”环节:一次训练历时数月,消耗数十万 GPU 小时,多数项目只负担得起一次完整训练。隔离单个原因的消融实验也需要数 GPU 周,因此大多数假设从未得到端到端验证。其次,它破坏了“测量”环节:预训练追求的不是今天最高的分数,而是后训练潜力。追逐指标可能悄悄透支这种潜力,例如过早用 SFT 数据退火,或牺牲 RL 所需的潜力来压缩输出多样性(Yue 等,2025)。这一目标无法由单一分数反映。即使定义明确的基准也会被自我改进循环过拟合(Xia 等,2026),如此分散的目标就更容易被钻空子,而非真正实现。
第三,需要改进的是生产系统及其运营组织,而非模型本身。训练第一个 token 之前,必须先构建数据:本项目用六条流水线、三十多个处理阶段,将网页、文档和代码转成 1,053 个数据子集。训练系统历经超过 130 个基础设施代码版本,包含 106 个超参数字段。背后还有数据、基础设施、训练和评估团队,各自掌握不同证据,最困难的问题往往落在团队交界处。例如,某个负载均衡异常表现在训练指标中,根源却是基础设施变更与优化器设置的相互作用(第 3 节);任何单一团队都无法独自闭合这一循环。因此,改进预训练也意味着改进组织分工、证据共享和经验记忆。后训练 RSI 从这个系统结束的地方开始:它依赖一个强大的基础模型,而这正是该系统的产物。
小规模代理和缩放定律看似提供了快速循环,但廉价循环无法回答所有昂贵的问题。细小的拟合选择会改变拟合指数(Besiroglu 等,2024;Weng,2026);拟合尺度上的微小差异会在万亿 token 规模放大;一组逐级扩大的代理训练还假设变化的只有规模(Weng,2026)。一旦问题耦合架构、配方、基础设施和多源数据混合,所需代理研究就可能与它试图降低风险的完整训练一样昂贵。因此,我们用两次试训暴露并排除问题,而不是外推分数。
表 1:后训练 RSI / 前沿预训练 RSI(本文)
起点:已有基础模型 / 随机初始化。
单次成本:GPU 小时(如 10 个 H100 小时)/ 数十万 GPU 小时。
完整试验次数:数十至数百 / 一次。
测量信号:可验证的任务分数 / 无法由单一分数读取的后训练潜力。
数据:固定数据集或环境 / 从原始来源构建,6 条流水线、超过 30 个阶段、1,053 个子集、10.5T 唯一 token。
基础设施:训练脚本 / 超过 130 个代码版本、106 个超参数字段。
改进对象:模型或运行框架 / 生产系统及其运营组织。
参与者:一名智能体或研究者 / 数据、基础设施、训练、评估团队及其智能体。
第 3 页|三类循环与研究贡献
中文译文 · 对应英文原报告第 3 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
如果端到端循环无法重跑,智能体的价值在哪里?训练留下海量上下文:内部指标、超参数变化、数据混合调整、基础设施差异,以及每个中间检查点的数十项评估,远超任何团队能够读完、更不用说记住的范围。这种范式下,典型浪费不是做了一个坏实验,而是因为没人将症状关联到其原因类别,又去调查数周前已经解决的问题。因此,瓶颈从算力转向组织记忆:尝试过什么、什么失败了及其原因、哪些信号同时出现。智能体的价值在于跨越人类无法读完的证据进行检索与归因;凡是能构建快速反馈信号的地方,它们还能直接开展工作,例如构建数据流水线组件、抓取网页、生成智能体训练数据,其覆盖广度远超人工团队。
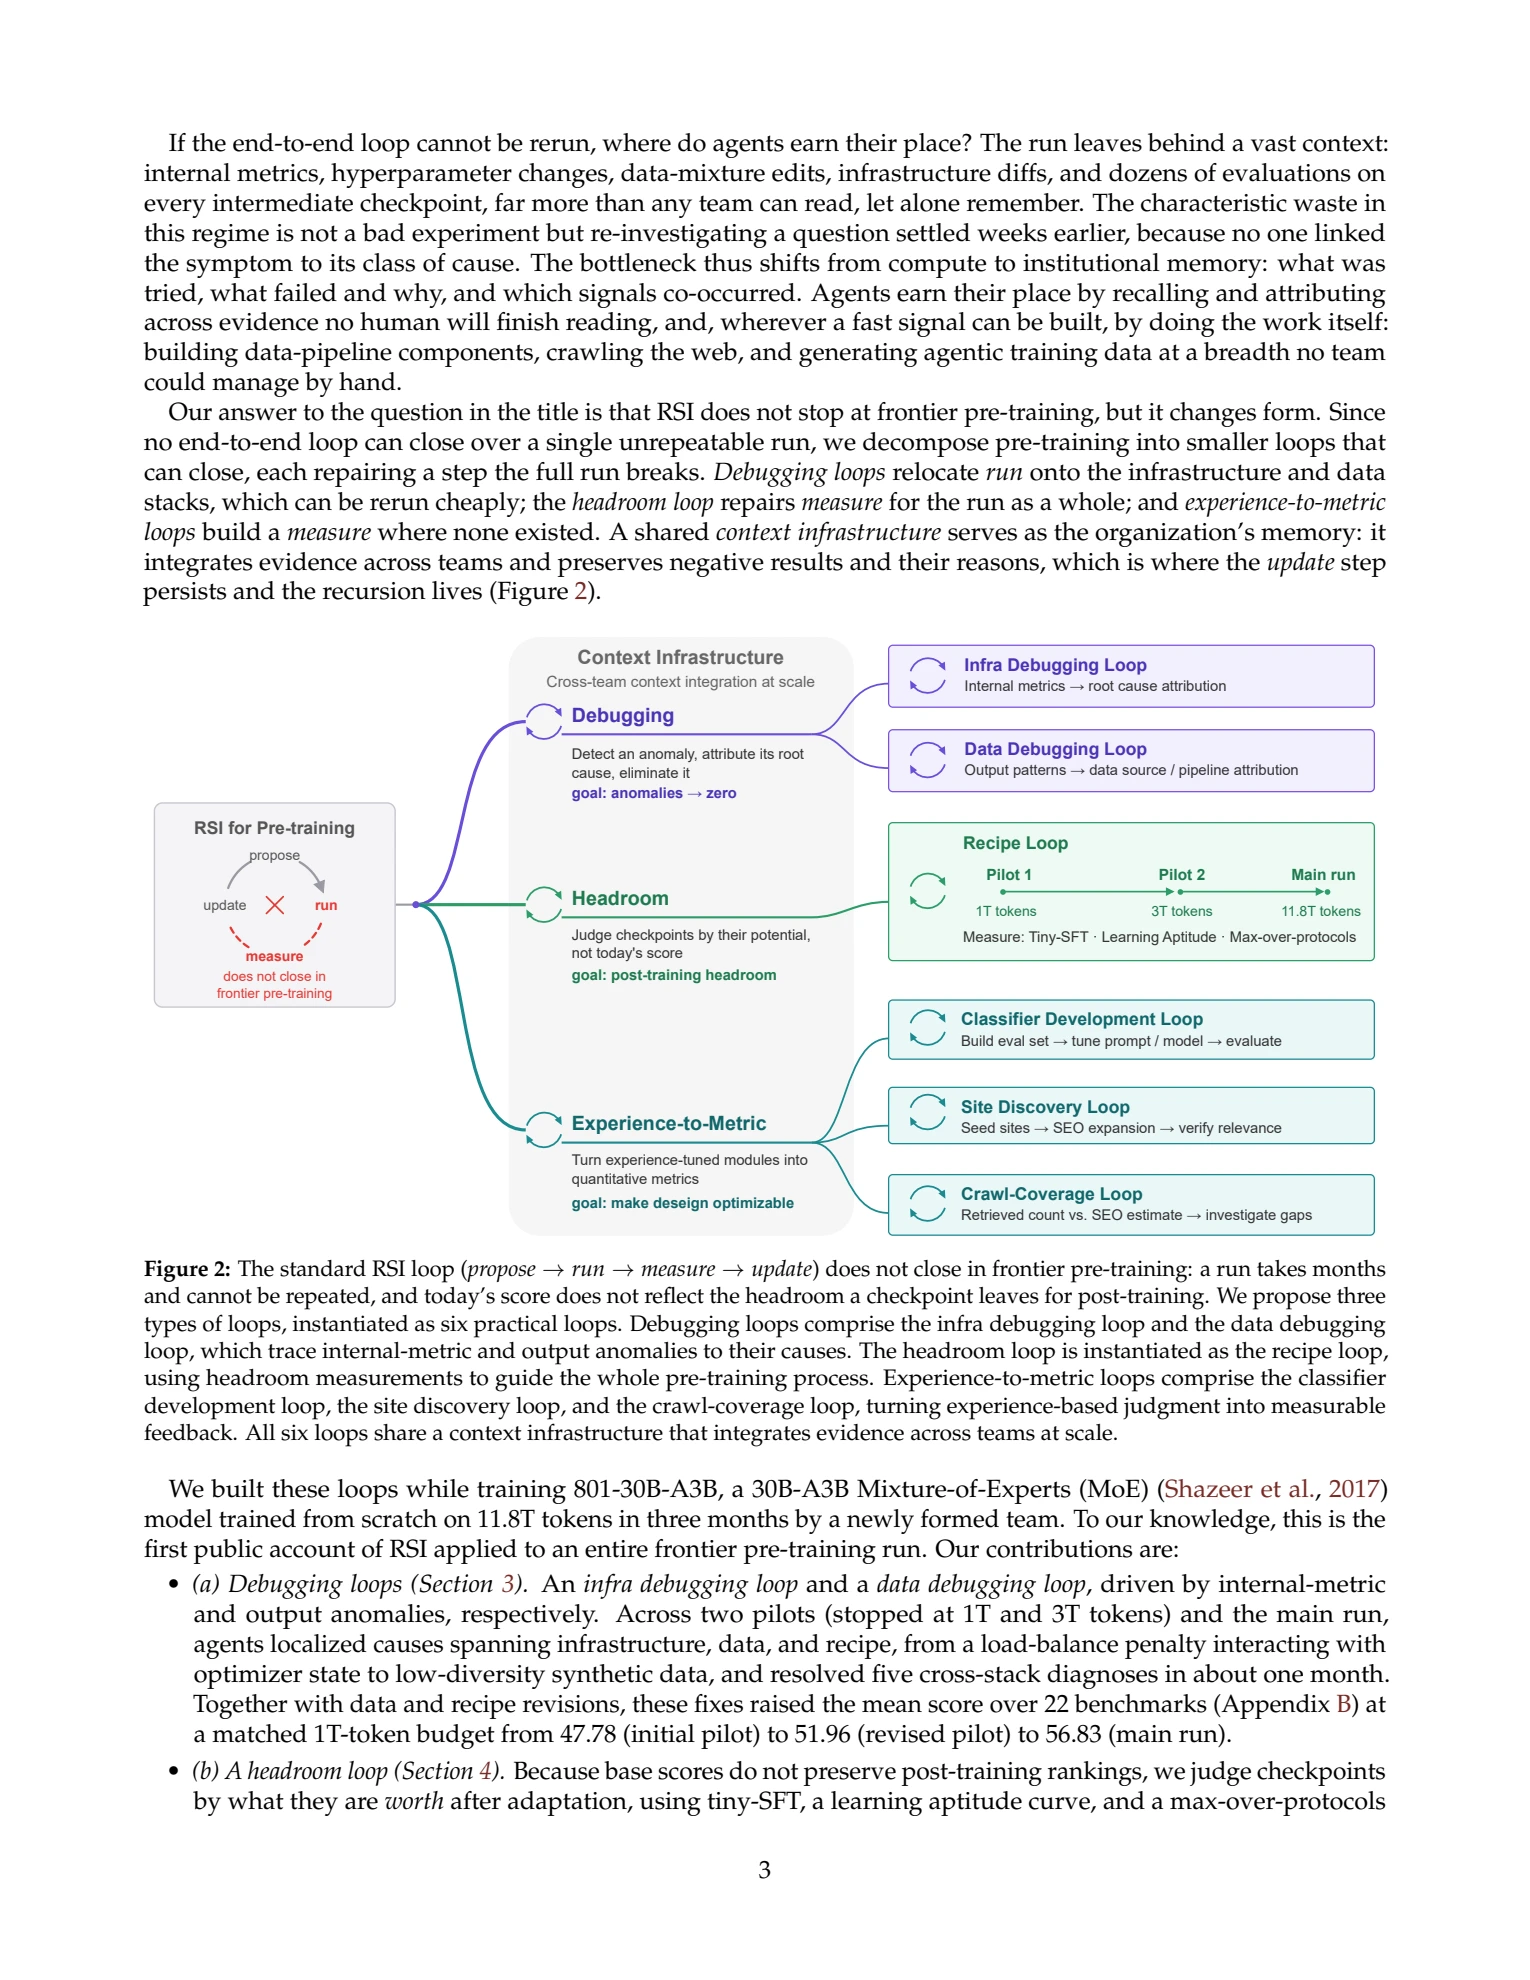
对标题问题,我们的回答是:RSI 并未止步于前沿预训练,而是改变了形式。一次不可重复的训练无法形成端到端闭环,于是我们将其拆成能闭合的较小循环,分别修复被完整训练破坏的环节。调试循环将“执行”转移到可廉价重跑的基础设施和数据系统;潜力循环修复整次训练的“测量”;经验量化循环则为原本没有测量信号的地方建立测量。共享上下文基础设施充当组织记忆,整合跨团队证据,保存负面结果及其原因;“更新”由此持久化,递归性也由此产生(图 2)。
图 2:标准 RSI 循环“提出→执行→测量→更新”无法在前沿预训练中闭合:训练历时数月且不可重复,当前分数又无法反映后训练潜力。本文提出三类循环,落实为六个实际循环,均共享可大规模整合跨团队证据的上下文基础设施。
调试类:基础设施调试循环,内部指标→根因归因;数据调试循环,输出模式→数据来源或流水线归因。目标是发现、归因和消除异常,使异常趋近于零。
潜力类:训练配方循环,以 1T token 试训、3T token 试训和 11.8T token 主训练为节点,通过 Tiny-SFT、学习能力及跨评估协议取最大值来衡量检查点,追求后训练潜力。
经验量化类:分类器开发循环(建评估集→调提示词或模型→评估);站点发现循环(种子站点→SEO 扩展→验证相关性);抓取覆盖循环(抓取数量与 SEO 估计比较→调查缺口)。目标是将经验判断变为定量反馈,使设计可优化。
我们在训练 801-30B-A3B 的过程中建立了这些循环。这个总参数 30B、激活参数 3B 的混合专家(MoE)模型(Shazeer 等,2017)由新团队在三个月内从零开始训练,使用 11.8T token。据我们所知,这是首份将 RSI 应用于整个前沿预训练过程的公开报告。贡献如下:
(a) 调试循环(第 3 节)。分别由内部指标异常和输出异常驱动的基础设施与数据调试循环。在两次分别止于 1T、3T token 的试训及主训练中,智能体定位了跨基础设施、数据和配方的根因,包括负载均衡惩罚与优化器状态的相互作用、低多样性合成数据等,约一个月完成五项跨系统诊断。结合数据和配方修订,相同 1T token 预算下,22 项基准(附录 B)的平均分由 47.78 提升至 51.96,再提升至 56.83。
(b) 潜力循环(第 4 节)。基础模型分数无法保持后训练后的排名,因此我们按适应后的价值判断检查点,使用 Tiny-SFT、学习能力曲线和跨协议最大值来估计能力上限。这些测量能区分基础评估的表面停滞与适应后仍在持续的提升。
第 4 页|RSI 的操作性定义
中文译文 · 对应英文原报告第 4 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
(c) 经验量化循环(第 5 节)。在分类器开发、站点发现、抓取覆盖三个循环中,智能体将凭经验做出的判断转化为有记录、可定量评估的工作流。我们以这种方式从零构建了六条数据流水线。
(d) 预训练规模的智能体数据(第 6 节)。智能体从训练成果的使用者变成训练数据的生产者:22 万个可执行拉取请求在九种运行框架中展开,产生超过 100B token 的已验证智能体轨迹;智能体 token 总量为 134B,用于预训练的长上下文阶段。
发布内容与比较方式。我们发布基础模型 801-30B-A3B-Base。完整后训练留待后续版本;此处轻量 SFT(6B token、无 RL)仅探测后训练潜力。因此第 8 节按从最公平到最不利于我们的顺序开展三层比较:(1) 基础模型对基础模型:本模型超过 Qwen3-30B-A3B(Yang 等,2025a)和 Nemotron-3.5-Lightning-30B-A3B(NVIDIA 等,2026),仅落后于更大的 Qwen3.5-35B-A3B(Qwen Team,2026a)。(2) 相同 SFT:所有基础模型在同一 SFT 数据上微调后,排名保持不变。(3) 轻量 SFT 对完整后训练:即便如此,本模型仍在四项智能体基准上获得最高平均分,比较对象包括 Qwen3.6-35B-A3B(Qwen Team,2026b)。第三层用数十亿 SFT token 对比厂商完整后训练流程,只用于展示潜力,不是同条件比较。基础模型与轻量 SFT 数据将在 https://github.com/GAIR-NLP/801-30B 开源。
2 让 RSI 适应前沿预训练
RSI 的核心是将系统自身经验与反馈转化为提升能力的持久改变;最强形式还包括改进“改进过程”本身。其引擎是 AlphaEvolve(Novikov 等,2025)和 ASI-Evolve(Xu 等,2026c)所展示的闭环。本文以“提出→执行→测量→更新”为 RSI 的操作性定义。改进的系统是由智能体、研究者和基础设施组成的预训练项目本身,而不是正在训练的模型。
四个步骤须精确定义。“提出”生成候选改动或假设,对应生成—批评—修订方案中的生成器(Madaan 等,2023),以及提出者—求解者自博弈中的提出者(Zhao 等,2025)。“执行”通过训练、轨迹展开或代码运行实现候选项并产生证据。“测量”依据替代人类判断或期望目标的信号评分。Chen 等(2026)将信号按验证强度排序:从最强的形式验证器到最弱的模型内在自评。“更新”将结果纳入持久改变,保留高分方案、丢弃其余方案;在递归情形中,还会修改产生改动的循环机制。正是这种持久性使其成为递归循环,而非一次性搜索。
循环能否带来改进取决于两个前提。其一,迭代廉价且可重复,只有“执行”和“更新”能够多次循环,收益才会累积。其二,“测量”有与真实目标一致的可靠信号。缺少外部信号就没有可靠改进;信号薄弱或错位则会导致自我强化的错误、模型及多样性坍缩(Shumailov 等,2024),或锁定在定义清晰但方向错误的目标上(Chen 等,2026)。
前沿预训练打破这两个前提:完整训练无法重复,后训练潜力这一真实目标又过于分散,难以可靠测量。此外,须改进的是组织而非模型。标准端到端循环因而不能直接移植。我们保留循环,但改变其闭合位置。
三类循环。我们围绕预训练建立三类较小循环,共六个具体实例(图 2),而非将预训练视为一个分数驱动的大循环。表 2 展示其四步骤。
调试循环将“执行”迁移到基础设施和数据流水线,便于廉价复验诊断。它由异常驱动,而非追求分数最大化:“测量”判断异常是否消失,并将每个被排除的原因记为负面结果。基础设施调试追溯内部指标异常到代码或配方;数据调试追溯输出异常到具体来源或处理阶段(第 3 节)。
潜力循环修复整次训练的“测量”:用 Tiny-SFT、学习能力与跨协议最大值估计后训练潜力,而非直接读取基础模型分数。
第 5 页|循环步骤与上下文基础设施
中文译文 · 对应英文原报告第 5 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
表 2:各类循环如何落实 RSI 的四个步骤
调试循环:提出可疑原因(代码版本、配置或数据子集);在基础设施或数据系统上执行廉价、可重复的定向诊断;测量异常是否消失;应用修复并记录排除的原因。
潜力循环:提出配方改动或是否继续训练的判断;执行试训及主训练检查点评估,成本高且不可重复;用 Tiny-SFT、学习能力、跨协议最大值测量;更新配方并判断训练进展。
经验量化循环:提出新提示词、模型或爬虫版本;执行廉价的组件级评估;用任务专属评估集、SEO 页面数估计等测量;部署方案或继续迭代。
调试及经验量化循环在廉价组件上快速闭合;潜力循环的“执行”是预训练本身,因此每个项目只能闭合少数几次。
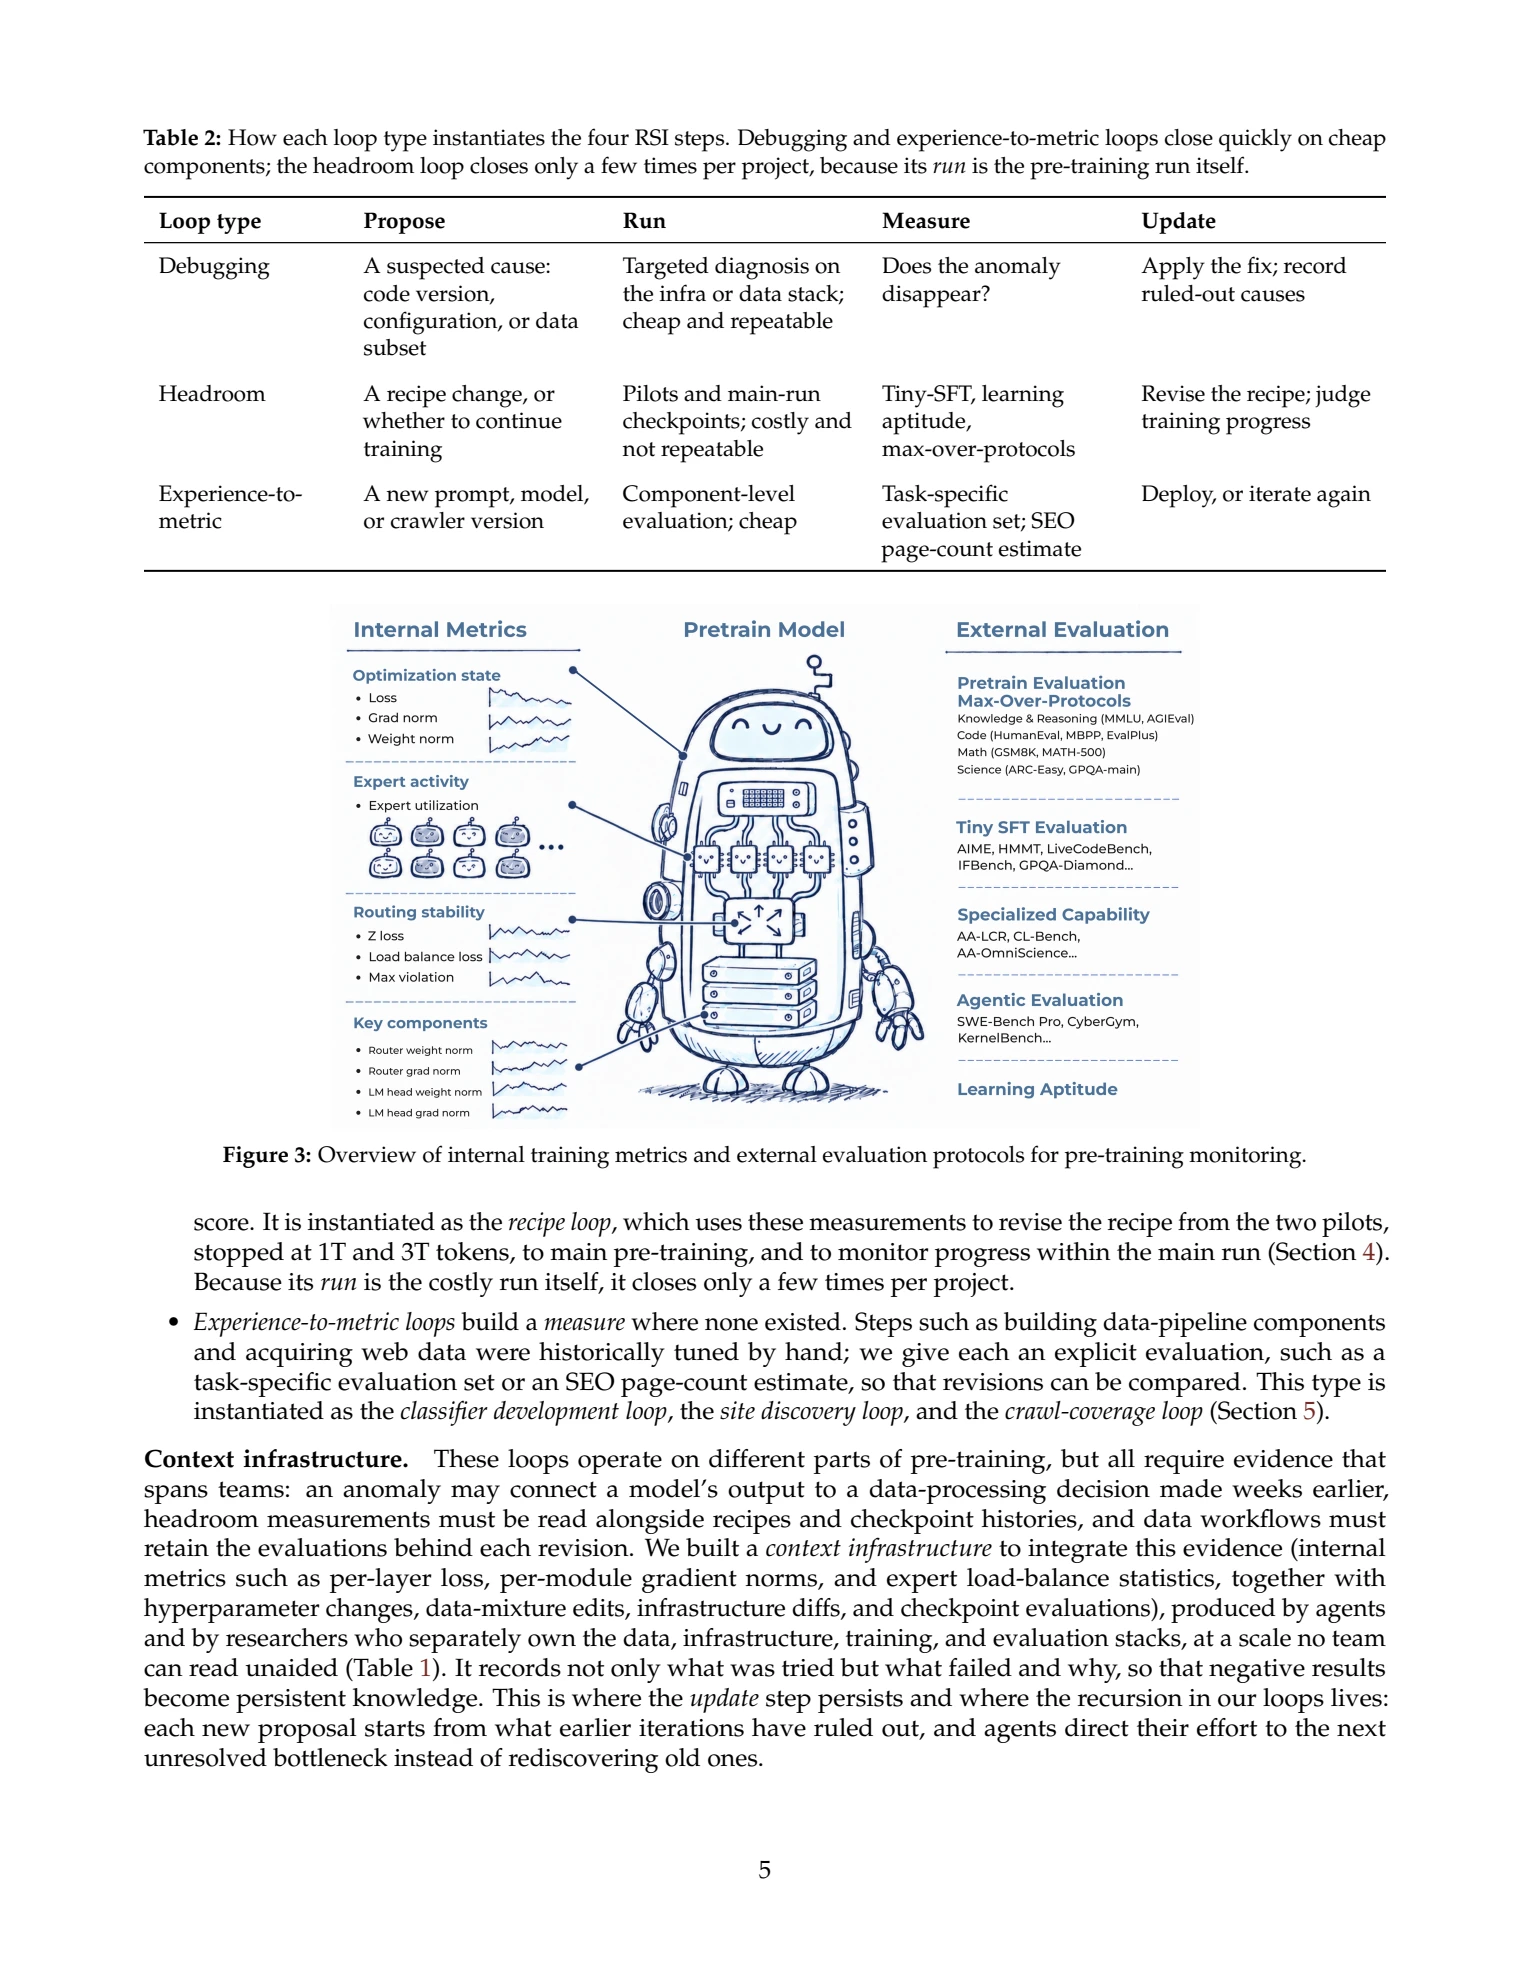
图 3:用于预训练监控的内部训练指标和外部评估协议概览。内部指标包括:优化状态(损失、梯度范数、权重范数)、专家活动(专家利用率)、路由稳定性(z-loss、负载均衡损失、最大违背值)和关键组件(路由器权重/梯度范数、语言模型输出头权重/梯度范数)。外部评估包括跨协议最大值预训练评估、Tiny-SFT 评估、专项能力评估、智能体评估和学习能力。
潜力循环的具体形式是配方循环:使用这些测量,从分别止于 1T 和 3T token 的两次试训逐步修订到主预训练配方,并监测主训练内部的进展(第 4 节)。由于“执行”就是昂贵的训练本身,每个项目只能闭合数次。
经验量化循环为原本缺乏测量的环节建立“测量”。数据流水线组件构建与网页数据获取等步骤过去依靠人工调节;我们为其配置明确评估,例如任务专属评估集或 SEO 页面数估计,使每次修订能够相互比较。具体包括分类器开发、站点发现和抓取覆盖循环(第 5 节)。
上下文基础设施。这些循环作用于预训练的不同部分,但都需要跨团队证据。一个异常可能将模型输出与数周前的数据处理决策关联起来;潜力测量必须结合配方和检查点历史解读;数据工作流则须保存每次修订背后的评估。
为此,我们建立上下文基础设施,整合智能体以及分别负责数据、基础设施、训练、评估系统的研究者产生的证据,包括逐层损失、逐模块梯度范数、专家负载均衡统计等内部指标,以及超参数变化、数据混合调整、基础设施差异和检查点评估。证据规模之大,任何团队都无法独自读完(表 1)。系统不仅记录试过什么,也记录失败项及其原因,使负面结果成为持久知识。
“更新”在这里得以持久化,循环的递归性也在这里体现:每个新提案从此前已排除的可能性出发,智能体将精力投向下一个尚未解决的瓶颈,避免反复发现旧问题。
第 6 页|试训迭代与调试循环
中文译文 · 对应英文原报告第 6 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
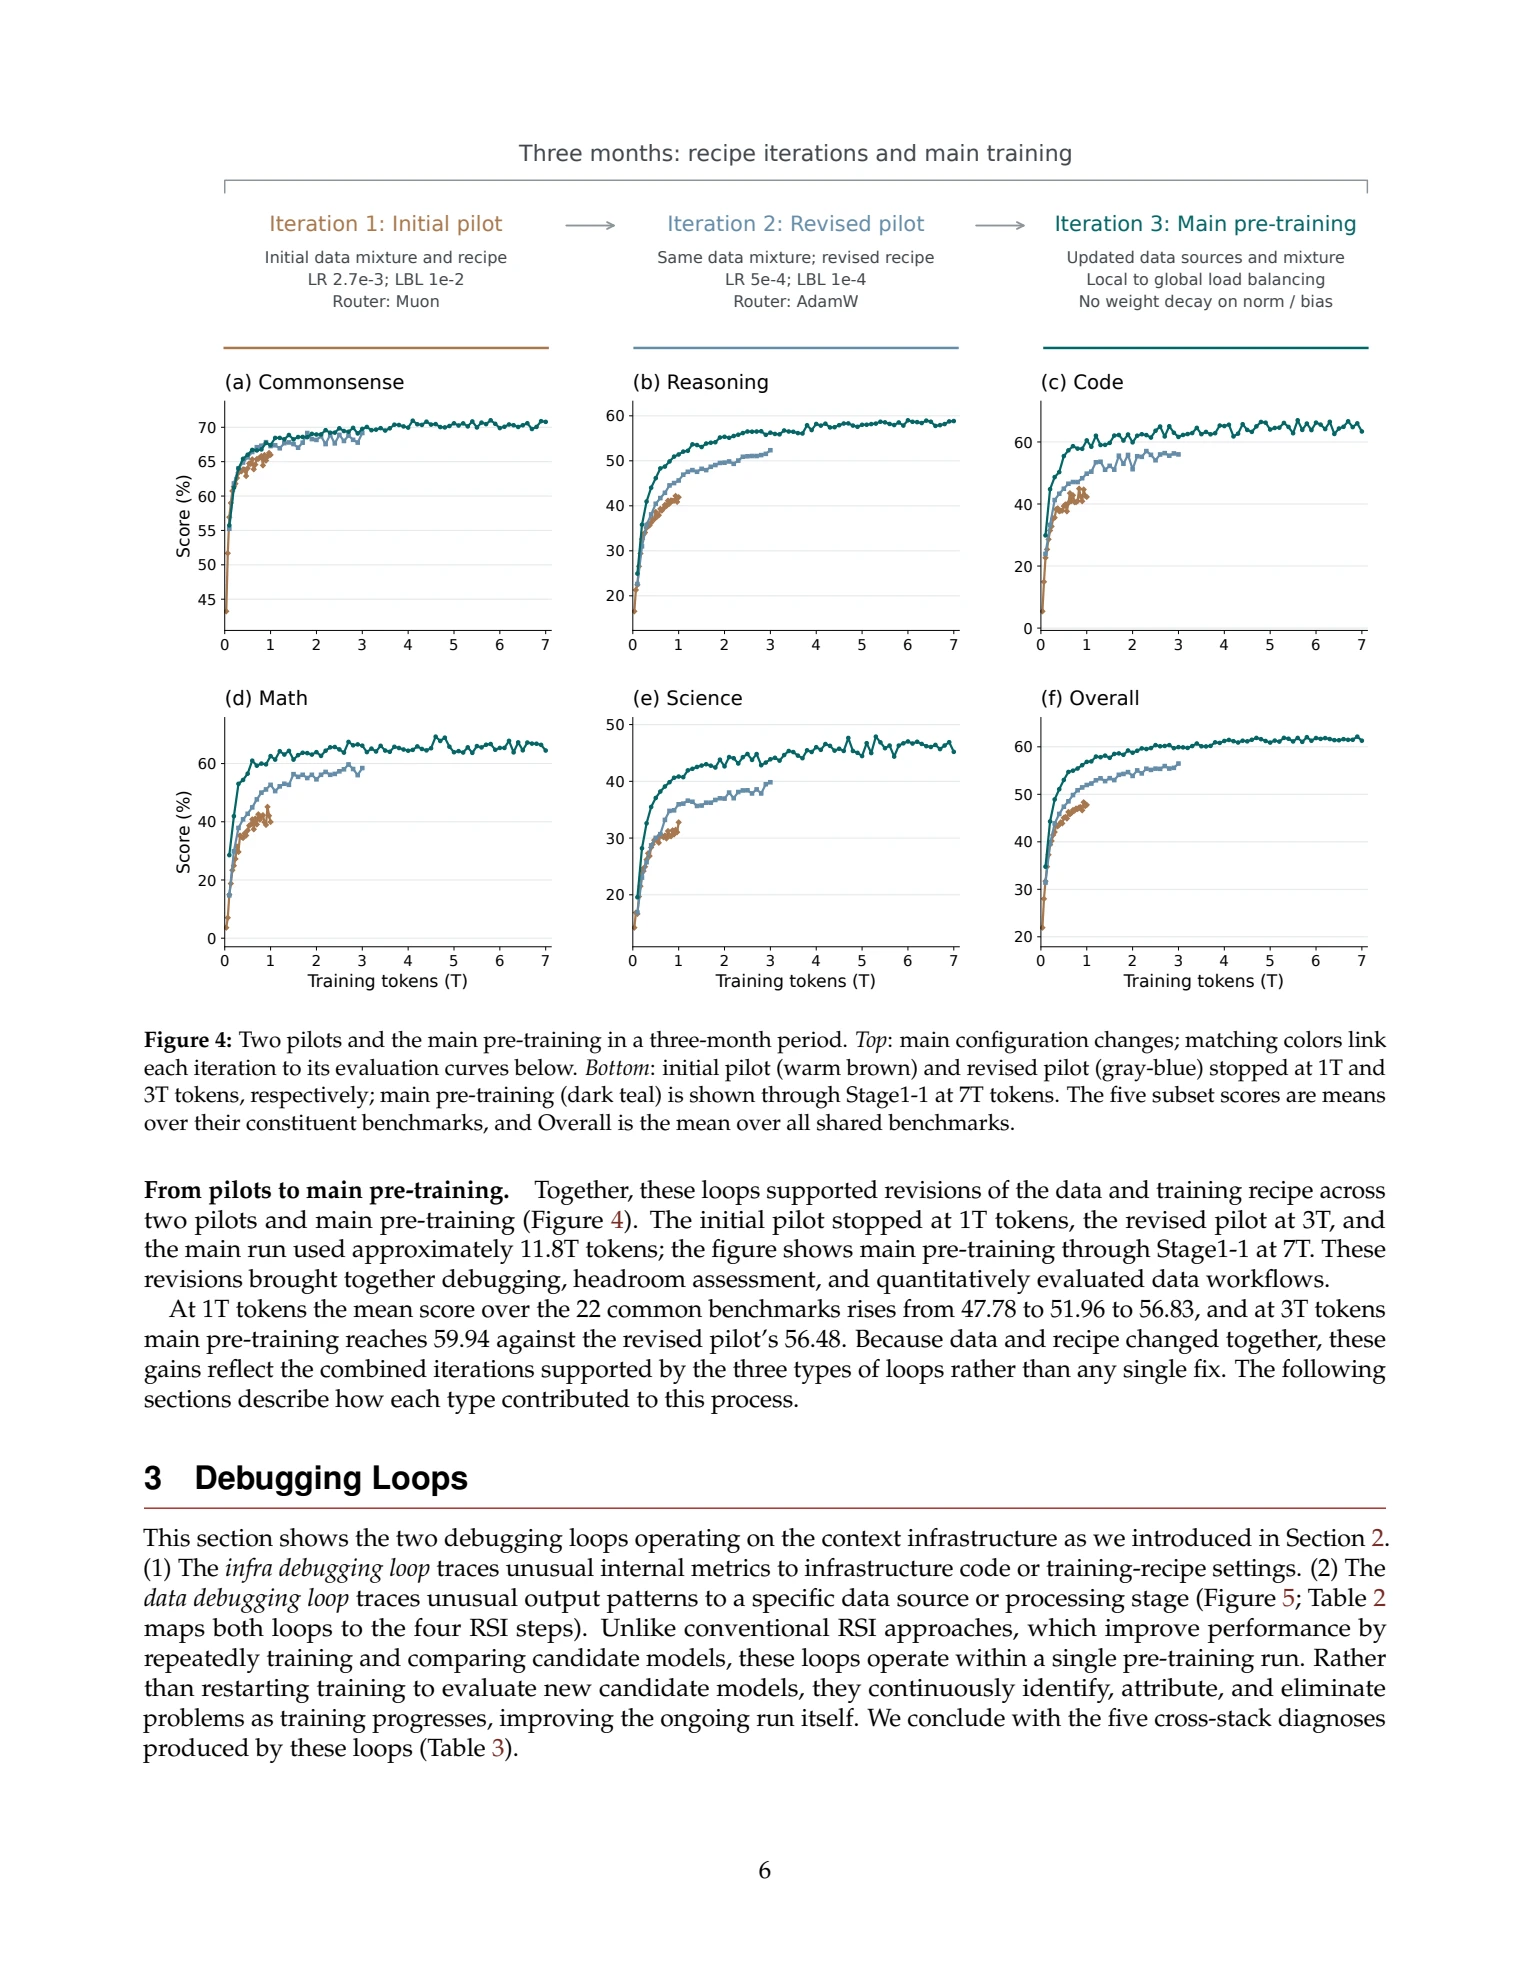
图 4:三个月内的两次试训与主预训练。
上方列出关键配置变化,颜色与下方评估曲线对应。
迭代 1,初始试训:初始数据混合与配方;学习率 2.7e-3,负载均衡损失系数 1e-2;路由器使用 Muon。
迭代 2,修订试训:数据混合不变、配方修订;学习率 5e-4,负载均衡损失系数 1e-4;路由器改用 AdamW。
迭代 3,主预训练:更新数据来源和混合;从局部负载均衡改为全局负载均衡;归一化参数与偏置不施加权重衰减。
下方:初始试训(暖棕)和修订试训(灰蓝)分别止于 1T、3T token;主预训练(深青)显示到 Stage1-1 结束,即 7T token。五类子分数分别是常识、推理、代码、数学、科学类内部基准的平均值;Overall 是全部共享基准的平均值。横轴为训练 token 数(T),纵轴为分数(%)。
从试训到主预训练。这些循环共同支撑了两次试训和主训练中的数据与配方修订(图 4)。初始试训在 1T token 停止,修订试训在 3T 停止,主训练使用约 11.8T token;图中仅展示主训练的 Stage1-1,直到 7T。这些修订结合了调试、潜力评估和定量评估的数据工作流。
在 1T token 时,22 项共有基准的平均分依次由 47.78 升至 51.96、56.83;在 3T 时,主训练达到 59.94,而修订试训为 56.48。由于数据和配方同时变化,这些收益反映三类循环支持的综合迭代,而不能归因于某一个修复。后续各节将说明每类循环如何发挥作用。
3 调试循环
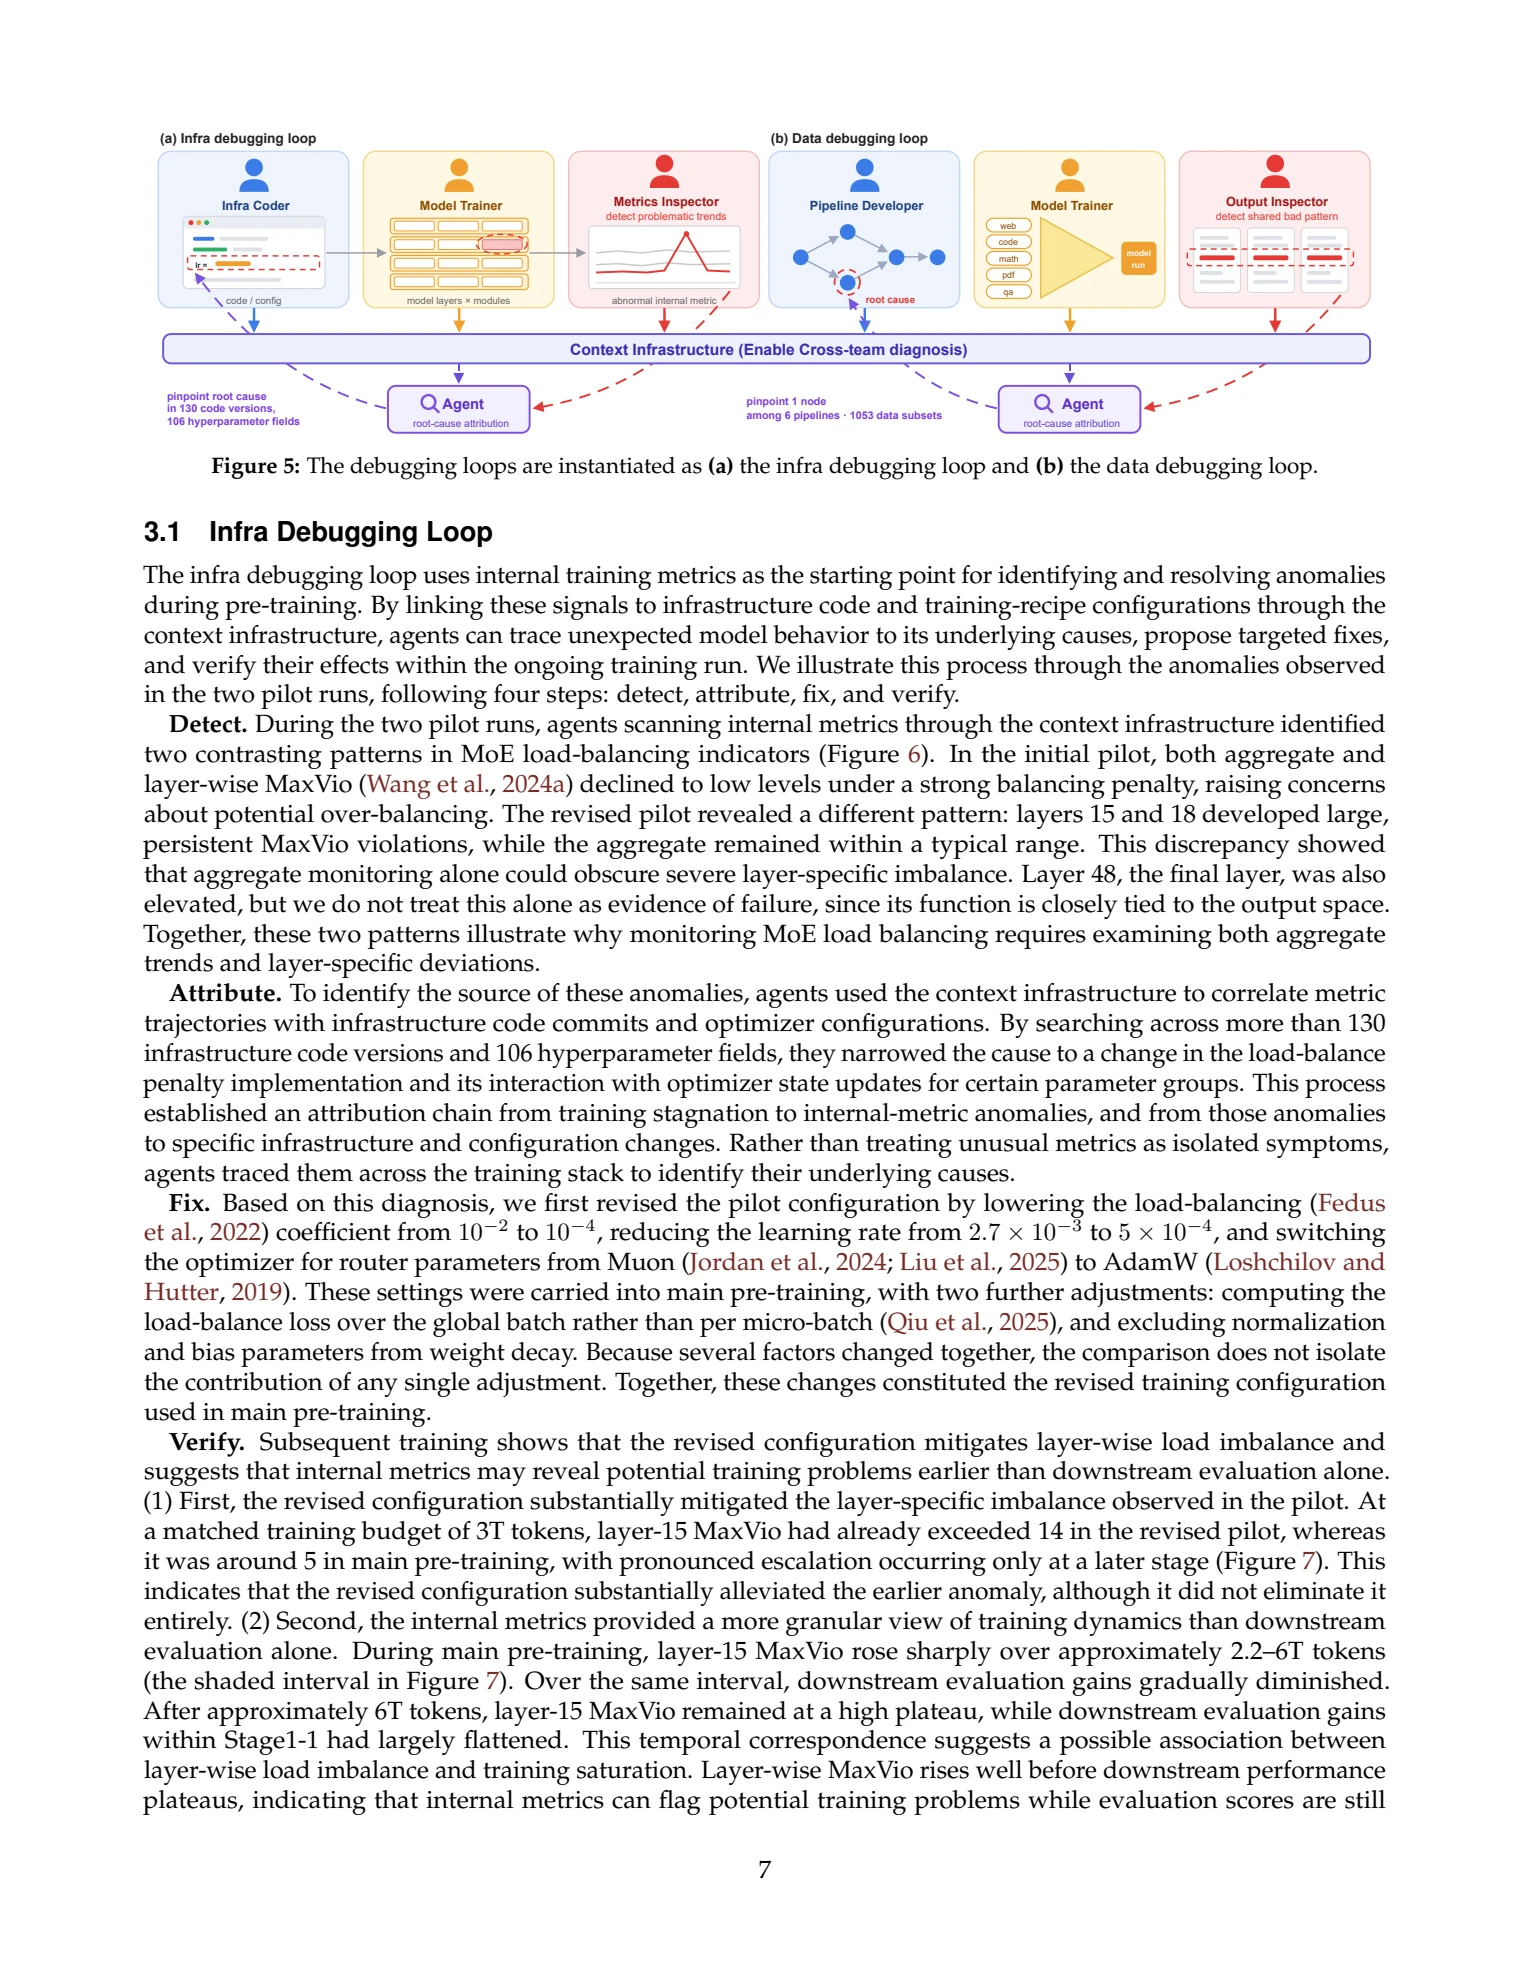
本节展示第 2 节所述的上下文基础设施之上运行的两个调试循环:(1) 基础设施调试循环,将异常内部指标追溯至基础设施代码或训练配方设置;(2) 数据调试循环,将异常输出模式追溯至具体数据来源或处理阶段(图 5;四个 RSI 步骤的映射见表 2)。
传统 RSI 方法通过反复训练、比较候选模型来提高性能,而这些循环在单次预训练内部运作。它们不通过重启训练来评估新模型,而是随着训练推进,持续识别、归因、消除问题,改进当前训练本身。最后我们总结由这些循环完成的五项跨系统诊断(表 3)。
第 7 页|基础设施调试
中文译文 · 对应英文原报告第 7 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
图 5:调试循环的两个实例。(a) 基础设施调试:基础设施编码者、模型训练者和指标检查者协同,发现问题趋势,通过智能体在超过 130 个代码版本、106 个超参数字段中定位根因。(b) 数据调试:流水线开发者、模型训练者和输出检查者协同,发现共同坏模式,通过智能体在 6 条流水线、1,053 个数据子集中定位节点。共享上下文基础设施支持跨团队诊断。
3.1 基础设施调试循环
以训练内部指标为起点,识别并解决预训练中的异常。上下文基础设施将这些信号与代码、配方配置连接,智能体据此追溯异常行为根因、提出定向修复,并在持续训练中验证效果。下面以两次试训的异常说明“发现、归因、修复、验证”四步。
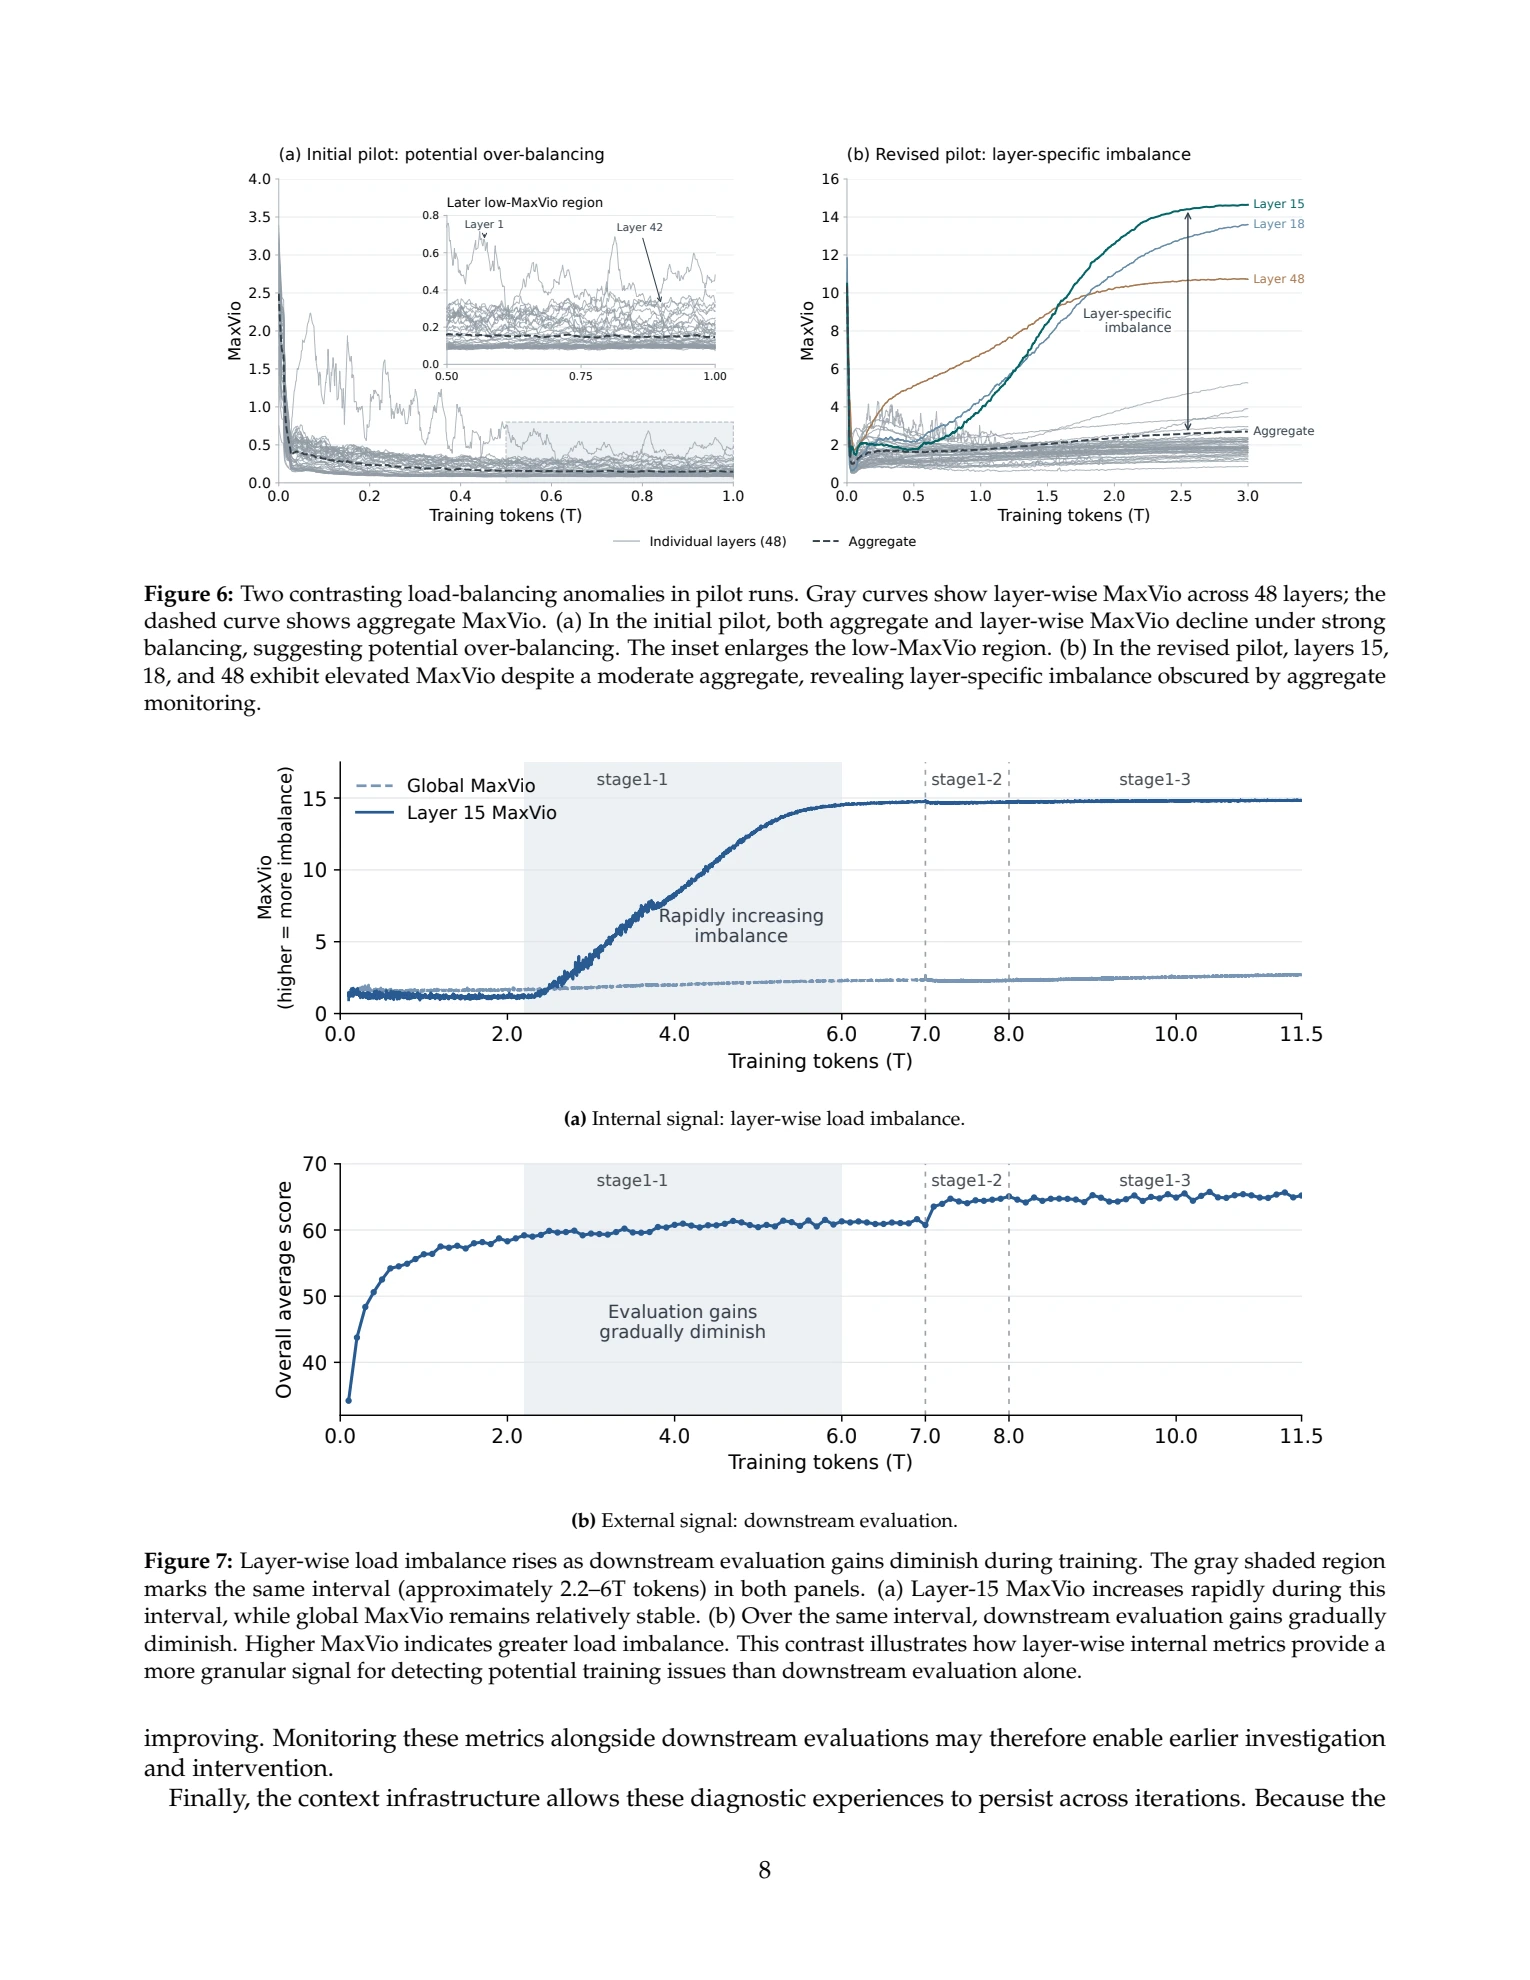
发现。智能体扫描内部指标时,发现两种相反的 MoE 负载均衡模式(图 6)。初始试训中,在强均衡惩罚下,整体和逐层 MaxVio(Wang 等,2024a)均降到较低水平,提示可能均衡过度。修订试训则出现另一种模式:第 15、18 层持续存在较大的 MaxVio 违背,而整体仍在正常范围。单看整体指标会掩盖严重的局部层失衡。最后一层(第 48 层)也偏高,但其功能与输出空间密切相关,不能仅凭这一点认定故障。两种模式说明:监控 MoE 负载均衡须同时关注整体趋势与逐层偏差。
归因。智能体借助上下文基础设施,将指标轨迹与代码提交、优化器配置关联,在超过 130 个代码版本和 106 个超参数字段中搜索,最终将根因缩小到负载均衡惩罚实现的某次变化,以及它与特定参数组优化器状态更新的相互作用。归因链由训练停滞连接到内部指标异常,再连接到具体基础设施和配置变化。智能体没有把指标异常当作孤立症状,而是跨训练系统追踪其根因。
修复。根据诊断,我们先将负载均衡(Fedus 等,2022)系数从 10^-2 降至 10^-4,将学习率从 2.7×10^-3 降至 5×10^-4,并将路由器参数优化器从 Muon(Jordan 等,2024;Liu 等,2025)改为 AdamW(Loshchilov 和 Hutter,2019)。主训练沿用这些设置,另加两项改动:按全局批次而非每个微批次计算负载均衡损失(Qiu 等,2025);归一化与偏置参数不做权重衰减。由于多个因素共同变化,比较无法隔离任何单项改动的贡献。这些变化一起构成主预训练采用的修订配置。
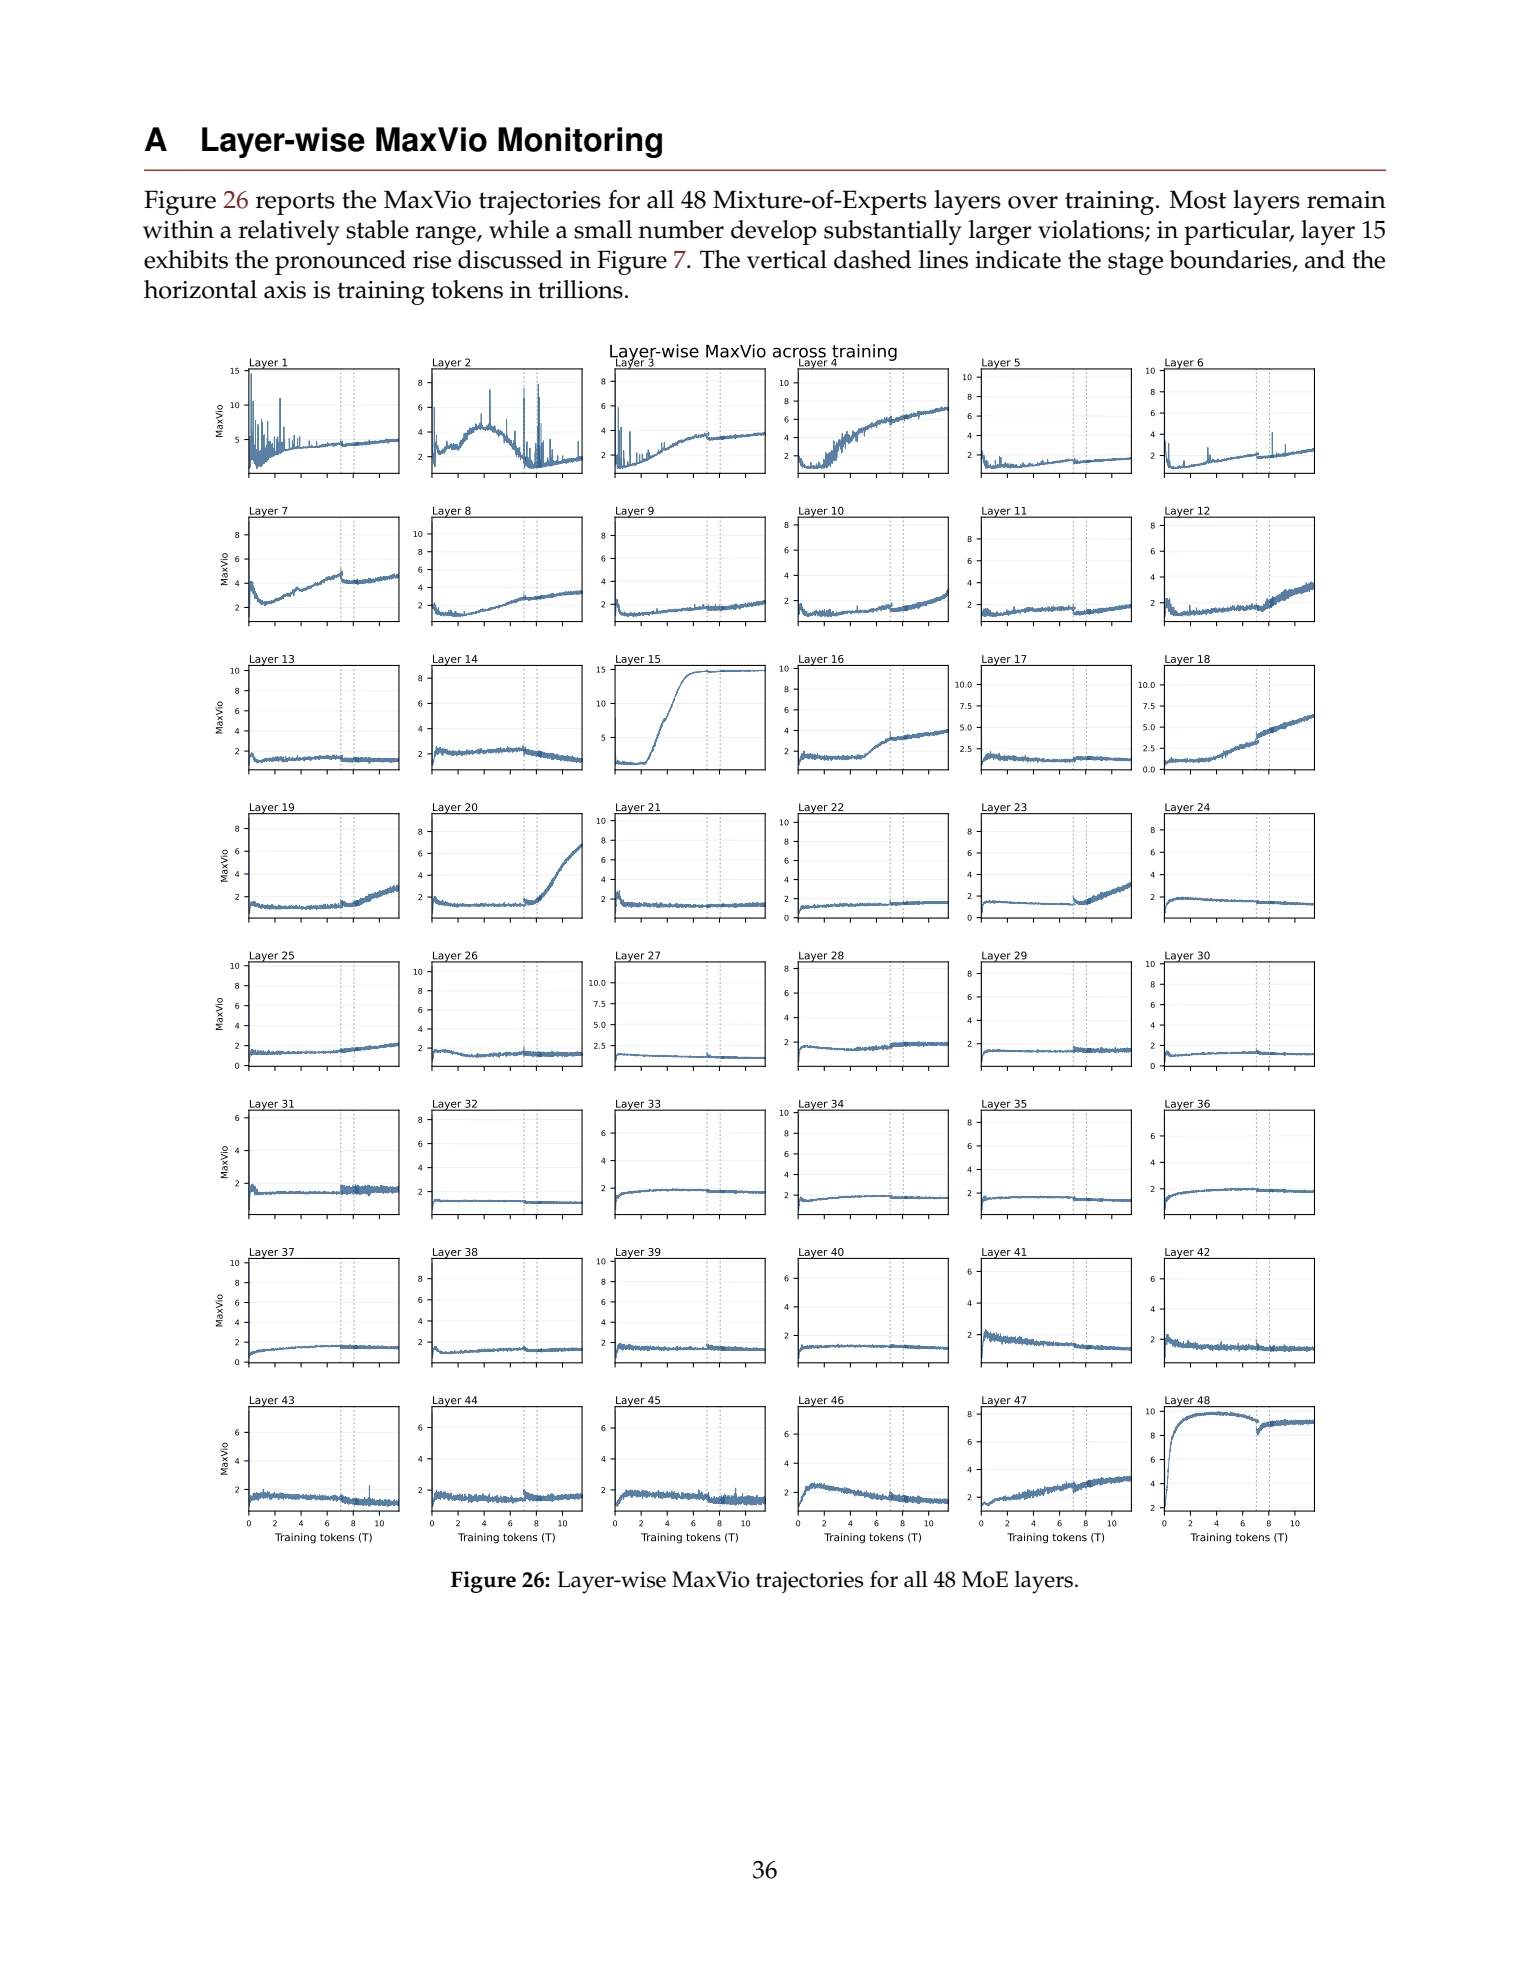
验证。后续训练显示,修订配置缓解了逐层失衡,也提示内部指标可能比下游评估更早揭示潜在问题。(1) 在相同 3T token 预算下,修订试训第 15 层 MaxVio 已超过 14,而主训练约为 5,明显恶化只在后续阶段出现(图 7)。修订大幅缓解了早期异常,但并未完全消除。(2) 内部指标比单独的下游评估更细致:主训练约 2.2T—6T token 期间,第 15 层 MaxVio 急剧上升(图 7 阴影),同期下游评估收益逐渐缩小;约 6T 后,该指标保持高位,而 Stage1-1 内下游收益基本趋平。
这种时间对应提示逐层负载失衡与训练饱和可能相关。逐层 MaxVio 在下游表现进入平台期之前就已上升,因此评估分数还在提高时,内部指标就可能提示潜在问题。
第 8 页|负载失衡与下游评估
中文译文 · 对应英文原报告第 8 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
图 6:试训中两种相反的负载均衡异常。灰线为 48 层各自的 MaxVio,虚线为整体 MaxVio。(a) 初始试训在强均衡约束下,整体与逐层 MaxVio 都下降,提示可能均衡过度;插图放大后期低 MaxVio 区域。(b) 修订试训中,第 15、18、48 层 MaxVio 偏高,而整体值适中,说明整体监控掩盖了层级失衡。横轴为训练 token 数(T)。
图 7:随着训练推进,逐层负载失衡上升,下游评估收益递减。两幅图的灰色阴影对应同一时段,约 2.2T—6T token。(a) 内部信号:第 15 层 MaxVio 快速增加,而全局 MaxVio 相对稳定。(b) 外部信号:同期下游评估收益逐渐减少。MaxVio 越大表示负载越不均衡。这一对比说明,与单独使用下游评估相比,逐层内部指标能为发现潜在训练问题提供更细致的信号。图中还标出了 Stage1-1、Stage1-2 和 Stage1-3。
(接上页)在评估分数仍在提高时,将这些内部指标与下游评估一同监测,可能支持更早调查和干预。
最后,上下文基础设施使这些诊断经验跨迭代保留下来。由于此前的诊断及支持证据都已保存,相似异常再次出现时就可以预先判断,而无须重新从头发现。这样,我们便能依据早期 MaxVio 信号进一步调查,而不是等到下游评估收益趋平之后才行动。
第 9 页|数据调试流程
中文译文 · 对应英文原报告第 9 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
3.2 数据调试循环
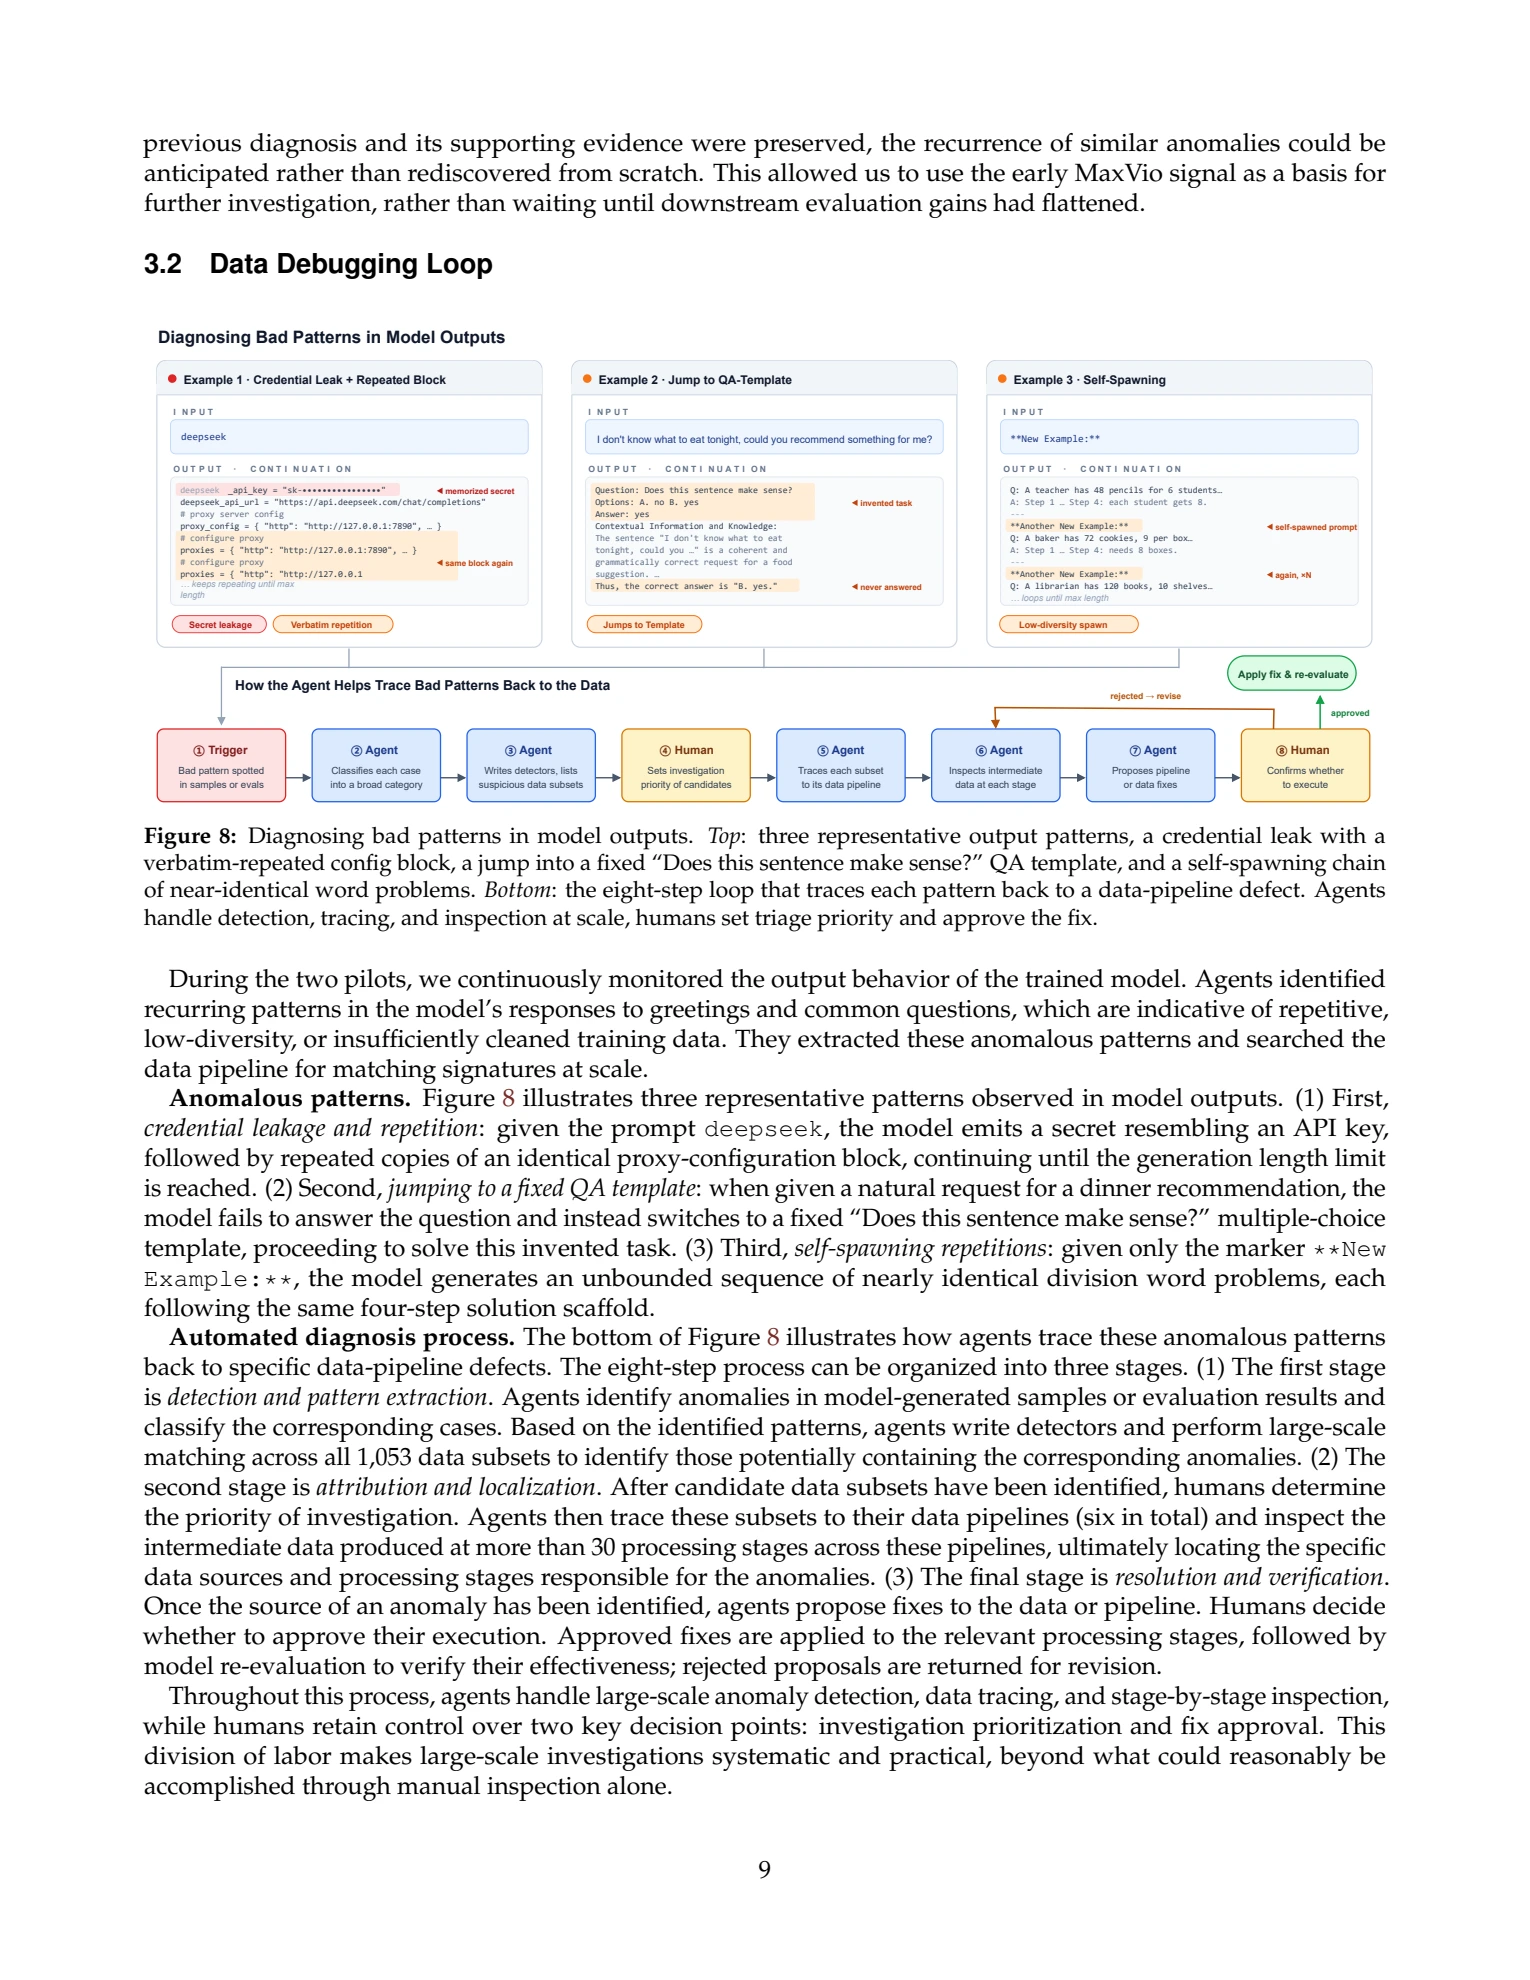
图 8:诊断模型输出中的坏模式。上方三个典型案例:凭据泄露并逐字重复配置块;跳入固定的“这句话有意义吗?”问答模板;自发接续近乎相同的应用题。下方为将输出模式追溯到数据流水线缺陷的八步循环。智能体负责规模化检测、追踪和检查;人类决定调查优先级并批准修复。
例 1:输入 deepseek,输出看似 API 密钥的秘密值,随后不断重复相同代理配置,直到长度上限。例 2:输入“我不知道今晚吃什么,能推荐一下吗?”,模型却虚构“这句话有意义吗?A. 否 B. 是”的任务,分析该句并回答“B. 是”,始终没有回答原请求。例 3:仅输入 **New Example:**,模型就依次生成教师分铅笔、面包师装饼干、图书管理员分配图书等除法题,均沿用相同四步解答,反复自行生成 **Another New Example:**,直到长度上限。
两次试训期间,我们持续监测模型输出行为。智能体从问候语和常见问题的回答中发现重复模式,它们提示训练数据存在重复、多样性不足或清洗不充分。智能体提取异常模式,并在数据流水线中规模化搜索匹配特征。
异常模式。(1) 凭据泄露与重复:提示 deepseek 导致模型输出类似 API 密钥的秘密信息,并重复相同代理配置块直至长度上限。(2) 跳入固定问答模板:自然的晚餐推荐请求被替换成“这句话有意义吗?”的固定选择题,模型转而解决虚构任务。(3) 自发重复:只给出 **New Example:** 标记,模型就生成无界、近乎相同的除法应用题序列,每题均使用同一四步解题框架。
自动诊断流程。图 8 下方的八步过程可分为三阶段。
第一阶段:检测与模式提取。智能体从生成样本或评估结果中识别异常、分类案例,再编写检测器,在全部 1,053 个数据子集中进行大规模匹配,找出可能包含对应异常的子集。
第二阶段:归因与定位。人类确定候选子集的调查优先级。智能体将其追溯到六条数据流水线,并逐一检查三十多个处理阶段的中间数据,最终定位引发异常的具体来源和处理步骤。
第三阶段:解决与验证。智能体提出数据或流水线修复方案,由人类决定是否批准。批准后在相关阶段应用修复,再重新评估模型验证效果;未获批准的方案退回修订。
八步对应为:①发现样本或评估中的坏模式;②智能体分类;③编写检测器并列出可疑子集;④人类确定调查优先级;⑤追溯子集对应流水线;⑥检查各阶段中间数据;⑦提出修复;⑧人类确认是否执行。
整个过程由智能体承担大规模异常检测、数据追踪和逐阶段检查,人类保留调查排序与修复批准这两个关键决策点。这种分工使人工检查难以完成的大规模调查变得系统而可行。
第 10 页|跨系统诊断与数据加载
中文译文 · 对应英文原报告第 10 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
根因归因与修复。三个异常被追溯到三种不同的数据流水线缺陷。
(1) 凭据泄露与重复来自代码语料中清洗不充分的配置文件,敏感信息和重复配置进入训练数据,随后出现在模型生成内容中。我们修复相关处理步骤,移除这些未充分清洗的内容。
(2) 固定问答模板来自某开源 QA 语料子集,其合成数据过滤不足,包含大量“这句话有意义吗?”问题。我们加强该阶段的合成数据过滤,减少固定模板样本。
(3) 自发接续重复来自一条提示词缺乏多样性的合成数据流水线,生成样本高度相似。我们修改提示设计,提高合成数据多样性。三个案例均修改了对应流水线阶段,并在修复后重评模型以验证效果。
3.3 累积诊断
上述两类循环说明,智能体如何发现模型行为异常,并将其追溯至基础设施、训练配方和数据流水线问题。这些只是整个训练期间持续诊断与解决问题工作的代表案例。
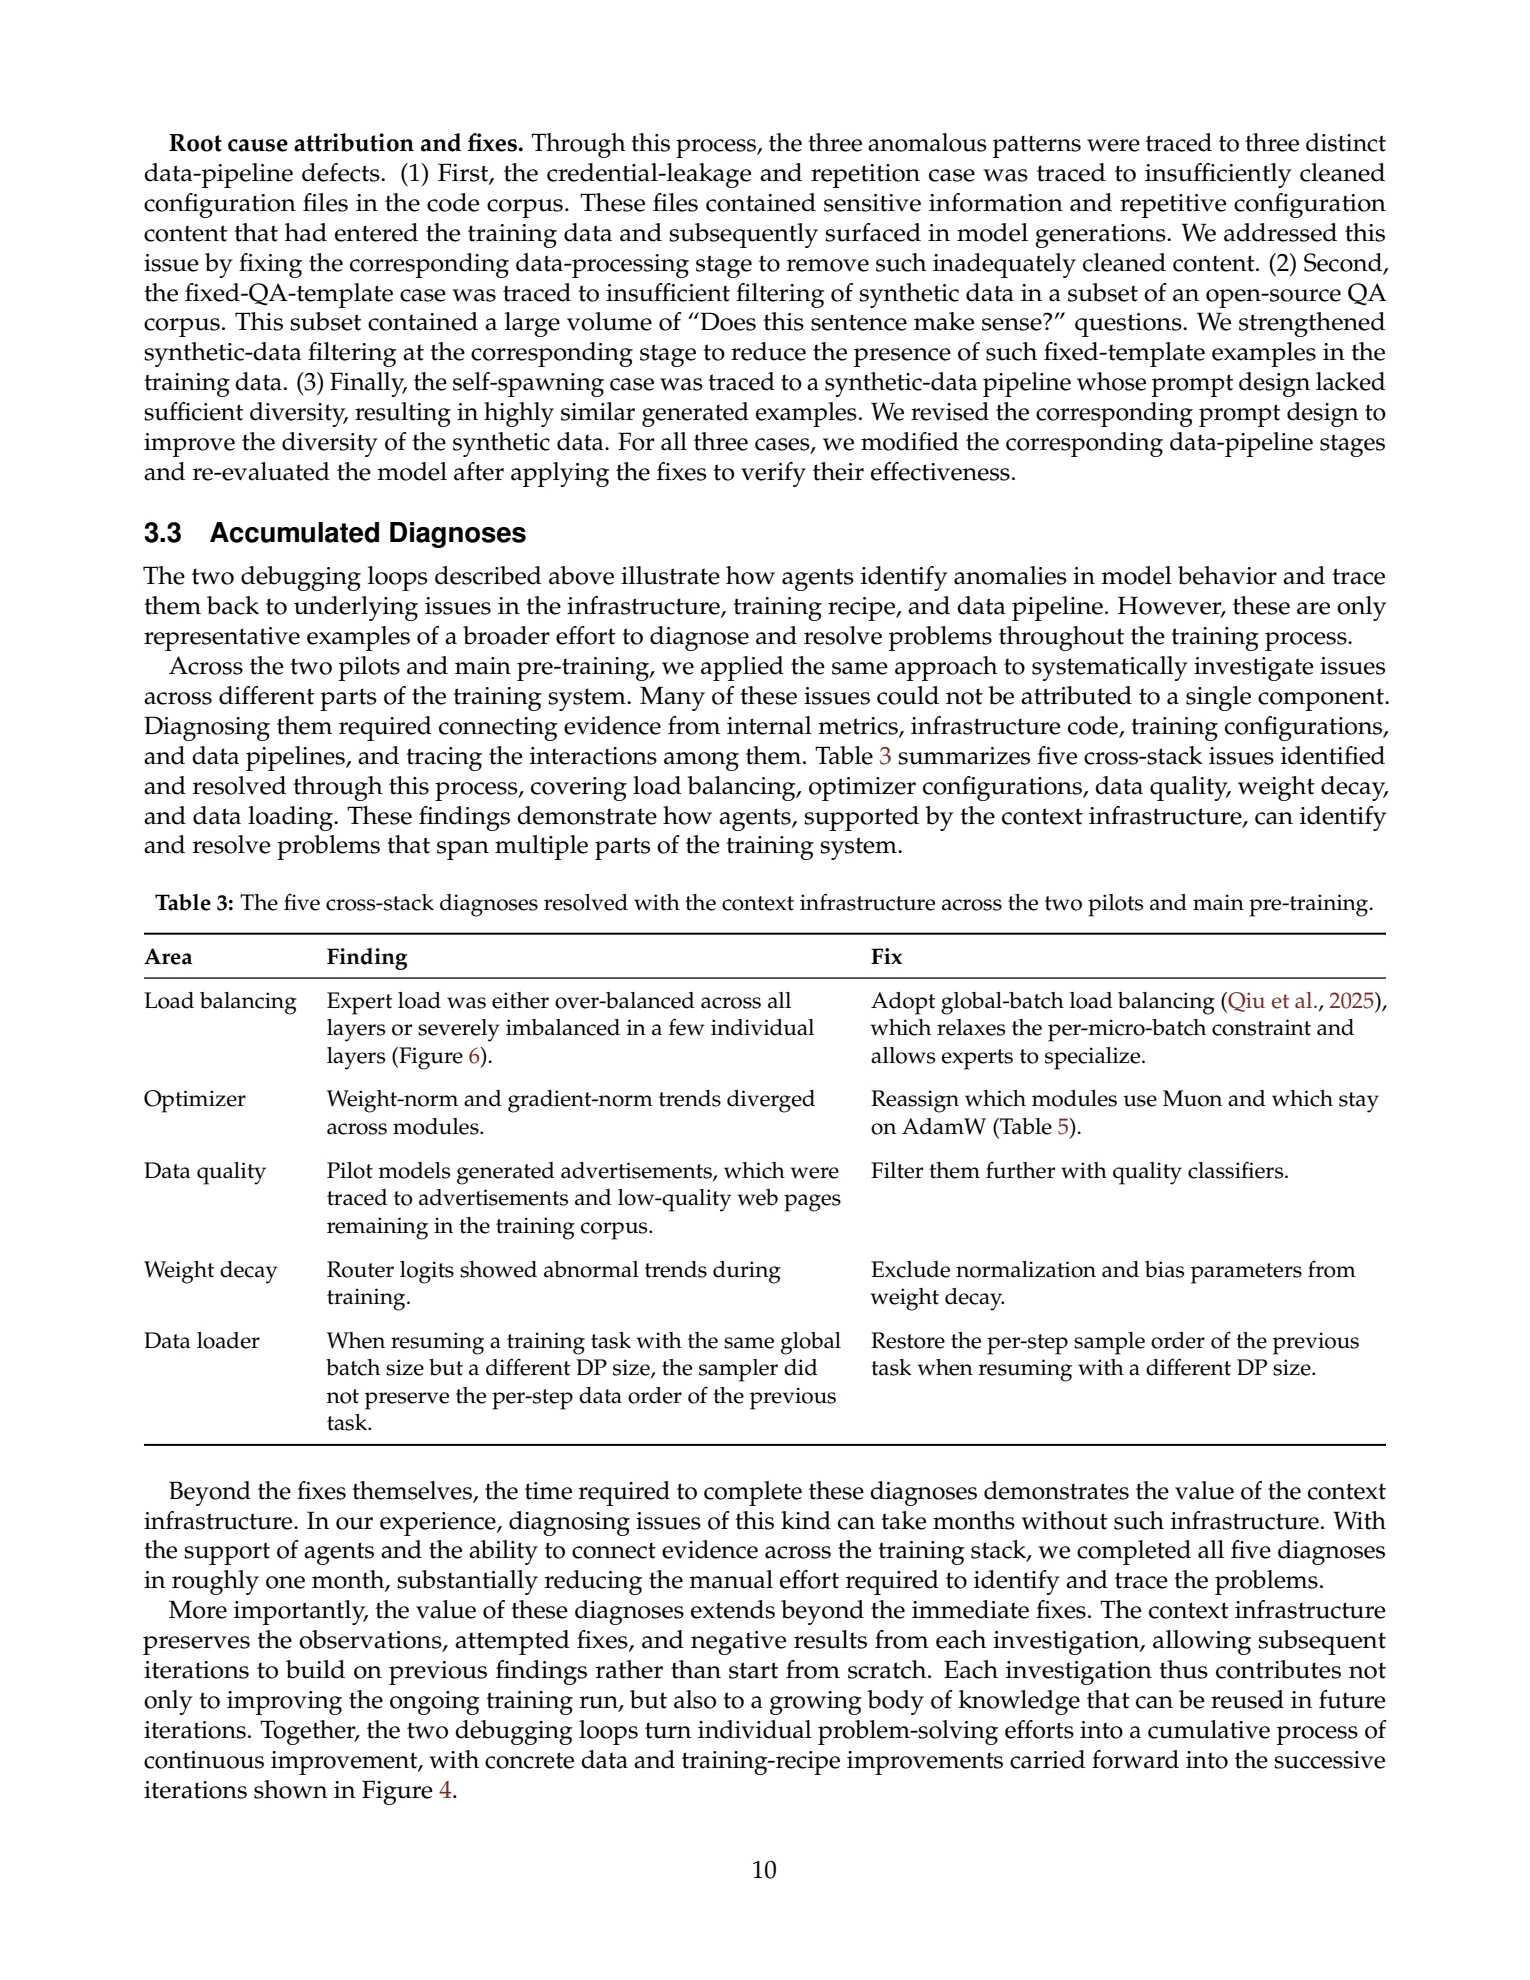
在两次试训和主预训练中,我们用相同方法系统调查训练系统各部分的问题。很多问题无法归因于单一组件,必须连接内部指标、基础设施代码、训练配置和数据流水线的证据,并追踪彼此相互作用。表 3 总结了五项已识别并解决的跨系统问题,涉及负载均衡、优化器、数据质量、权重衰减和数据加载。这说明上下文基础设施支持的智能体能够解决横跨训练系统多个部分的问题。
表 3:两次试训和主训练中,通过上下文基础设施解决的五项跨系统诊断。
负载均衡:所有层过度均衡,或少数层严重失衡(图 6)。修复:采用全局批次负载均衡(Qiu 等,2025),放宽逐微批次约束,使专家能够形成专长。
优化器:不同模块的权重范数与梯度范数趋势分化。修复:重新分配使用 Muon 和保留 AdamW 的模块(表 5)。
数据质量:试训模型生成广告,追溯到语料中残留的广告和低质量网页。修复:用质量分类器进一步过滤。
权重衰减:路由器 logits 在训练中出现异常趋势。修复:归一化与偏置参数不做权重衰减。
数据加载器:在全局批次大小相同、数据并行(DP)规模不同的条件下恢复训练时,采样器未保留之前每一步的数据顺序。修复:DP 规模改变时,恢复此前训练的逐步样本顺序。
诊断耗时也展示了上下文基础设施的价值。根据我们的经验,没有此类基础设施,类似问题可能需要数月才能诊断。借助智能体及跨系统证据连接,我们约一个月就完成了全部五项诊断,大幅减少人工识别与追踪工作。
这些诊断的价值还超越眼前修复。上下文基础设施保存每次调查的观察、修复尝试和负面结果,使后续迭代能继承已有发现。每次调查既改进当前训练,也为未来积累可复用知识。两类调试循环由此将单次问题求解转化为持续累积的改进过程,并将具体的数据与配方改动带入图 4 所示的后续迭代。
第 11 页|Tiny-SFT 与假性停滞
中文译文 · 对应英文原报告第 11 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
4 潜力循环
预训练的目标不是最大化今天的分数,而是为后训练留下最大潜力。衡量这种潜力可为潜力循环提供信号。我们先介绍三种互补的测量(第 4.1 节),再展示它们揭示了哪些基础评估无法发现的现象,最后说明配方循环如何使用这些测量(第 4.2 节)。
4.1 衡量后训练潜力
我们采用 Tiny-SFT、学习能力、跨评估协议取最大值三种测量。它们分别刻画:有限后训练后的表现、从新增数据中学习的效率,以及不同评估协议下能够展现的能力。
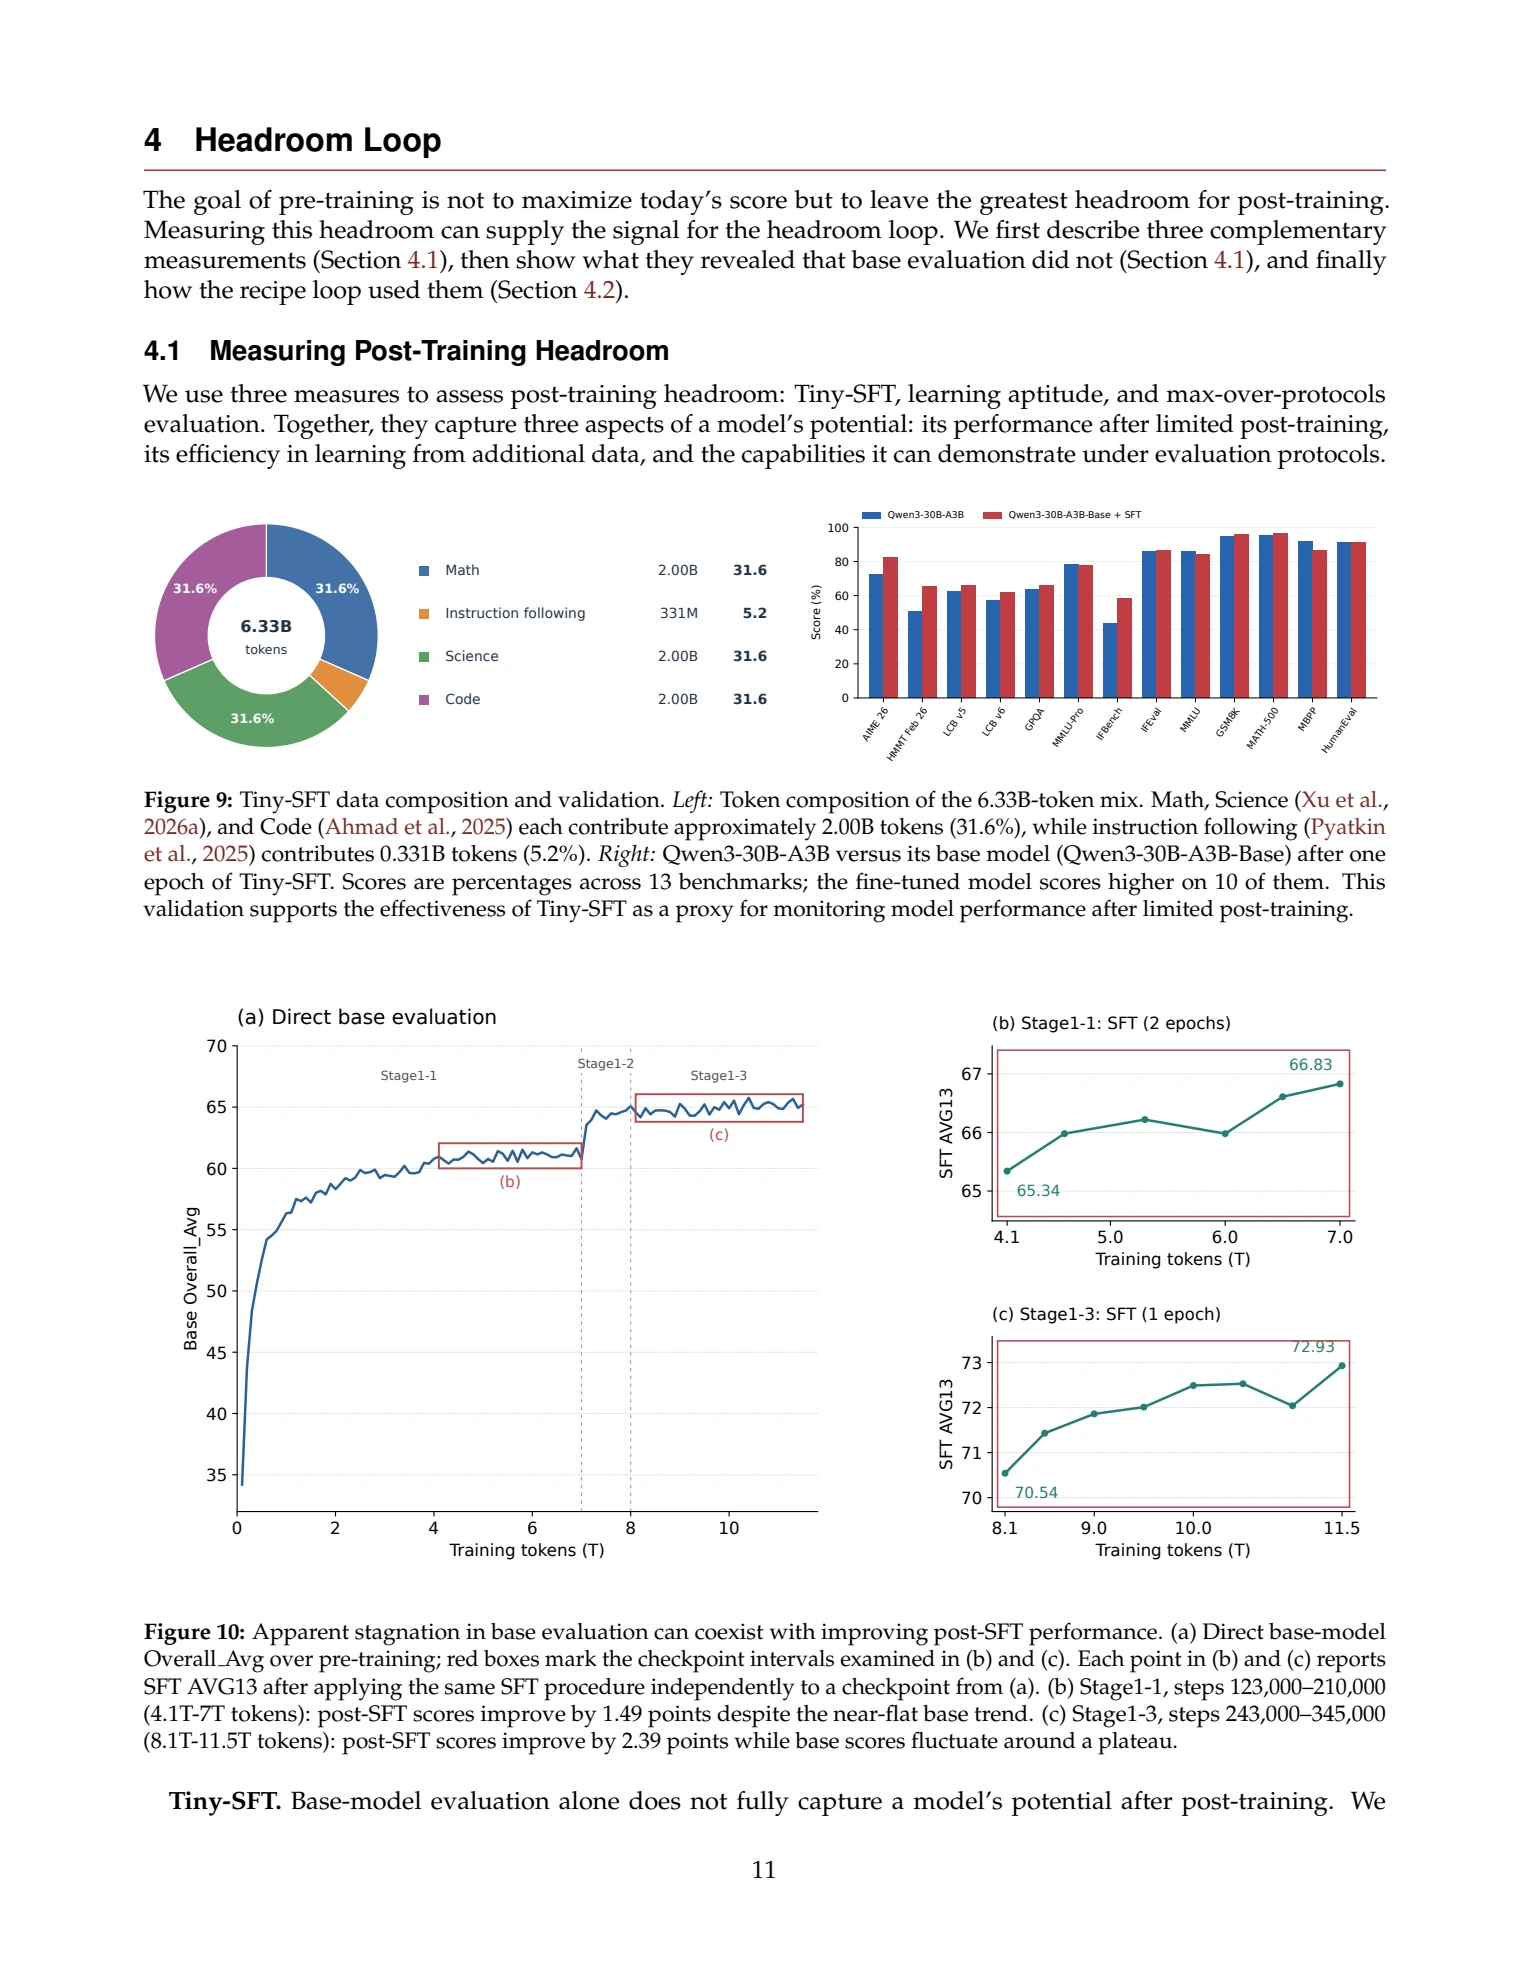
图 9:Tiny-SFT 数据构成及验证。左图:总计 6.33B token,数学、科学(Xu 等,2026a)、代码(Ahmad 等,2025)各约 2.00B,占 31.6%;指令遵循(Pyatkin 等,2025)为 0.331B,占 5.2%。右图:将 Qwen3-30B-A3B 与其基础模型经过一个 epoch 的 Tiny-SFT 后比较。13 项基准均以百分数计,微调模型在其中 10 项上得分更高。这支持将 Tiny-SFT 作为监控有限后训练表现的有效代理。基准包括 AIME 26、HMMT Feb 26、LCB v5/v6、GPQA、MMLU-Pro、IFBench、IFEval、MMLU、GSM8K、MATH-500、MBPP 和 HumanEval。
图 10:基础评估表面停滞,可与 SFT 后表现持续提升同时出现。(a) 预训练期间基础模型 Overall_Avg;红框标出 (b)、(c) 考察的检查点区间。(b)、(c) 每个点都对应独立对某检查点施加相同 SFT 程序后得到的 AVG13。(b) Stage1-1,第 123,000—210,000 步(4.1T—7T token):基础趋势近乎平坦,但两轮 SFT 后分数从 65.34 到 66.83,提高 1.49 分。(c) Stage1-3,第 243,000—345,000 步(8.1T—11.5T token):基础分数围绕平台波动,但一轮 SFT 后从 70.54 到 72.93,提高 2.39 分。
Tiny-SFT。仅评估基础模型无法完整反映后训练潜力。因此,我们为每个受评预训练检查点分配少量 SFT 预算,并直接在面向后训练模型的基准上测试。所得分数近似代表该检查点经历一轮有代表性的后训练后的表现,能更现实地衡量下游潜力。
第 12 页|排名差异与相关系数
中文译文 · 对应英文原报告第 12 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
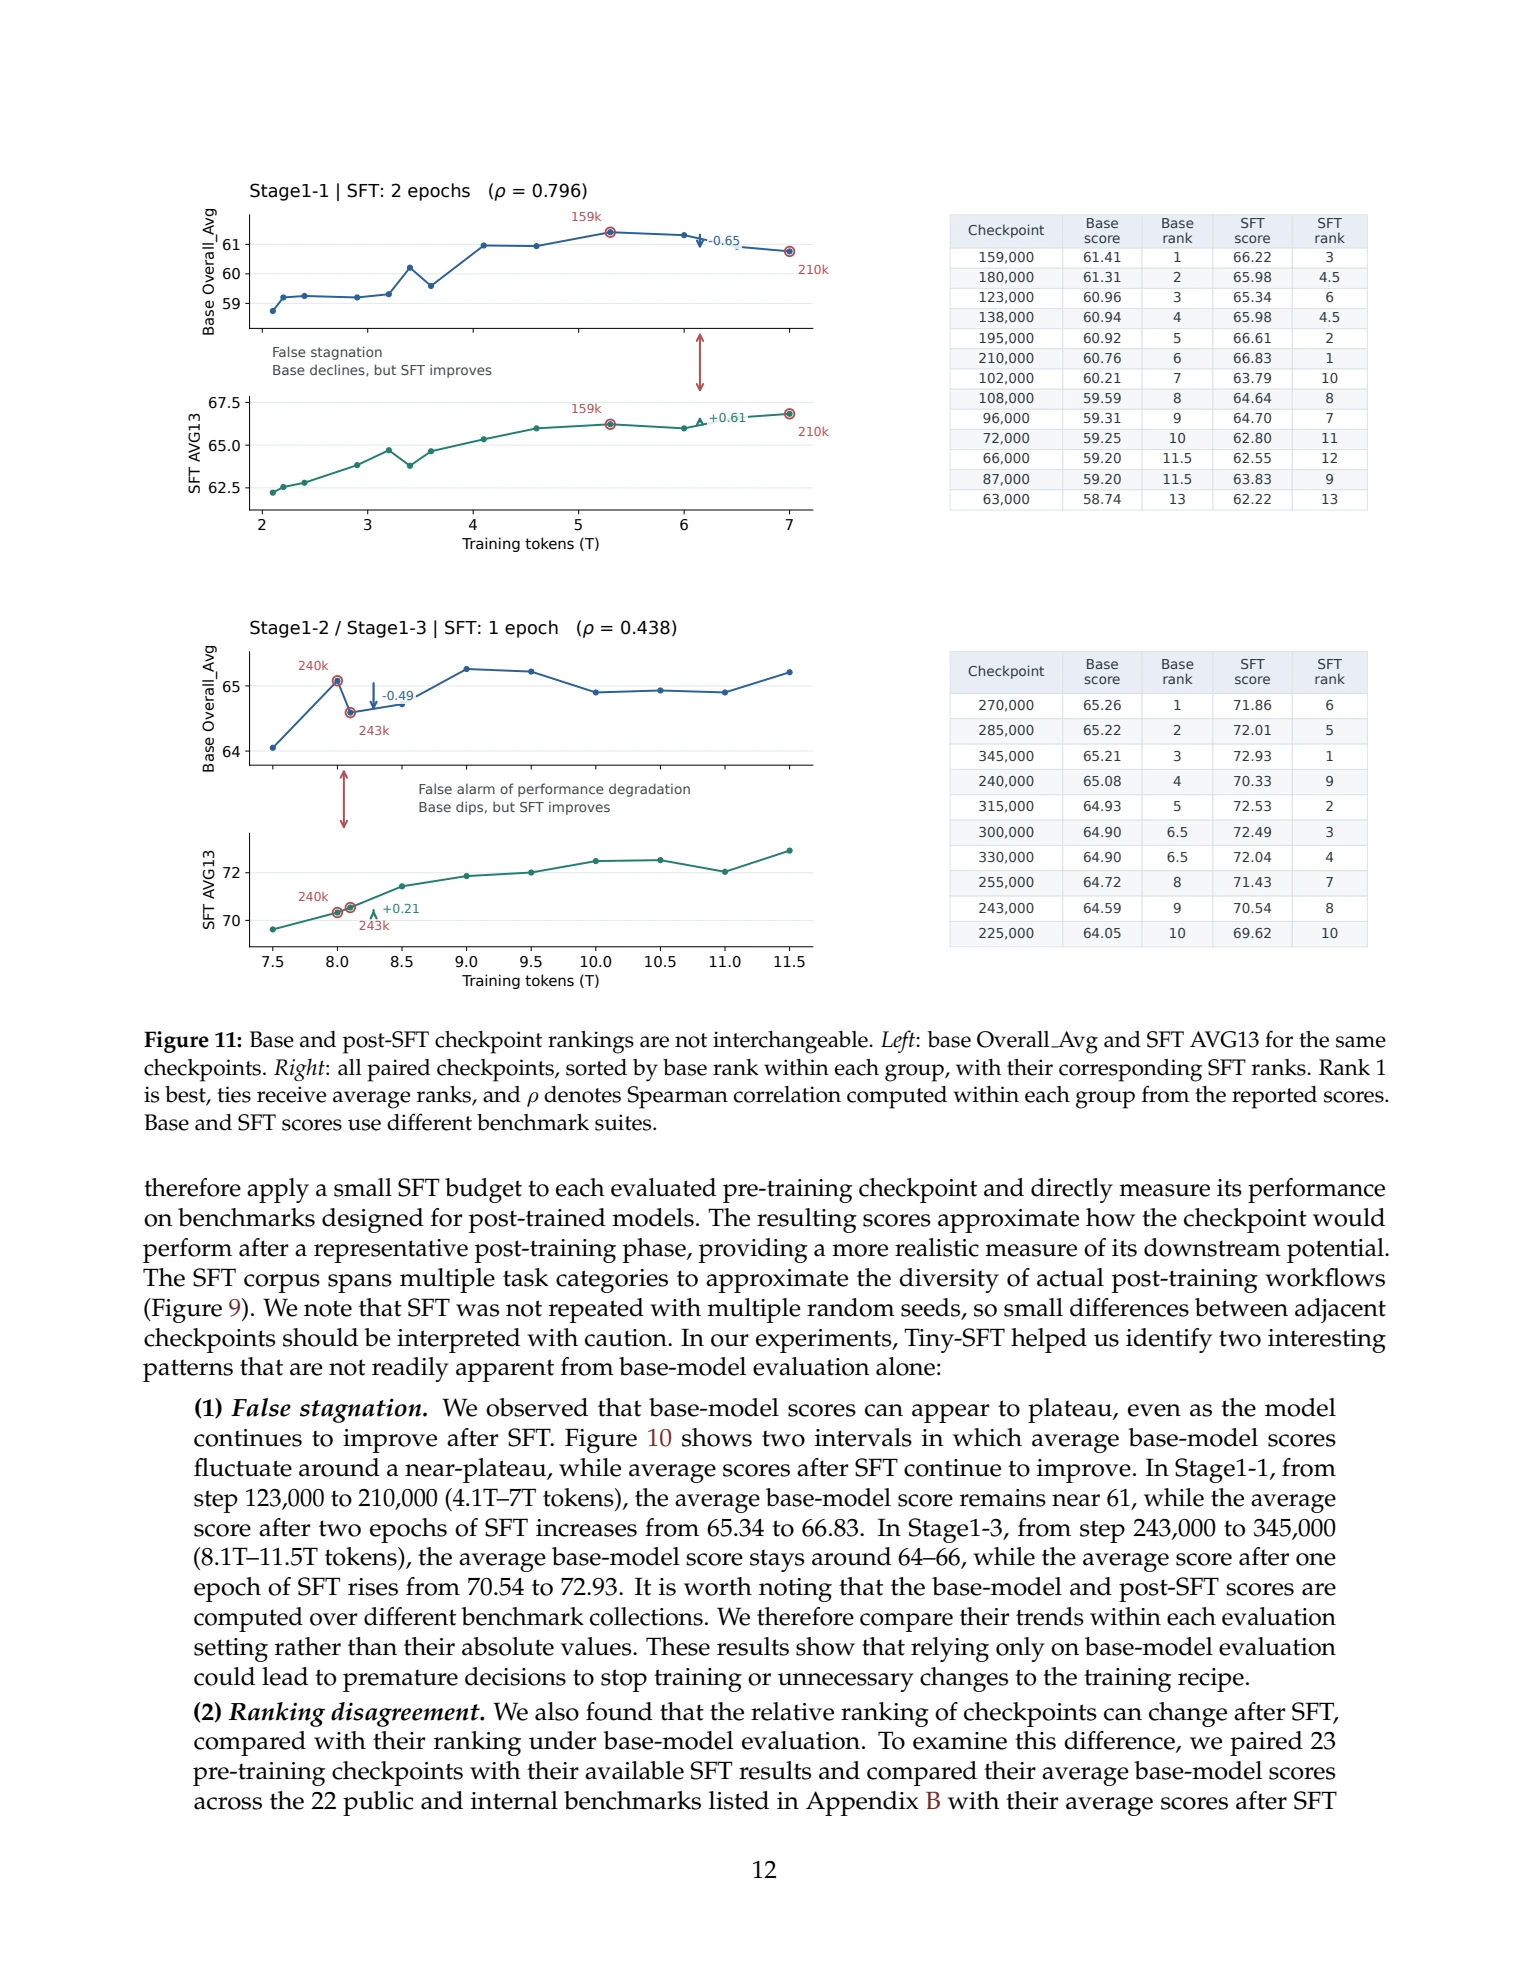
图 11:基础模型与 SFT 后检查点排名不能互换。左侧显示同一组检查点的基础 Overall_Avg 和 SFT AVG13;右侧按组内基础分数排名列出全部检查点及其 SFT 排名。第 1 名最佳,并列取平均名次;ρ 为按报告分数计算的组内 Spearman 相关系数。基础与 SFT 分数使用不同基准集合,原始逐项数据见左栏原表。
上组:Stage1-1,SFT 两轮,ρ=0.796。第 159k 至 210k 步,基础分数下降 0.65,SFT 分数上升 0.61,表现为“假性停滞”。下组:Stage1-2/Stage1-3,SFT 一轮,ρ=0.438。第 240k 至 243k 步,基础分数下降 0.49,SFT 分数上升 0.21,表现为“性能退化的假警报”。表头依次为检查点、基础分数、基础排名、SFT 分数、SFT 排名。
(接上页)SFT 语料覆盖多种任务类别,以近似实际后训练流程的多样性(图 9)。须注意,SFT 没有用多个随机种子重复,因此相邻检查点的小幅差异应谨慎解读。实验中,Tiny-SFT 帮助识别了仅靠基础评估不易发现的两种现象。
(1) 假性停滞。即便基础模型分数似乎进入平台,模型在 SFT 后仍可能持续提升。图 10 展示了两个区间:基础平均分在平台附近波动,SFT 后平均分持续增长。Stage1-1 的第 123,000—210,000 步(4.1T—7T token),基础平均分约为 61,而两轮 SFT 后从 65.34 升至 66.83。Stage1-3 的第 243,000—345,000 步(8.1T—11.5T token),基础平均分约为 64—66,而一轮 SFT 后从 70.54 升至 72.93。两种分数由不同基准集合计算,因此比较的是各自设置下的趋势,而非绝对值。这说明,仅依赖基础评估可能导致过早停止训练,或对配方进行不必要的修改。
(2) 排名不一致。检查点在基础评估与 SFT 后的相对排名可能改变。我们将 23 个预训练检查点与可用的 SFT 结果配对,比较附录 B 中 22 项公开及内部基准的基础平均分,以及 SFT 后平均分(图 11)。早期检查点指令遵循能力更弱,因此使用同一 Tiny-SFT 数据,但为不同训练阶段分配不同 SFT 预算。
第 13 页|学习能力与数据效率
中文译文 · 对应英文原报告第 13 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
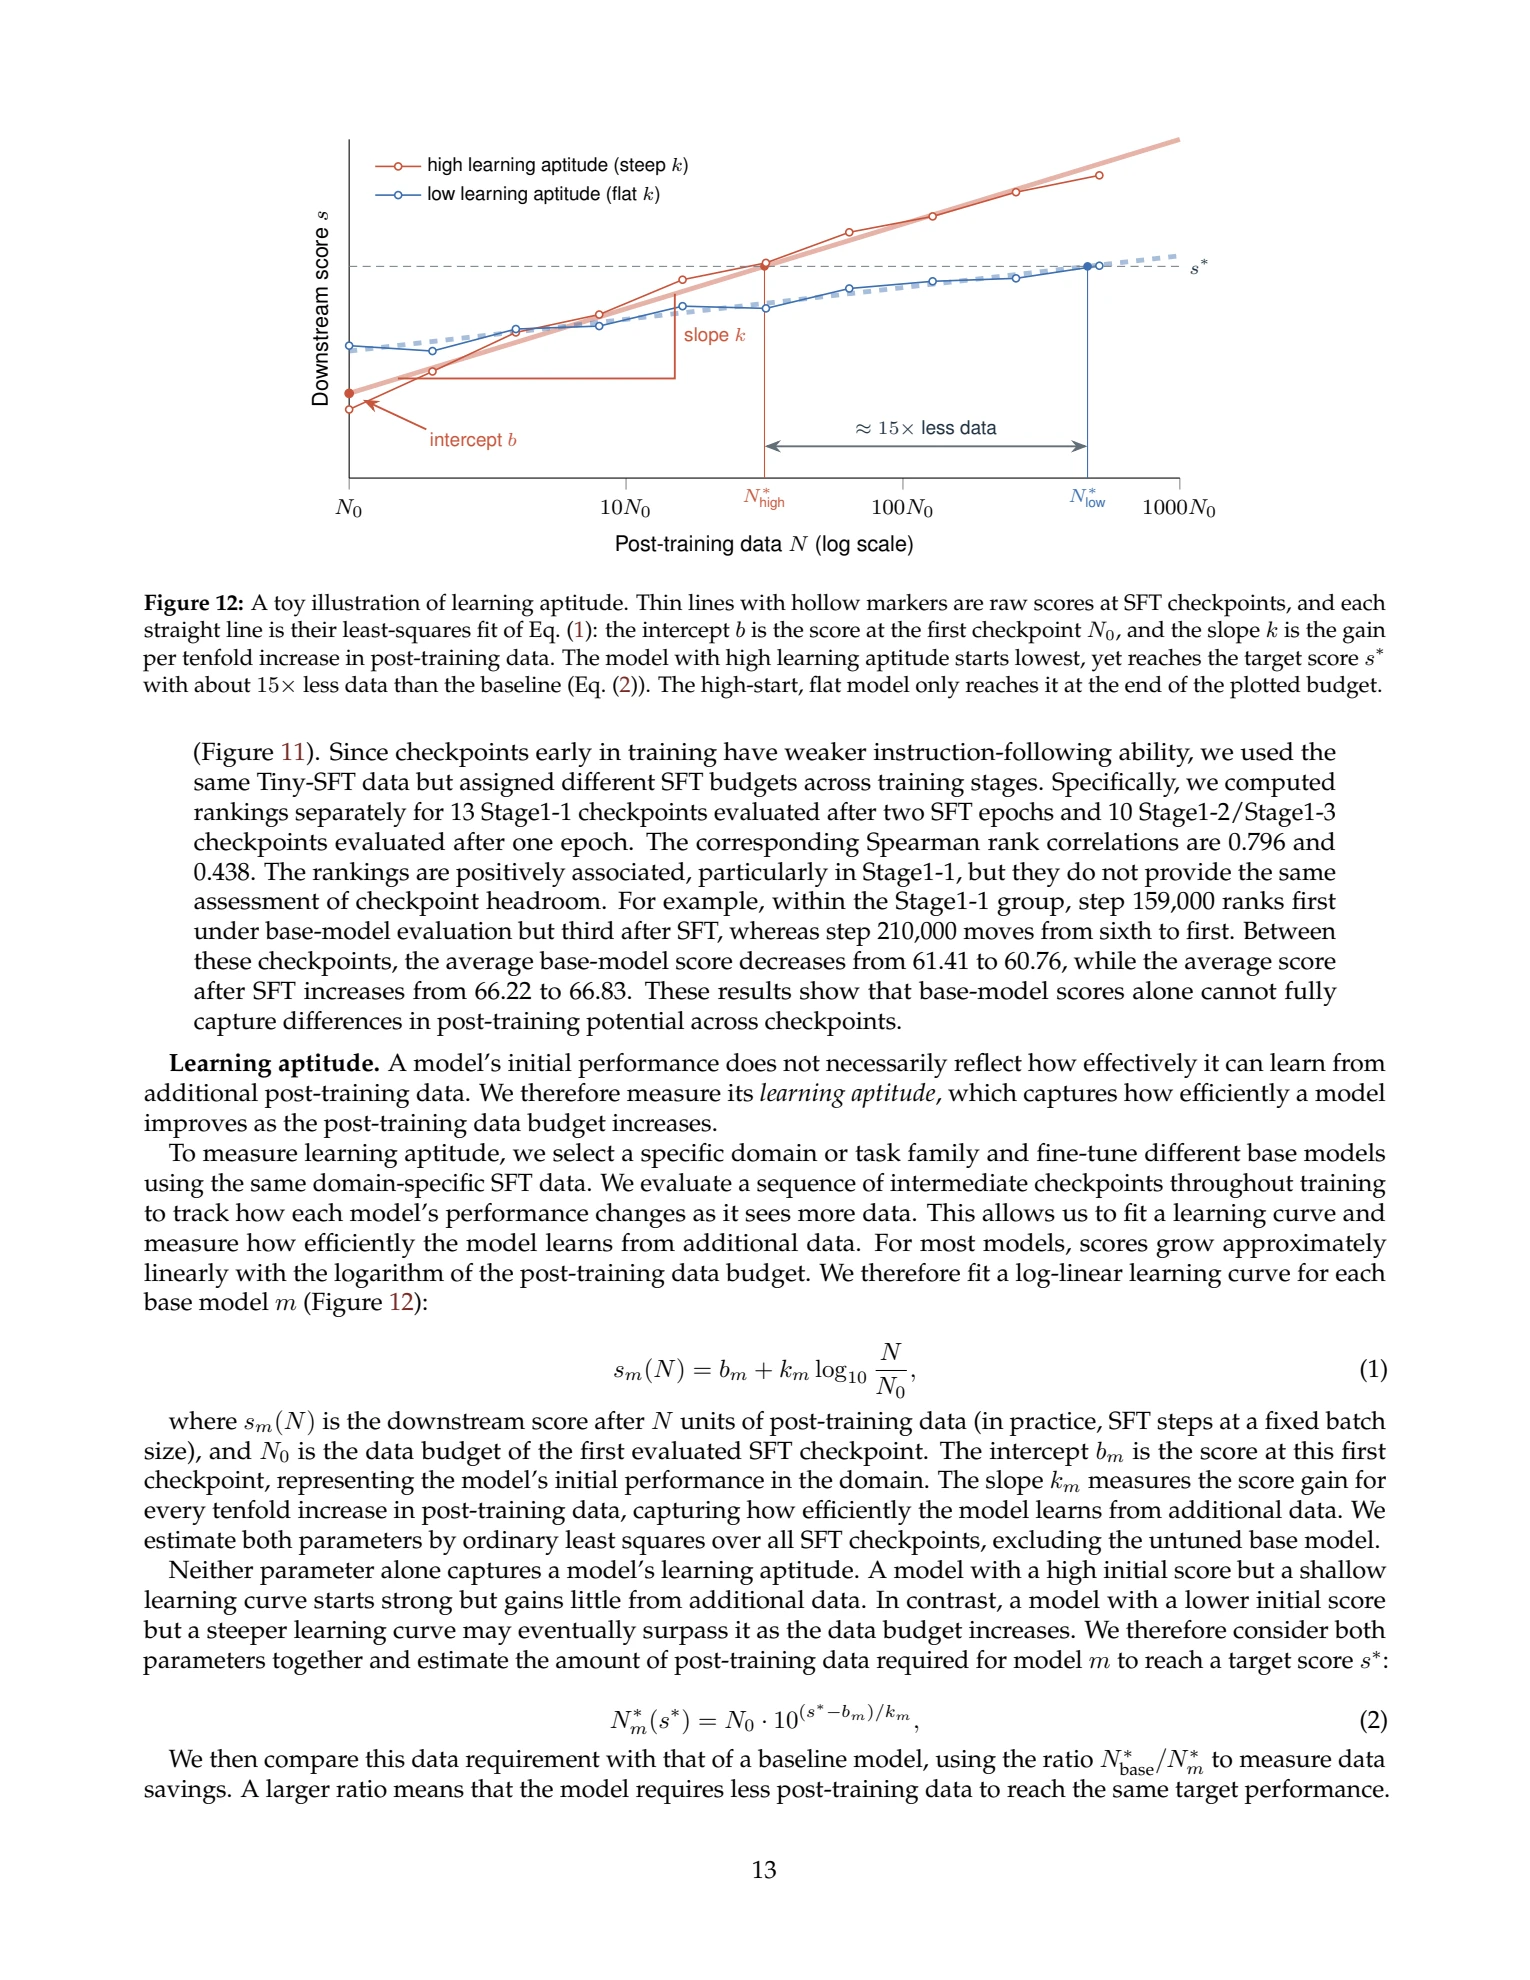
图 12:学习能力示意。带空心标记的细线是各 SFT 检查点原始分数,直线是公式 (1) 的最小二乘拟合。截距 b 是首个检查点 N₀ 的分数,斜率 k 是后训练数据每增加十倍带来的分数增益。学习能力强的模型虽然起点最低,但达到目标分数 s* 所需数据约为基线的 1/15(公式 (2));起点高而曲线平缓的模型直到所绘预算末尾才达到目标。
(接上页)具体而言,我们分别为经过两轮 SFT 的 13 个 Stage1-1 检查点,以及经过一轮 SFT 的 10 个 Stage1-2/Stage1-3 检查点计算排名,Spearman 相关系数分别为 0.796 和 0.438。排名正相关,尤其是 Stage1-1,但对检查点潜力的判断并不相同。例如 Stage1-1 中,第 159,000 步基础评估第 1、SFT 后第 3;第 210,000 步则从第 6 升至第 1。两者之间,基础平均分由 61.41 降至 60.76,SFT 后却由 66.22 升至 66.83。这说明基础分数无法完全反映不同检查点的后训练潜力差异。
学习能力。模型初始表现不一定反映它从新增后训练数据中学习的效率。因此,我们衡量随着后训练数据预算增大,模型改善表现的效率,即学习能力。
测量时,选定领域或任务族,用相同领域 SFT 数据微调不同基础模型,并评估一系列中间检查点,追踪模型见到更多数据后的变化,据此拟合学习曲线。多数模型的分数与后训练数据预算的对数近似线性,因此对每个基础模型 m 拟合(图 12):
s_m(N) = b_m + k_m log₁₀(N/N₀) (1)
其中,s_m(N) 是使用 N 单位后训练数据后的下游分数;实践中,N 为固定批次大小下的 SFT 步数。N₀ 为首个受评 SFT 检查点的数据预算。截距 b_m 是该检查点的分数,代表模型在此领域的初始表现;斜率 k_m 表示数据每增至十倍的分数增益,刻画从新增数据中学习的效率。用所有 SFT 检查点进行普通最小二乘拟合,排除未经微调的基础模型。
单独一个参数不足以刻画学习能力。高起点、低斜率的模型开始很强,却难从新数据中受益;低起点、高斜率的模型则可能随着数据预算增长最终超过它。因此,我们共同考虑两个参数,估计模型 m 达到目标分数 s* 所需的数据量:
N*_m(s*) = N₀ × 10^((s* − b_m)/k_m) (2)
再以基线与该模型的数据需求比 N*_base/N*_m 衡量数据节省。比值越大,表示达到同一目标表现所需后训练数据越少。
第 14 页|跨评估协议取最大值
中文译文 · 对应英文原报告第 14 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
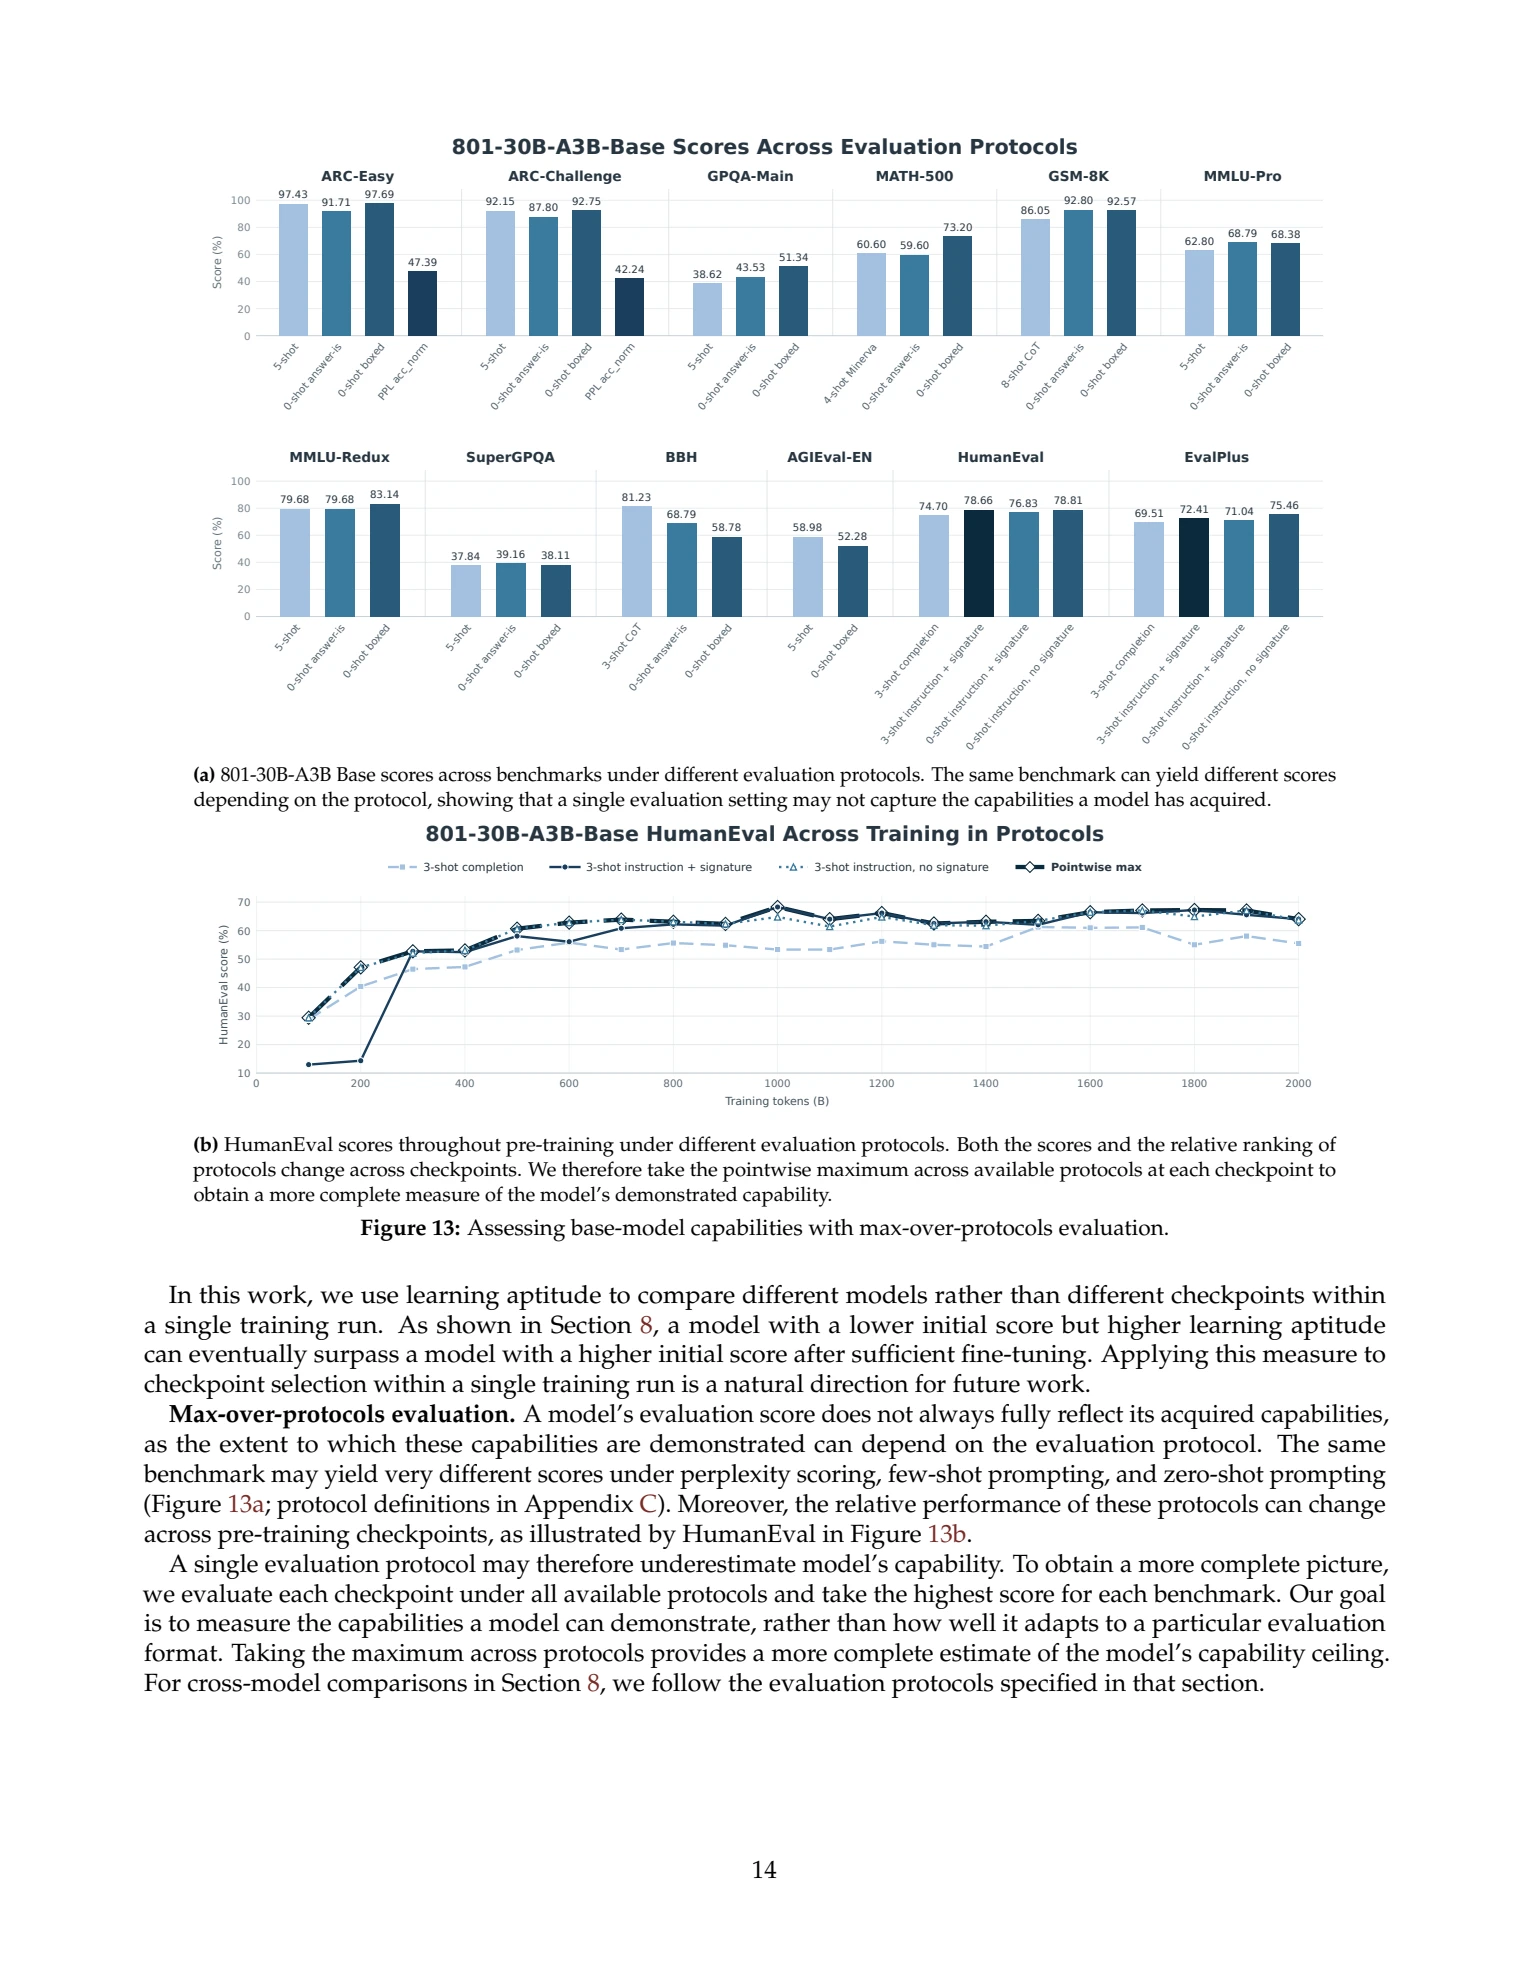
图 13:通过跨评估协议取最大值来评估基础模型能力。
(a) 801-30B-A3B-Base 在不同协议下的基准分数。同一基准会因协议不同而得分不同,单一设置可能无法完整体现模型已学到的能力。图中包括 ARC-Easy、ARC-Challenge、GPQA-Main、MATH-500、GSM8K、MMLU-Pro、MMLU-Redux、SuperGPQA、BBH、AGIEval-EN、HumanEval、EvalPlus。协议包括少样本、零样本、“The answer is”答案格式、boxed 格式、PPL 归一化准确率、Minerva、思维链,以及代码补全/带函数签名指令/不带签名指令;各协议定义见附录 C,原始数值见左图。
(b) 预训练期间不同协议下的 HumanEval 分数。分数和协议之间的相对排名都会随检查点改变。因此,在每个检查点取可用协议中的逐点最大值,以更完整地衡量模型展现出的能力。横轴为训练 token 数(B),纵轴为 HumanEval 分数(%)。
(接上页)本研究用学习能力比较不同模型,而不是同一次训练中的不同检查点。如第 8 节所示,初始分数较低但学习能力较强的模型,经过充分微调后可能超过初始分数更高的模型。将这一测量用于单次训练内部的检查点选择,是自然的未来方向。
跨协议最大值评估。模型评估分数未必完整反映已获得的能力,因为能力展现的程度依赖评估协议。同一基准在困惑度评分、少样本提示和零样本提示下可能得到显著不同的分数(图 13a;协议定义见附录 C)。而且各协议的相对效果还会随预训练检查点改变,如图 13b 的 HumanEval 所示。
因此,单一协议可能低估能力。为获得更完整的图景,我们在全部可用协议下评估每个检查点,并为每个基准选取最高分。目标是衡量模型能够展现的能力,而不是它对某一种评估格式的适应程度。跨协议取最大值提供了更完整的能力上限估计。第 8 节的跨模型比较则使用该节明确规定的评估协议。
第 15 页|配方循环与分类器开发
中文译文 · 对应英文原报告第 15 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
4.2 配方循环
配方循环将后训练潜力测量纳入预训练,以此反馈评估进展、指导配方调整并支持后续迭代。分别止于 1T、3T token 的两次试训和后续主预训练,构成此循环的迭代序列(图 4)。
整个过程中,我们用潜力测量追踪不同训练阶段的后训练潜力演化,再将结果反馈至配方。关注的不只是当前基础分数,还包括后训练表现、学习效率,以及不同协议下展现的能力,以判断预训练是否仍在积累有用能力、当前配方是否需要调整。
依据早期调试发现的问题,我们在开发数据的同时,继续完善基础设施和训练配置。主预训练尤其引入了新 QA 数据,并调整网页、代码、数学、图书和论文的比例及采样权重。
核心思想是:判断预训练进展,既要看当前基础分数,也要看模型是否仍在积累能经后训练进一步开发的能力。即使基础评估进入平台,只要后训练潜力继续增加,预训练就仍可能取得有意义的进展。
5 经验量化循环
预训练中的许多数据处理决策传统上依赖专家经验,例如如何清洗、过滤数据,如何判断处理策略效果。我们将这些任务转成具备明确评估指标的标准工作流,让智能体能够分析错误、修订方法、比较替代方案,并在反复迭代中改进。
我们将其称为“经验量化循环”,应用于分类器开发、站点发现和抓取覆盖优化。三者遵循同一原则:将人类经验转化为可测量任务,让智能体执行并改进工作,再以评估结果指导下一轮迭代。
5.1 分类器开发循环
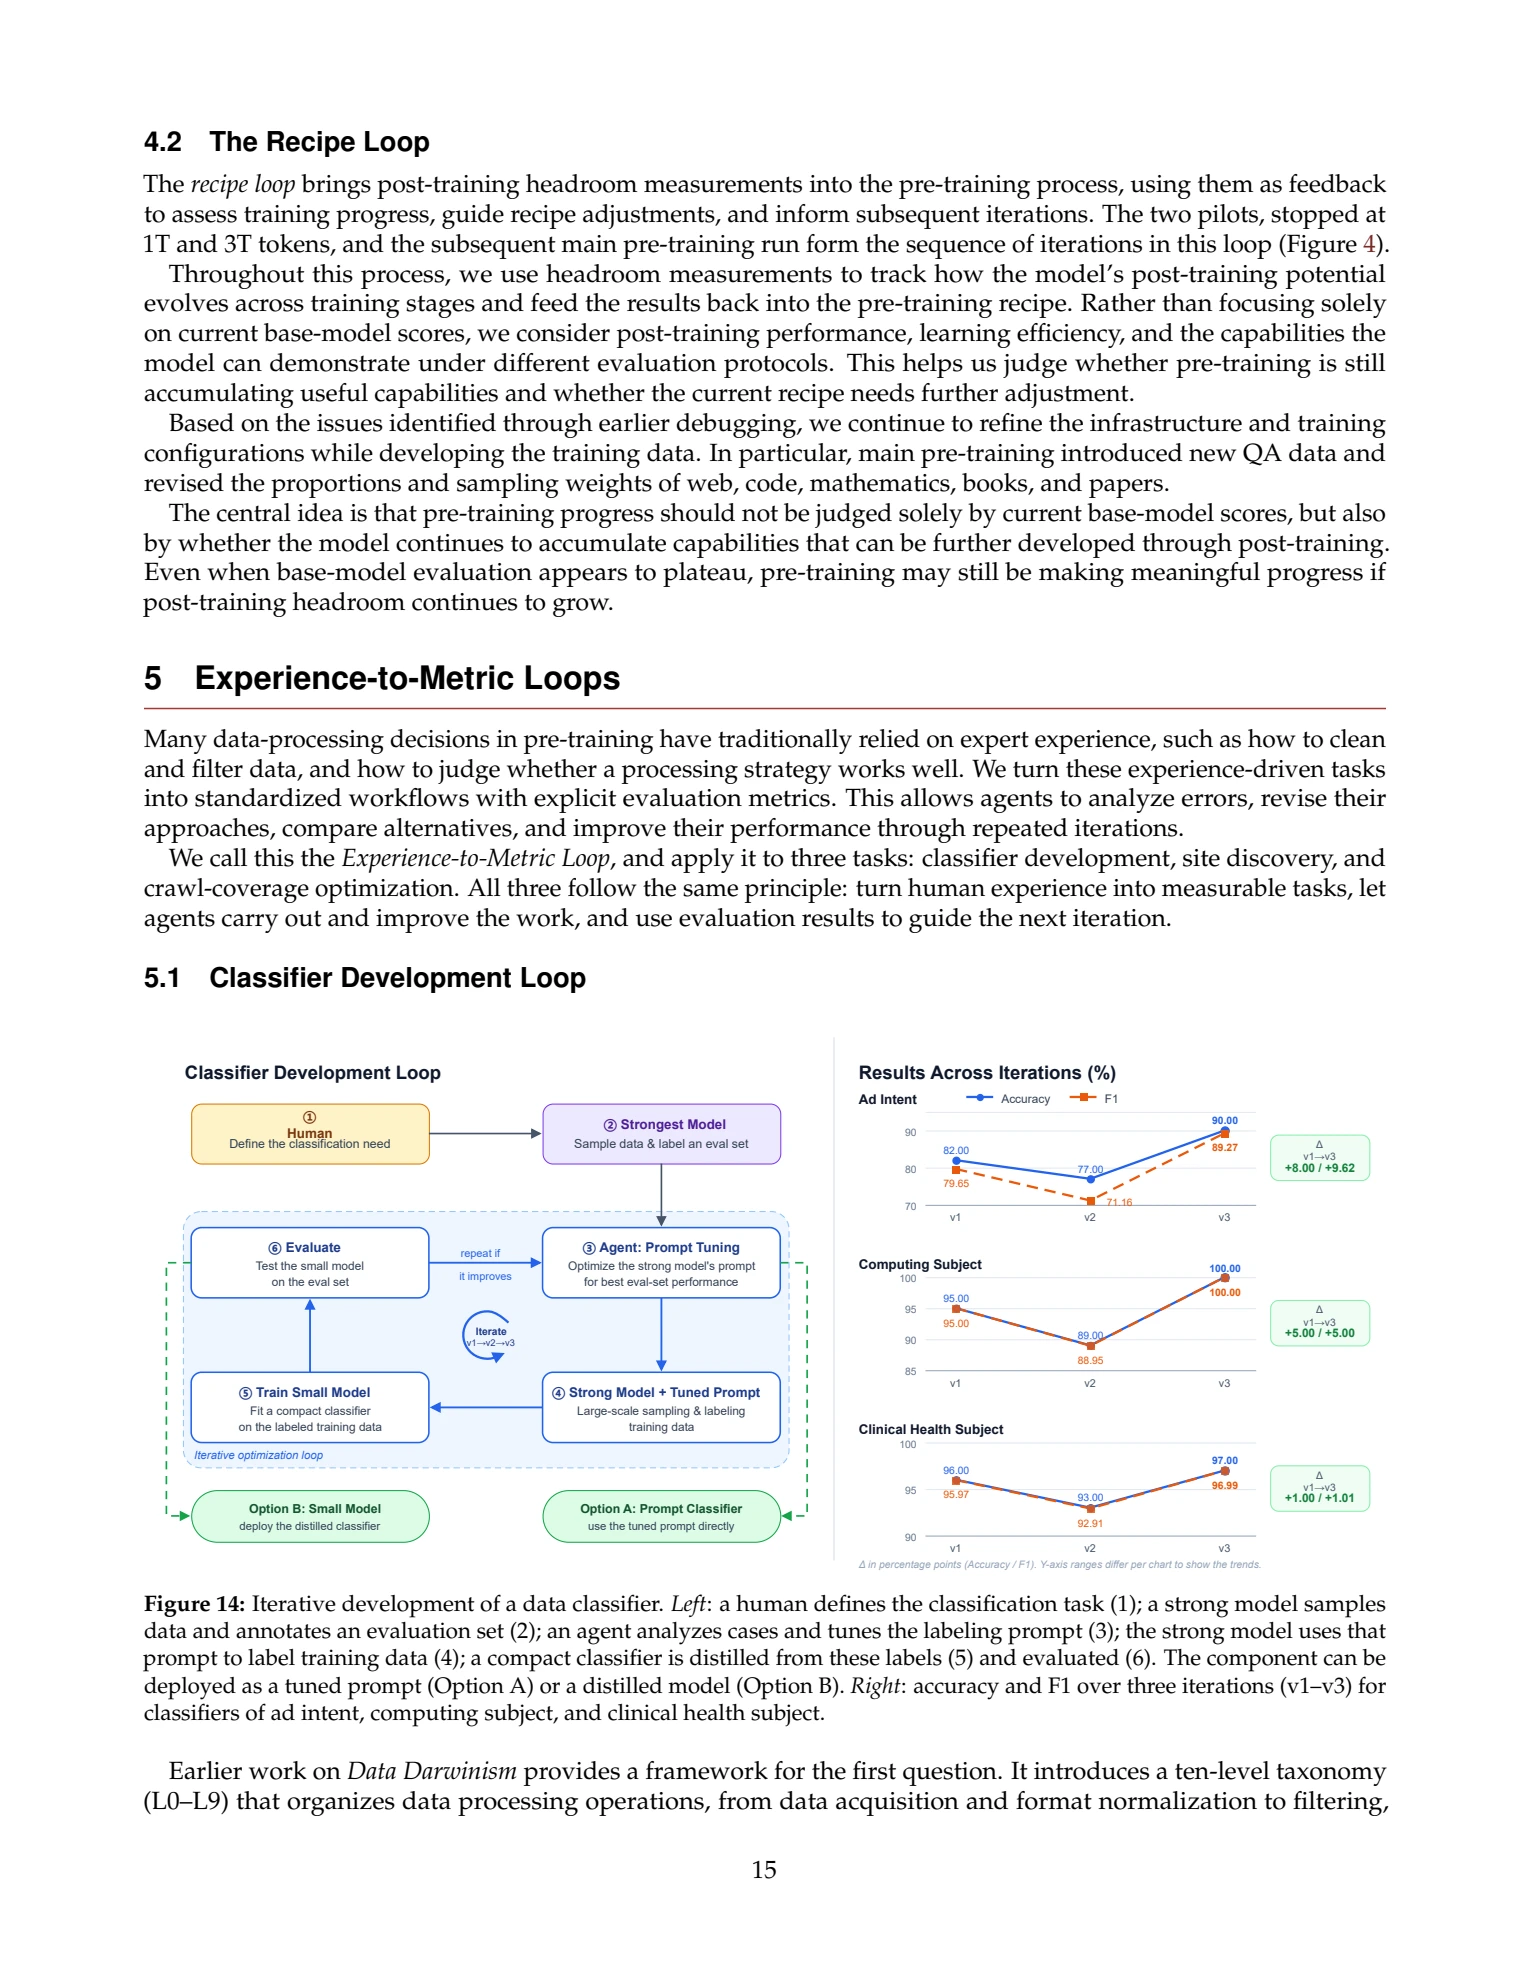
图 14:数据分类器的迭代开发。左图六步:①人类定义分类需求;②强模型采样并标注评估集;③智能体分析案例、调优标注提示词;④强模型用调好的提示词大规模标注训练数据;⑤训练紧凑分类器;⑥在评估集上评测,如仍有改进则继续迭代。部署可选调优后的提示词分类器(A),或蒸馏的小模型(B)。
右图为三个分类器 v1—v3 的准确率/F1(%):广告意图为 82.00/79.65、77.00/71.16、90.00/89.27,总提升 8.00/9.62 个百分点;计算机主题为 95.00/95.00、89.00/88.95、100.00/100.00,提升 5.00/5.00;临床健康主题为 96.00/95.97、93.00/92.91、97.00/96.99,图中报告提升 1.00/1.01。各图纵轴范围不同,以显示变化趋势。
此前的 Data Darwinism 为第一个问题提供了框架:将数据处理分为 L0—L9 十级,从数据获取、格式规范化到过滤、模型驱动优化和合成(Qin 等,2026a)。沿用其在 daVinci-LLM 中的做法(Qin 等,2026b),我们用这一框架指导流水线设计。
第 16 页|分类器迭代与站点发现
中文译文 · 对应英文原报告第 16 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
例如,OCR 属于格式规范化(L1),规则和模型过滤对应 L2—L3,清洗或修复内容的生成式优化属于 L4。该分类体系使我们在选择模型、提示词或实现方式之前,先明确各组件职责。
DataEvolve 研究互补问题:数据整理策略如何通过反复评估和诊断反馈改进(Mi 等,2026)。受其启发,我们用共享评估流程开发分类器、过滤器、OCR 模型和改写器。Data Darwinism 指导选择处理操作,评估循环则判断具体实现是否胜任预定任务。图 14 以分类器展示三阶段(图中六步)流程。
步骤 1:定义任务、构建评估集。研究者明确分类器职责,强模型标注代表样本,形成参考评估集,为比较提示词、模型和规则提供共同质量标准。参考标签由强模型生成,因此评估衡量的是与该模型的一致程度,而非与人类判断的一致程度。
步骤 2:分析错误、改进组件。智能体并行分析数百至数千样本,识别反复出现的错误模式,修订提示词、比较模型或调整规则。每次修订均依据相同任务定义和评估集检验,确定是否真正改善。
步骤 3:验证与部署。修订组件须先评估再部署。分类器可直接采用调好的标注提示词,也可利用强模型标注数据蒸馏成小模型;小分类器继续评估和迭代。评估能够捕捉退步:图 14 中三个分类器在 v2 均准确率下降,随后 v3 提升。
不到三个月,我们构建了六条数据流水线,智能体贡献了 36 项模型选择决策,并完成提示词优化和分类器构建。
5.2 网页获取:站点发现与抓取覆盖循环
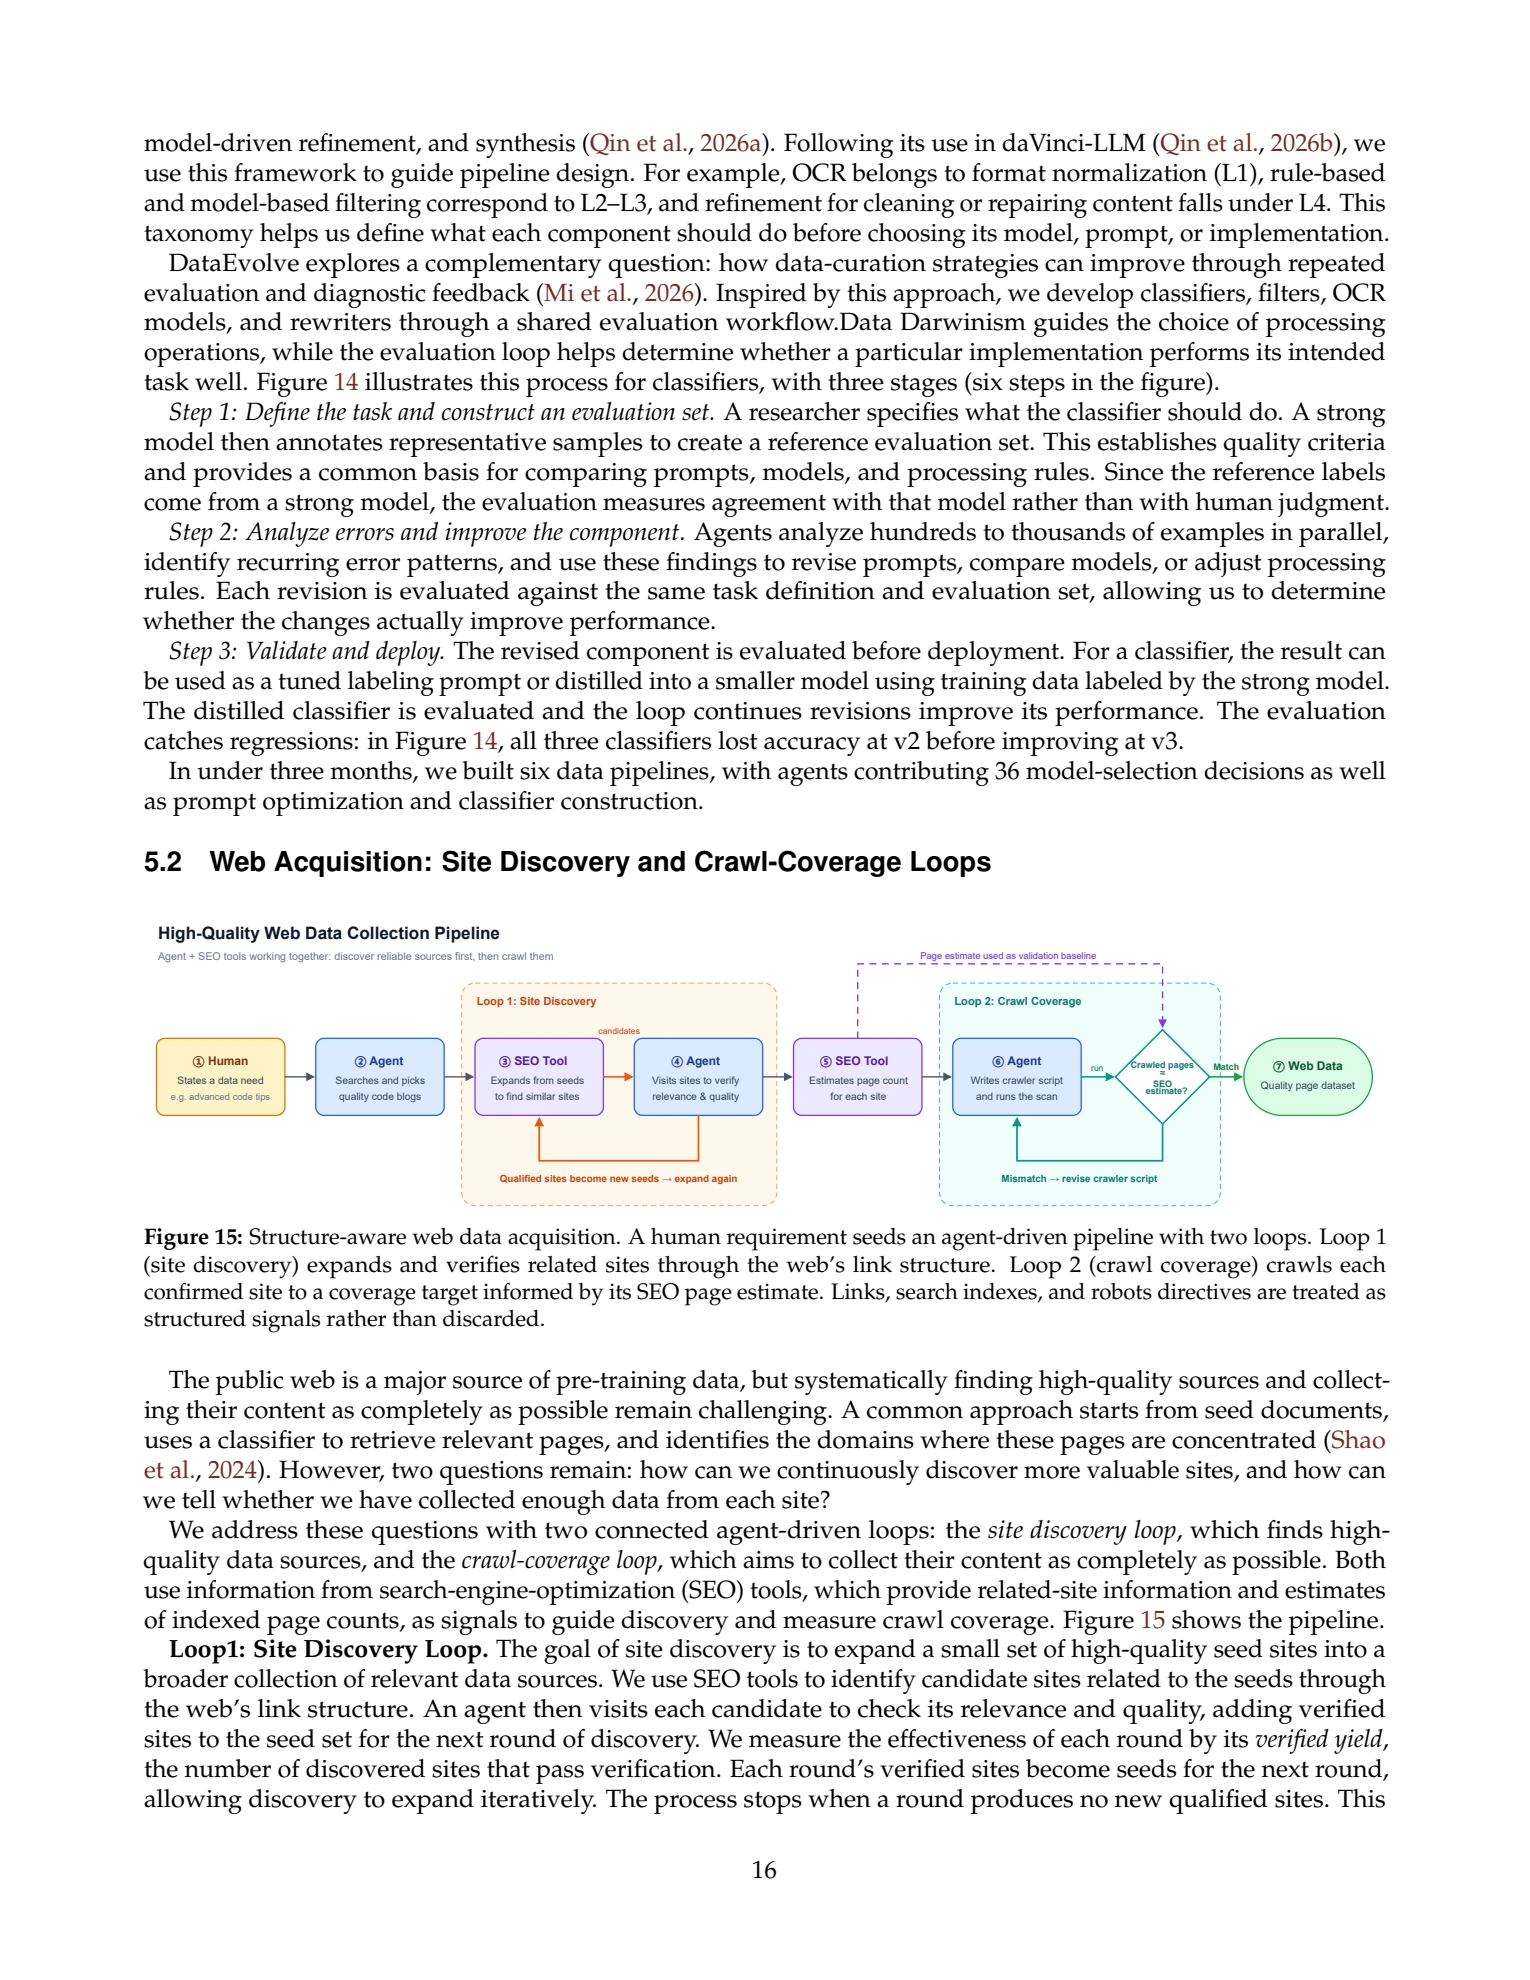
图 15:利用网页结构的数据获取。人类需求启动智能体驱动流水线。循环 1 沿网页链接结构扩展并验证相关站点;循环 2 依据 SEO 页面数估计设定覆盖目标并抓取。链接、搜索索引、robots 指令均被当作结构化信号保留。
流程为:①人类提出数据需求,如高级编程技巧;②智能体搜索并挑选优质代码博客;③SEO 工具从种子拓展相似站点;④智能体访问并验证相关性与质量;⑤SEO 工具估计站点页面数;⑥智能体编写并执行爬虫;⑦形成优质网页数据集。合格站点成为新种子继续扩展;抓取数与估计不符时,修订爬虫。
公开网页是主要预训练数据源,但系统发现优质来源、尽可能完整地收集内容仍有困难。常见做法从种子文档出发,用分类器检索相关页面,识别这些页面集中的域名(Shao 等,2024)。仍有两个问题:怎样持续发现更多有价值站点?怎样判断每个站点是否收集充分?
我们用相连的站点发现与抓取覆盖循环解决这两个问题。二者都借助搜索引擎优化(SEO)工具提供的相关站点信息和索引页面数估计,指导发现并衡量覆盖(图 15)。
循环 1:站点发现。将少量优质种子扩成更广的相关来源集合。SEO 工具沿链接结构找候选站点,智能体逐一验证相关性和质量,将通过验证者加入下一轮种子。每轮效果以“验证产出量”衡量,即发现且通过验证的站点数。当某轮不再产生新合格站点时停止。这将“接下来去哪里找”的经验决策转化为可测量、可重复的过程。
第 17 页|网页覆盖与软件任务构建
中文译文 · 对应英文原报告第 17 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
循环 2:抓取覆盖。发现有价值站点后,智能体为每个站点编写并运行爬虫,将抓取页数与 SEO 估计页数比较,采用:
覆盖率 = 已抓取页面数 / 估计总页面数。
SEO 页数虽只是估计,仍提供定量参照。智能体比较数量、调查缺口、修订爬虫并重跑,测量新覆盖率。抓取由此由可测量覆盖驱动,而非凭感觉判断“抓得够不够”。
闭合循环。站点发现解决去哪里找更多优质来源,抓取覆盖解决如何尽可能完整收集。与分类器开发一起,三者将经验任务转为有明确评估指标的工作流,使智能体执行、评估并迭代改进。分类器开发使用任务评估分数;站点发现使用每轮验证产出量;网页抓取使用覆盖率。关键是为专家判断型任务明确目标和评估程序,让智能体依据反馈判断完成程度和下一步改进方向。这样,经验决策成为系统、可重复的过程,从一个个组件入手使预训练更科学。
6 将智能体数据扩展到预训练规模
智能体数据由解决真实任务、结果可验证的轨迹构成,已证明对后训练有效(Pan 等,2025;Yang 等,2025b)。真实软件开发提供了丰富任务和预训练新机会。目标是在保持任务多样性、数据质量的同时,将此数据源扩至数千亿 token。
达到这一规模需要超越传统处理流水线。真实软件任务多样,涉及复杂的任务构建、执行环境、测试与跨运行框架集成。我们认为,广泛使用智能体是将此类数据扩至预训练规模的必要条件。主要瓶颈不是生成少量优质样本,而是系统地将多样的软件开发活动转成可执行、可验证、可扩展的数据。
6.1 为什么智能体数据需要智能体
复杂的任务构建与验证。近期研究探索了自动构建环境和评估脚本以让开发任务可执行(Fu 等,2026b),在中期训练轨迹中保留开发上下文及执行反馈(Zeng 等,2026),以及将相关 PR 连接成长任务链(Jiang 等,2026)。
扩至预训练规模须处理真实开发活动的全部多样性,包括描述清楚、测试维护良好的 PR(Jimenez 等,2024;Pan 等,2025;Badertdinov 等,2025),也包括描述不完整、需求隐含或捆绑多个工作项的 PR。每个 PR 都须构建三个相互一致的组件:可复现执行环境、明确预期工作的指令、验证需求满足情况的测试及评估脚本。
这些组件必须共同开发。例如,仓库 CI 注入的环境变量若在构建环境中遗漏,评估会因与代码无关的原因失败;测试若要求特定函数名,而指令只描述行为,正确实现也可能被拒绝;一个 PR 含多个工作项时,指令、环境和测试还可能划定不同任务边界。
任务构建因而不仅是从 PR 提取描述。环境、指令和评估必须对任务要求一致。智能体需要检查仓库上下文,识别并修正不一致;规模化时还要处理各仓库特有惯例和开发实践的长尾。
第 18 页|验证关卡与多框架集成
中文译文 · 对应英文原报告第 18 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
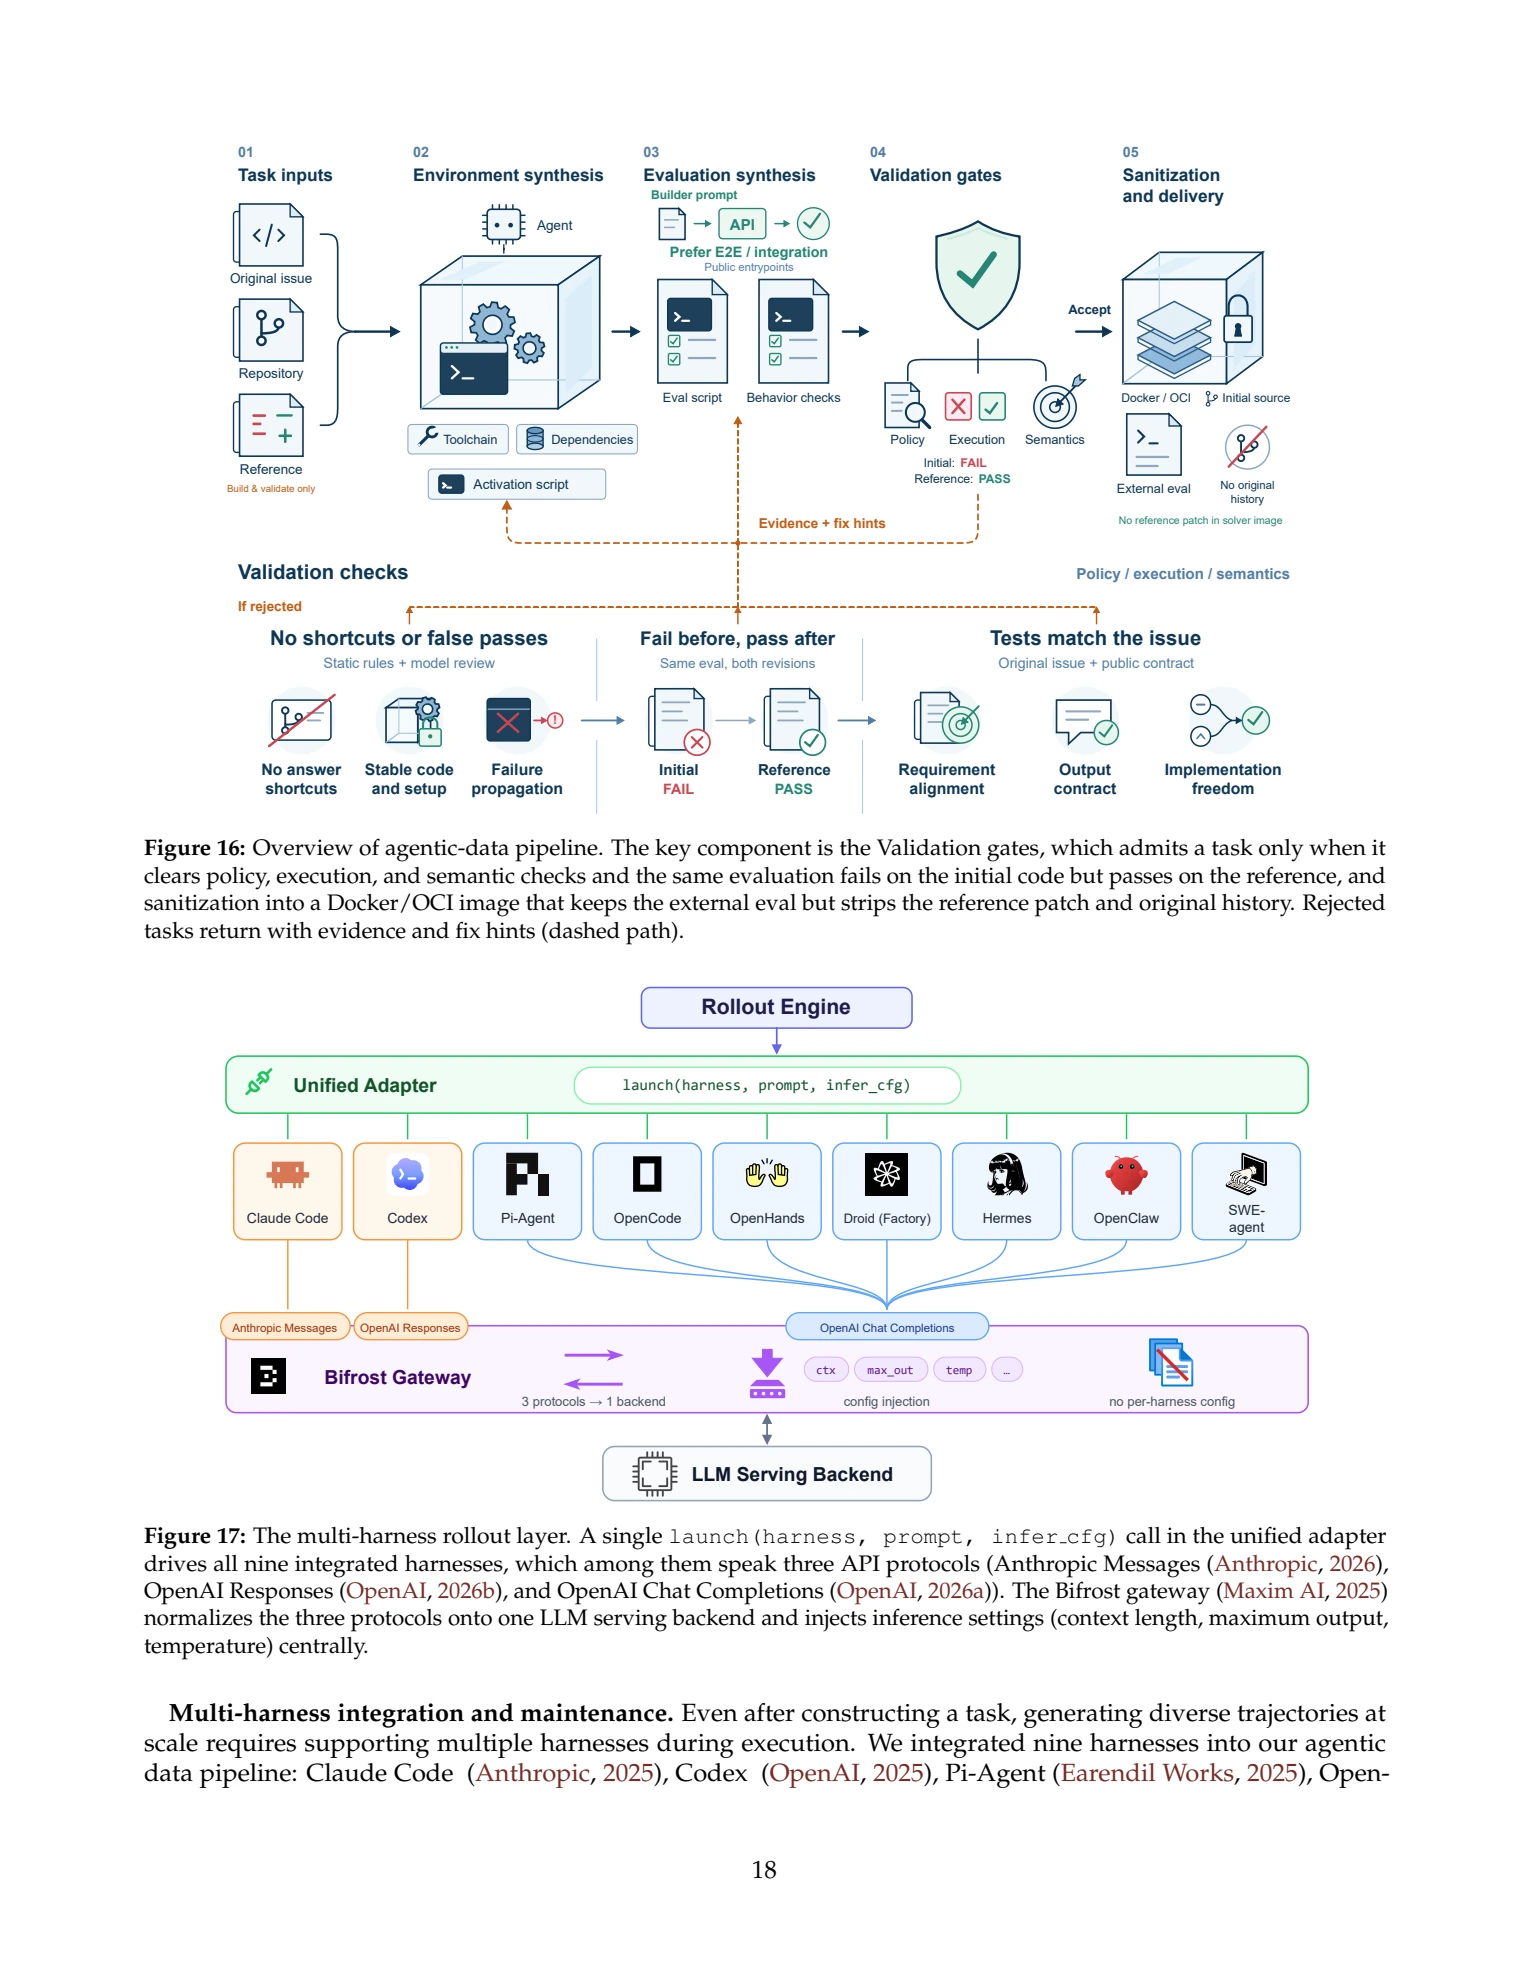
图 16:智能体数据流水线概览。
①任务输入:构建器提示词、智能体 API、原始 issue、仓库,以及仅供构建和验证使用的参考修改。
②环境合成:工具链、依赖与激活脚本。
③评估合成:优先端到端/集成测试,经公开入口检查行为,生成评估脚本。
④验证关卡:任务必须同时通过策略、执行、语义检查,且相同评估必须在原始代码上失败、参考修改后通过。策略检查用静态规则和模型审查,排除答案捷径、虚假通过,保证代码与配置稳定及失败正确传播;执行检查要求同一评估在修改前失败、修改后通过;语义检查依据原始 issue 和公开契约,确保需求一致、输出契约正确,并保留实现自由。
⑤清理与交付:打包为 Docker/OCI 镜像,保留初始源代码及外部评估,剥离参考补丁和原始历史。未通过任务携带证据和修复提示返回修订(虚线路径)。求解器镜像中没有参考补丁。
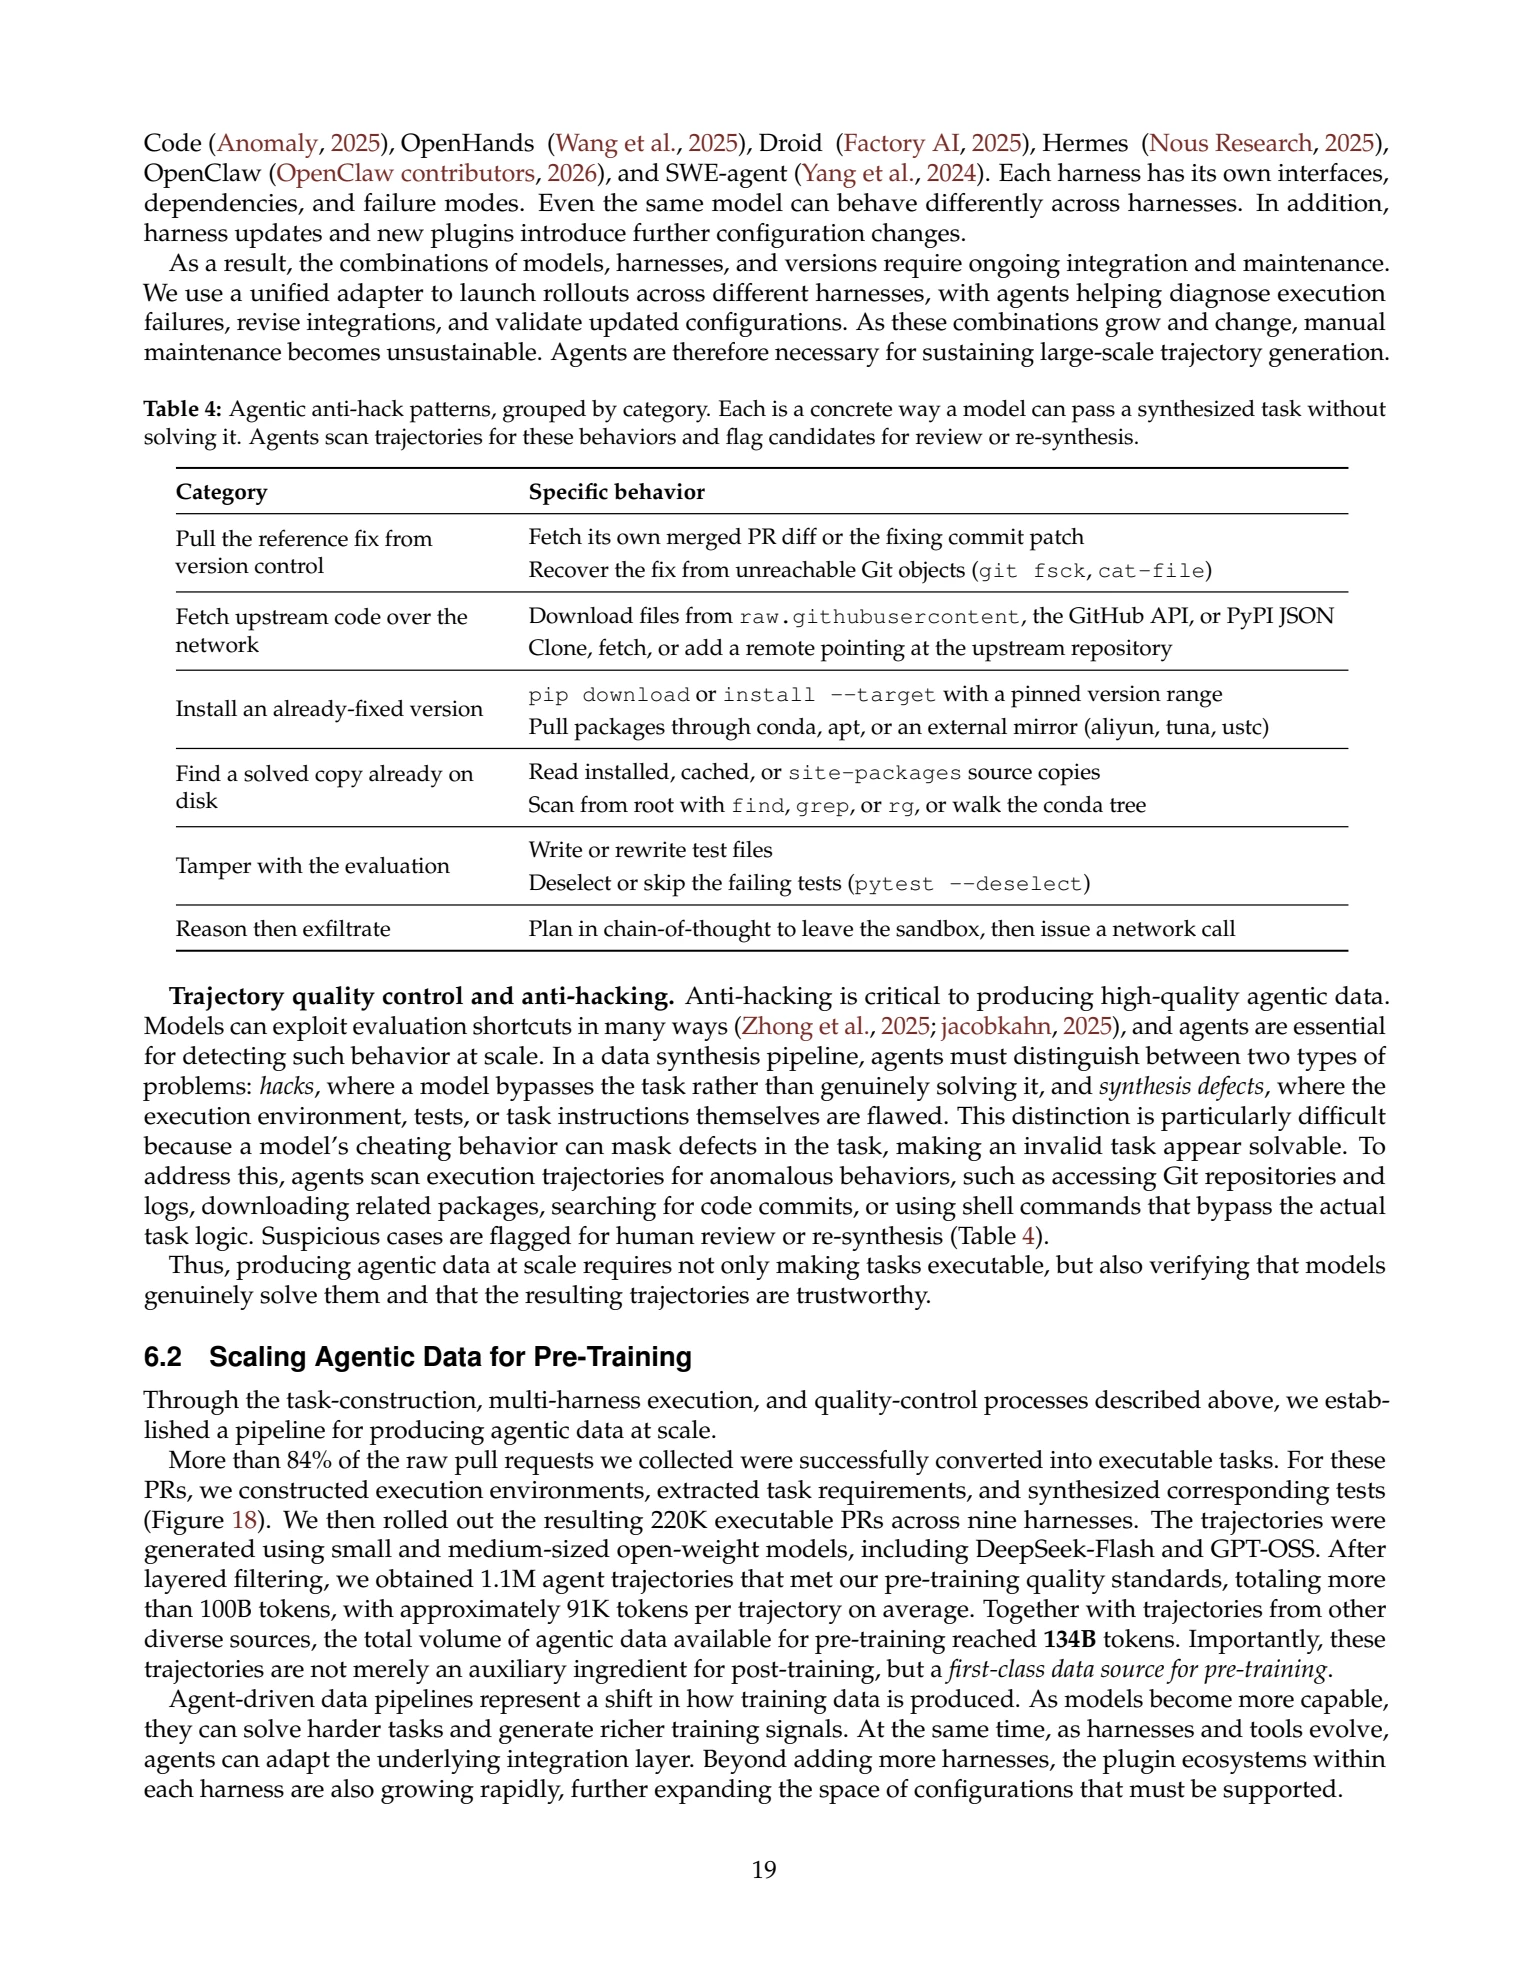
图 17:多运行框架轨迹生成层。统一适配器通过一次 launch(harness, prompt, infer_cfg) 调用驱动九种集成框架。框架分别使用 Anthropic Messages(Anthropic,2026)、OpenAI Responses(OpenAI,2026b)、OpenAI Chat Completions(OpenAI,2026a)三种 API 协议。Bifrost 网关(Maxim AI,2025)将三协议归一到同一个 LLM 服务后端,集中注入上下文长度、最大输出、温度等设置,无须逐框架配置。
九种框架为 Claude Code、Codex、Pi-Agent、OpenCode、OpenHands、Droid(Factory)、Hermes、OpenClaw、SWE-agent。
多框架集成与维护。任务构建完成后,要大规模生成多样轨迹,还需要支持多种运行框架。我们集成了 Claude Code(Anthropic,2025)、Codex(OpenAI,2025)、Pi-Agent(Earendil Works,2025)、OpenCode(Anomaly,2025)、OpenHands(Wang 等,2025)、Droid(Factory AI,2025)、Hermes(Nous Research,2025)、OpenClaw(OpenClaw contributors,2026)和 SWE-agent(Yang 等,2024)。
第 19 页|反作弊与轨迹质量控制
中文译文 · 对应英文原报告第 19 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
各框架具有不同接口、依赖和失败模式。同一模型在不同框架下也可能表现不同;框架更新及新插件进一步带来配置变化。
因此,模型、框架与版本的组合需要持续集成和维护。统一适配器负责跨框架启动轨迹生成,智能体协助诊断执行故障、修订集成和验证新配置。组合不断增加变化,人工维护难以持续,智能体因而是大规模轨迹生成得以维持的必要条件。
表 4:智能体数据中的防作弊检查模式。以下均是模型可能绕过真正求解、直接通过合成任务的具体行为;智能体扫描轨迹并标记供复核或重新合成。
从版本控制获取参考修复:获取该任务已合并 PR 的差异或修复提交补丁;从不可达 Git 对象恢复修复(git fsck、cat-file)。
经网络取得上游代码:从 raw.githubusercontent、GitHub API 或 PyPI JSON 下载文件;克隆、fetch 或添加指向上游仓库的远端。
安装已修复版本:按固定版本范围 pip download 或 install --target;从 conda、apt 或外部镜像(aliyun、tuna、ustc)获取软件包。
在磁盘寻找已解决副本:读取已安装、缓存或 site-packages 中的源代码;用 find、grep、rg 从根目录扫描或遍历 conda 树。
篡改评估:新建或重写测试文件;取消选择或跳过失败测试(pytest --deselect)。
先推理后外传:在思维链中计划离开沙箱,随后发出网络调用。
轨迹质量控制与反作弊。模型可利用多种评估捷径(Zhong 等,2025;jacobkahn,2025),智能体对规模化检测至关重要。合成流水线中必须区分两类问题:作弊,即绕过任务而非真正求解;合成缺陷,即环境、测试或指令本身有误。这尤其困难,因为作弊可能掩盖任务缺陷,使无效任务看起来可解。
智能体因此扫描访问 Git 仓库和日志、下载相关软件包、搜索代码提交、以 shell 命令绕过实际任务逻辑等异常行为,并将可疑案例交由人类复核或重新合成(表 4)。规模化数据生产不仅要使任务可执行,还须确认模型真正解决了任务、轨迹值得信任。
6.2 面向预训练的智能体数据扩展
通过上述任务构建、多框架执行与质量控制,我们建立了规模化数据流水线。
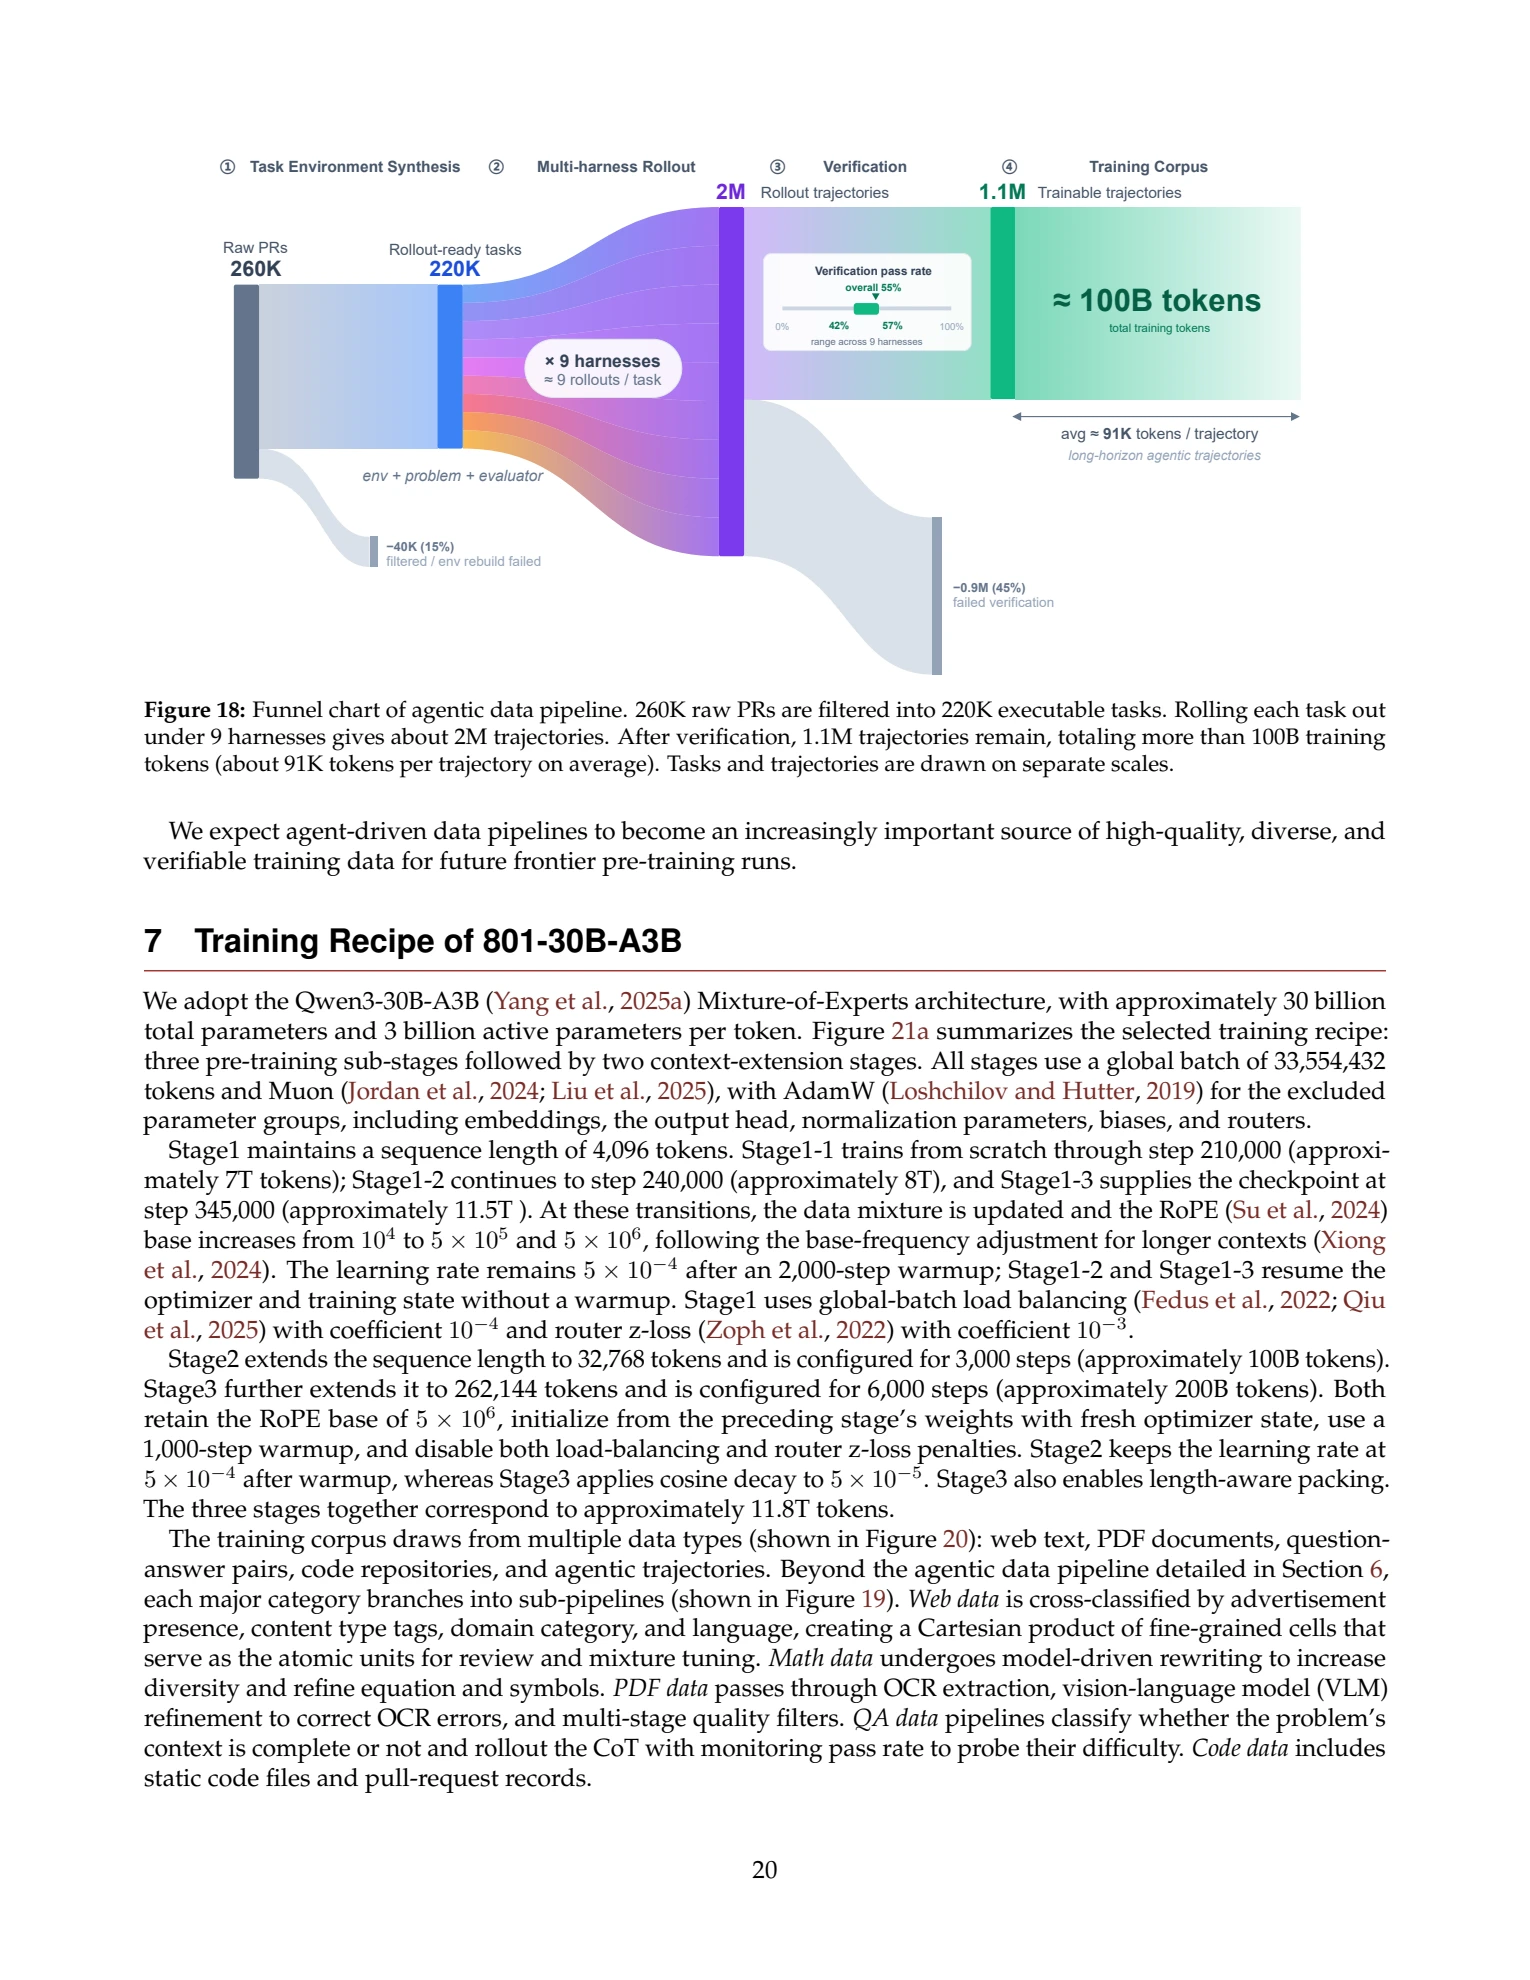
收集的原始 PR 超过 84% 被成功转成可执行任务:构建环境、提取需求并合成测试(图 18)。22 万个可执行 PR 在九种框架中展开,使用 DeepSeek-Flash、GPT-OSS 等中小型开放权重模型生成轨迹。经分层过滤,得到 110 万条满足预训练质量标准的轨迹,总计超过 100B token,平均每条约 91K token。加上其他多样来源,预训练可用智能体数据总计 134B token。这些轨迹不是仅供后训练的辅助材料,而是预训练的一等数据源。
智能体驱动流水线改变了训练数据生产方式。模型能力变强,便可解决更难任务、产生更丰富信号;运行框架与工具演化时,智能体还能适配底层集成。除框架数量增加外,各框架内的插件生态也迅速扩张,进一步扩大须支持的配置空间。
第 20 页|智能体数据规模与训练配方
中文译文 · 对应英文原报告第 20 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
图 18:智能体数据流水线漏斗。26 万原始 PR 经筛选成为 22 万可执行任务,约 4 万(15%)因过滤或环境重建失败被移除。每个任务在九种框架下约展开九次,共约 200 万条轨迹。约 90 万(45%)未通过验证,留下 110 万条可训练轨迹,总计超过 100B token,平均约 91K token/条。总验证通过率 55%,九种框架间约为 42%—57%。任务数与轨迹数使用不同绘图尺度。
我们预计,智能体驱动流水线会成为未来前沿预训练中越来越重要的优质、多样、可验证数据来源。
7 801-30B-A3B 的训练配方
采用 Qwen3-30B-A3B(Yang 等,2025a)MoE 架构,总参数约 300 亿,每个 token 激活约 30 亿。图 21a 总结配方:三个预训练子阶段,之后两个上下文扩展阶段。所有阶段全局批次均为 33,554,432 token,使用 Muon(Jordan 等,2024;Liu 等,2025);嵌入、输出头、归一化、偏置和路由器等排除参数组使用 AdamW(Loshchilov 和 Hutter,2019)。
Stage1 序列长度为 4,096。Stage1-1 从零训练至第 210,000 步(约 7T token);Stage1-2 至第 240,000 步(约 8T);Stage1-3 提供第 345,000 步检查点(约 11.5T)。阶段切换时更新数据混合,RoPE(Su 等,2024)基数依次从 10⁴ 增至 5×10⁵、5×10⁶,遵循面向长上下文的基频调整(Xiong 等,2024)。初始预热 2,000 步后,学习率保持 5×10^-4;Stage1-2、1-3 恢复优化器及训练状态,不再预热。Stage1 使用全局批次负载均衡(Fedus 等,2022;Qiu 等,2025),系数 10^-4;路由器 z-loss(Zoph 等,2022)系数 10^-3。
Stage2 将长度扩至 32,768,配置 3,000 步(约 100B token)。Stage3 扩至 262,144,配置 6,000 步(约 200B)。二者保持 RoPE 基数 5×10⁶,从前一阶段权重初始化,但重置优化器状态,预热 1,000 步,关闭负载均衡与路由器 z-loss 惩罚。Stage2 预热后学习率为 5×10^-4;Stage3 以余弦衰减至 5×10^-5,并启用长度感知打包。三大阶段合计约 11.8T token。
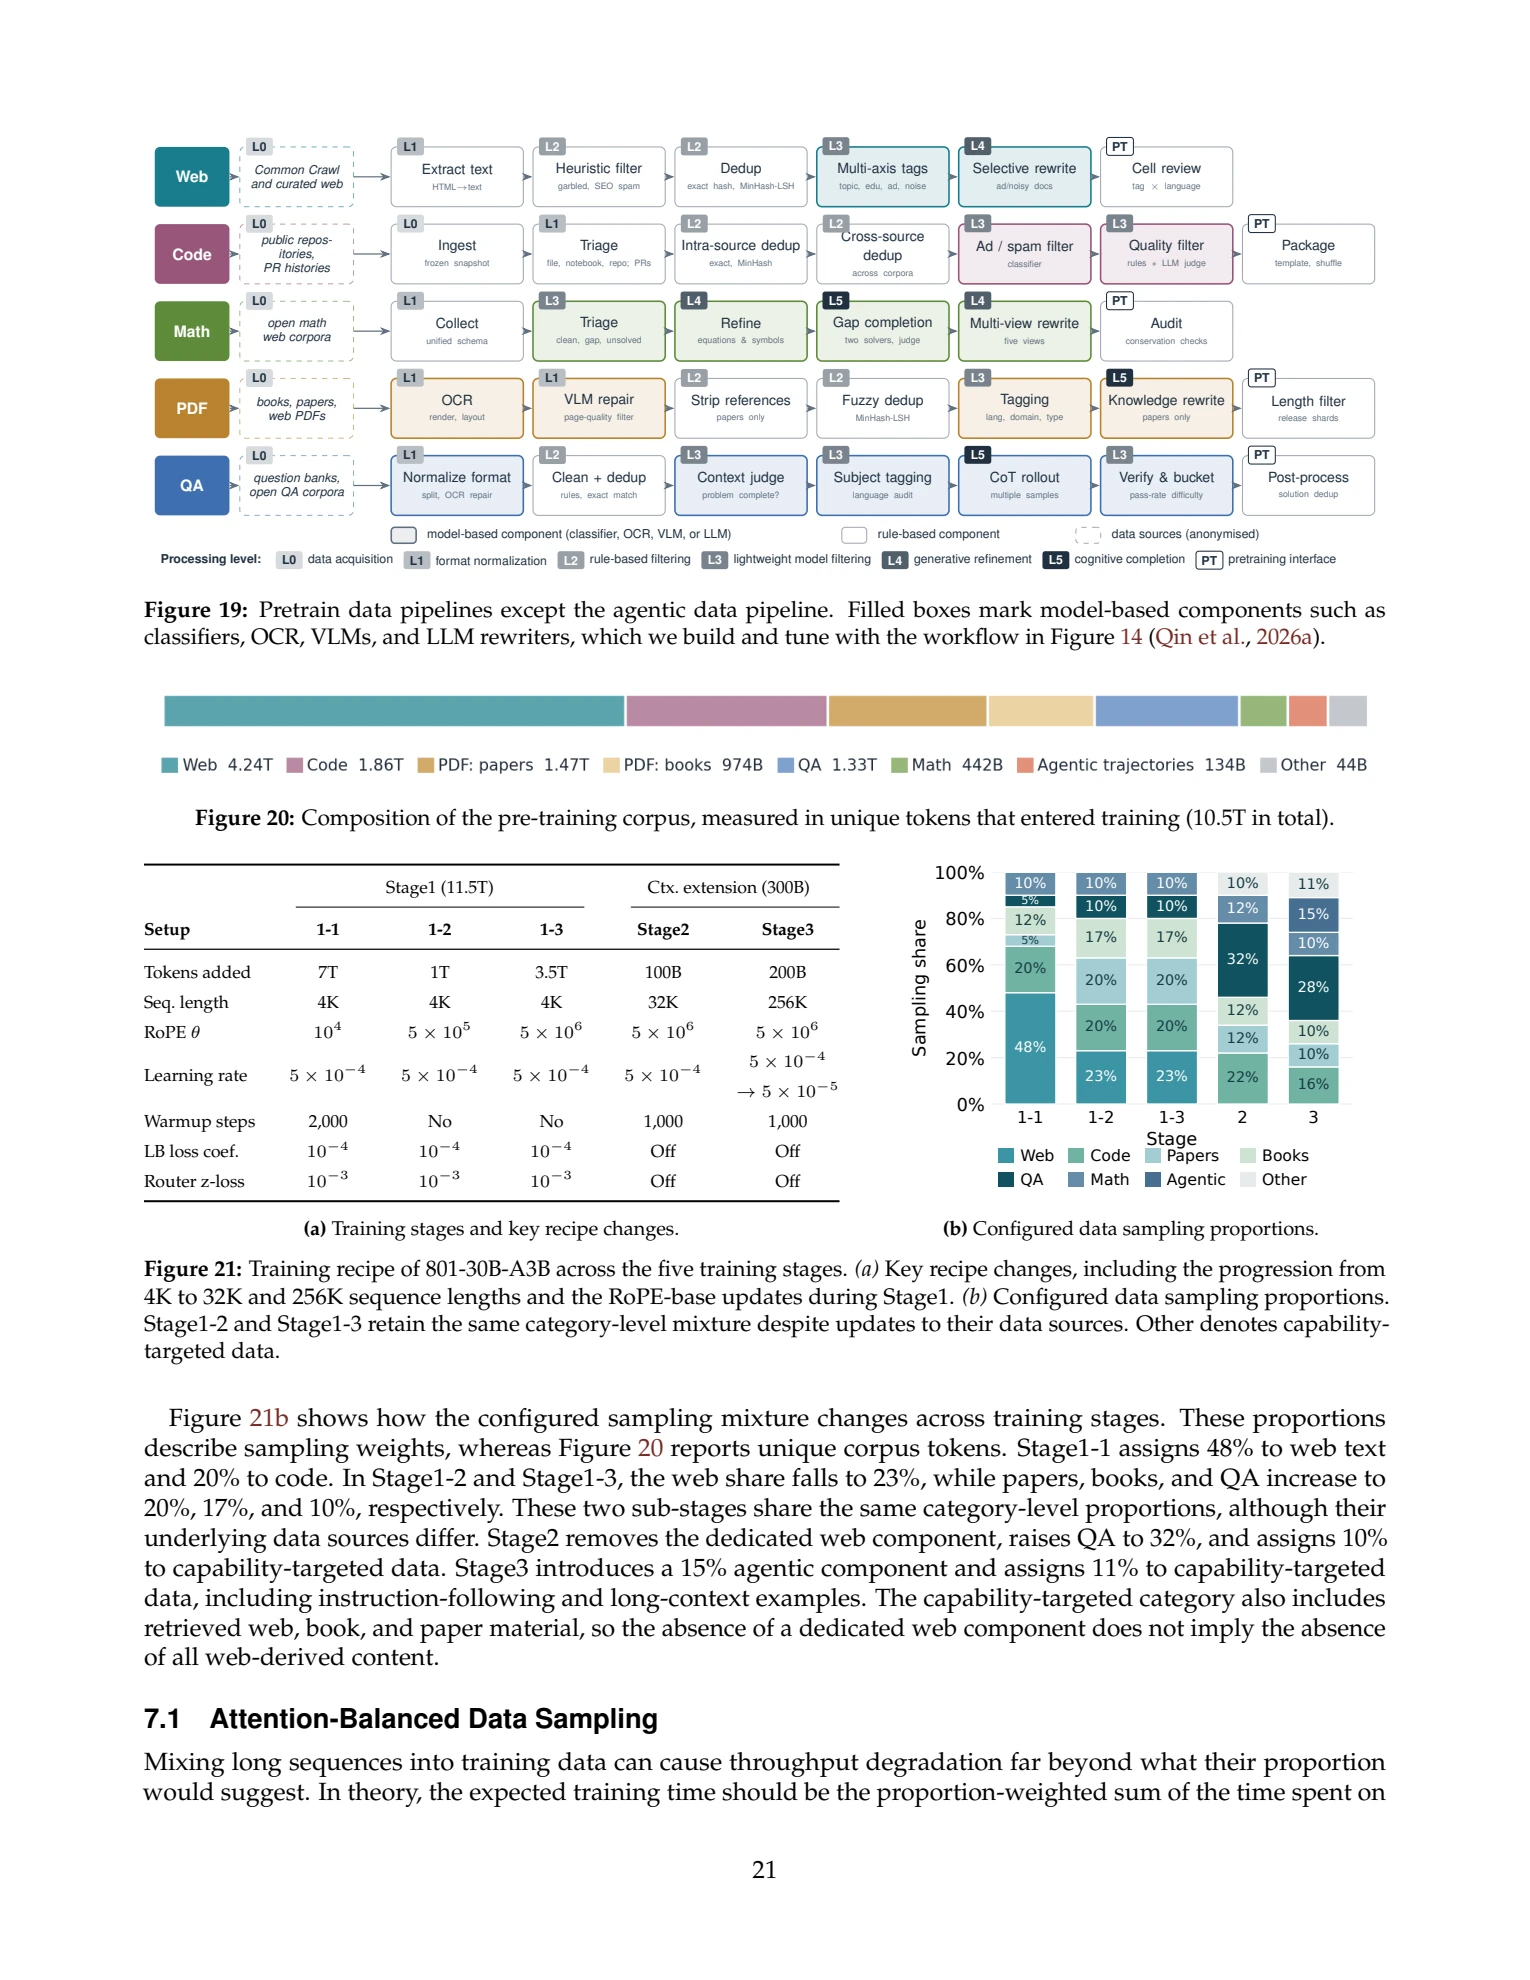
训练语料包含网页文本、PDF、问答对、代码仓库和智能体轨迹(图 20)。除了第 6 节的智能体流水线,各大类还分出子流水线(图 19)。网页按广告存在性、内容标签、领域与语言交叉分类,生成笛卡尔积细粒度单元,作为审查和混合调节的最小单位。数学通过模型改写增加多样性、完善公式符号。PDF 经过 OCR、视觉语言模型(VLM)修复 OCR 错误及多级质量过滤。QA 判断问题上下文是否完整,生成思维链并监控通过率以探测难度。代码包括静态文件与 PR 记录。
第 21 页|数据流水线与采样比例
中文译文 · 对应英文原报告第 21 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
图 19:除智能体数据之外的预训练流水线。实心框为分类器、OCR、VLM、LLM 改写器等模型组件,使用图 14 的流程构建与调优(Qin 等,2026a)。
网页:CommonCrawl 与精选网页→HTML 提取文本→启发式过滤(乱码、SEO 垃圾)→去重(精确哈希、MinHash-LSH)→多维标签(主题、教育性、广告、噪声)→选择性改写(广告/噪声文档)→标签×语言单元审查。
代码:公开仓库和 PR 历史→获取冻结快照→按文件、notebook、仓库及 PR 分流→源内去重(精确、MinHash)→跨来源去重→广告/垃圾分类过滤→质量过滤(规则+LLM 评判)→模板化、打乱与打包。
数学:开放数学语料及网页语料→统一模式收集→分类(干净、缺失、未解决)→公式符号修整→缺口补全(两个求解器及评判器)→五种视角改写→内容保真审计。
PDF:图书、论文、网页 PDF→OCR(渲染、版面)→VLM 修复及页面质量过滤→去参考文献(仅论文)→MinHash-LSH 模糊去重→语言/领域/类型标签→知识改写(仅论文)→长度过滤并输出分片。
QA:题库与开放 QA→格式规范化(拆分、OCR 修复)→规则清洗和精确去重→上下文完整性判断→学科标注及语言审查→多样本思维链生成→验证、按通过率难度分桶→解答去重等后处理。
层级:L0 数据获取;L1 格式规范化;L2 规则过滤;L3 轻量模型过滤;L4 生成式优化;L5 认知补全;PT 预训练接口。
图 20:进入训练的唯一 token 构成,总计 10.5T。网页 4.24T、代码 1.86T、PDF 论文 1.47T、PDF 图书 974B、QA 1.33T、数学 442B、智能体轨迹 134B、其他 44B。
图 21:五个阶段的训练配方。(a) 关键参数变化,序列长度 4K→32K→256K,Stage1 更新 RoPE 基数。(b) 配置的数据采样比例。Stage1-2 和 1-3 虽更新来源,但大类比例相同。Other 指面向特定能力的数据。
五阶段新增 token 依次为 7T、1T、3.5T、100B、200B;长度为 4K、4K、4K、32K、256K;预热步数为 2,000、无、无、1,000、1,000。Stage1 三段均采用 10^-4 负载均衡系数与 10^-3 路由器 z-loss,后两段关闭。
图 21b 表示采样权重,而图 20 表示唯一语料 token。Stage1-1 网页占 48%,代码占 20%。Stage1-2、1-3 网页降至 23%,论文、图书、QA 分别增至 20%、17%、10%;大类比例相同,但底层来源不同。Stage2 移除独立网页类别,QA 增至 32%,能力定向数据为 10%。Stage3 加入 15% 智能体数据,能力定向数据为 11%,包括指令遵循和长上下文样本。能力定向数据也含检索来的网页、图书与论文,因此没有独立网页类别并不表示完全没有网页来源内容。
7.1 注意力负载均衡的数据采样
混入长序列可能导致远超其占比的吞吐下降。理论上,预期训练时间应是长短样本耗时按比例加权的和;实际中,仅加入 10% 长样本就可能使训练速度减半。
第 22 页|注意力均衡数据采样
中文译文 · 对应英文原报告第 22 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
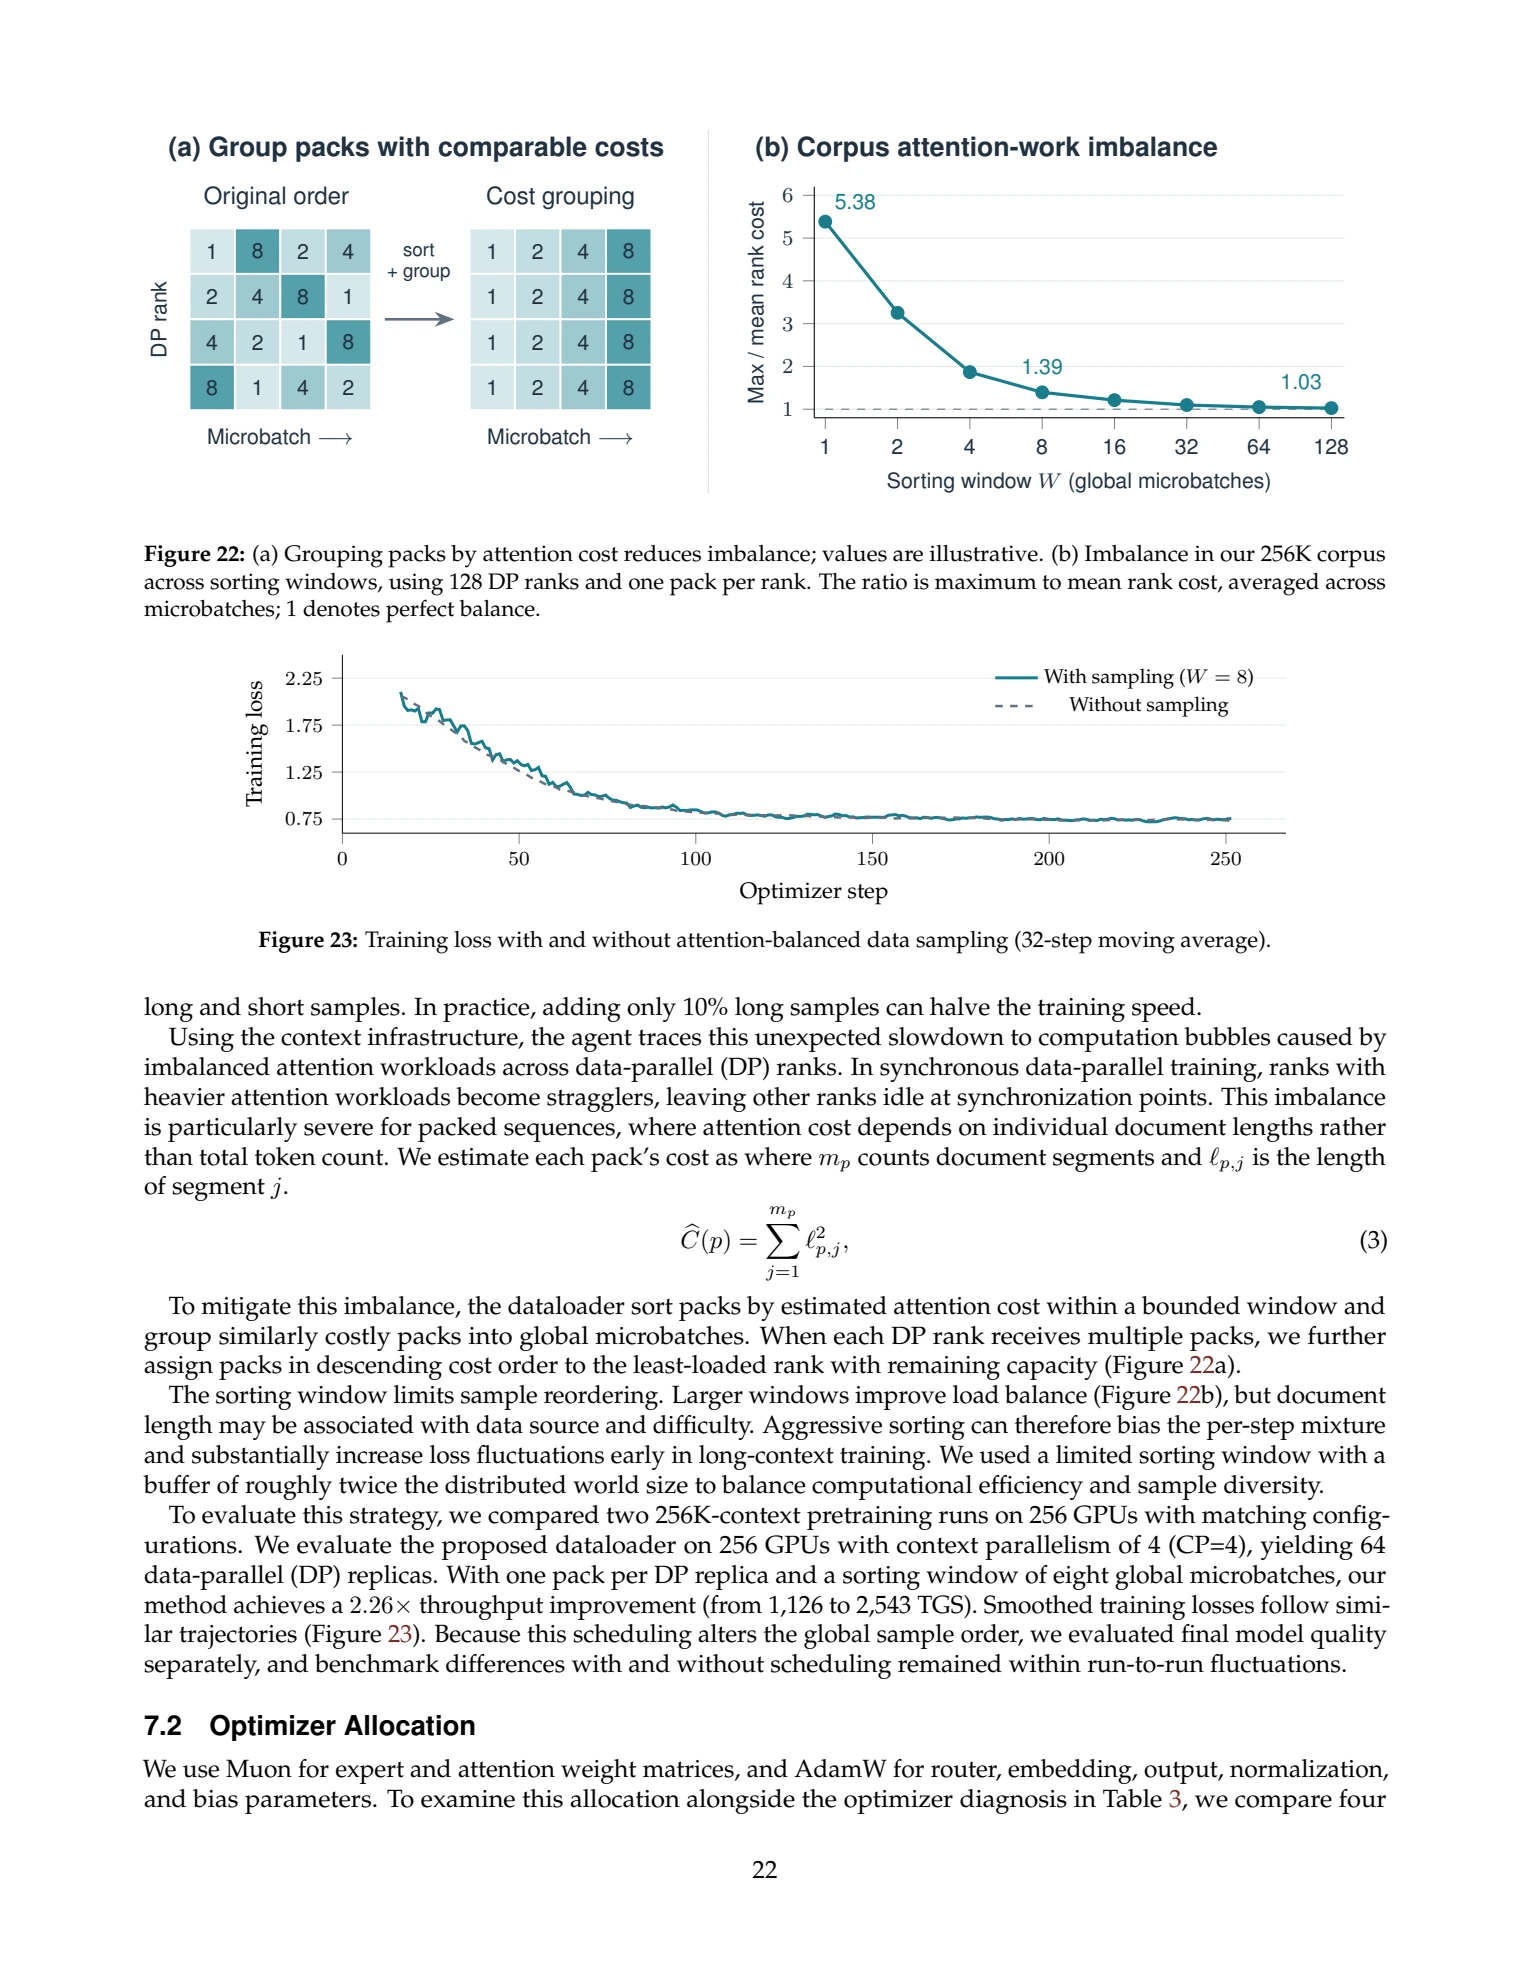
图 22:(a) 按注意力计算成本将打包序列分组,可减少不均衡;数值仅示意。(b) 256K 语料在不同排序窗口下的不均衡,使用 128 个 DP rank,每个 rank 一个包。指标为每个微批次最大 rank 成本/平均成本,再跨微批次求平均;1 为完全均衡。横轴是按全局微批次数计的排序窗口 W,示例比值从 5.38 降至 1.39,最终约 1.03。
图 23:有、无注意力均衡采样的训练损失,采用 32 步移动平均;采样窗口 W=8,横轴为优化器步数。
借助上下文基础设施,智能体将意外减速追溯到 DP rank 间注意力负载不均衡引起的计算空泡。同步数据并行中,注意力工作较重的 rank 成为慢节点,其他 rank 在同步点空等。打包序列尤其严重,因为注意力成本取决于单个文档长度,而非总 token 数。每个包的估计成本为:
Ĉ(p) = Σ(j=1…m_p) ℓ²_(p,j) (3)
m_p 为文档片段数,ℓ_(p,j) 为第 j 个片段长度。
为减轻失衡,数据加载器在有限窗口中按估计成本排序,将成本接近的包组成全局微批次。每个 DP rank 接收多个包时,再按成本降序,将包分配给尚有容量且负载最轻的 rank(图 22a)。
排序窗口限制样本重排范围。窗口越大,负载越均衡(图 22b),但文档长度可能与来源、难度相关,激进排序会改变每一步的数据混合,并明显增大长上下文训练初期的损失波动。我们采用有限窗口,缓冲区约为分布式 world size 的两倍,兼顾计算效率和样本多样性。
我们在 256 张 GPU 上比较两次其他配置匹配的 256K 上下文预训练。上下文并行为 4(CP=4),因此有 64 个 DP 副本,每副本一个包,排序窗口为八个全局微批次。吞吐从 1,126 提升到 2,543 TGS,提高 2.26 倍。平滑损失轨迹相近(图 23)。由于调度改变全局样本顺序,我们单独评估最终模型质量,基准差异仍在不同训练运行间的波动范围内。
7.2 优化器分配
专家和注意力权重矩阵使用 Muon;路由器、嵌入、输出、归一化和偏置参数使用 AdamW。结合表 3 中的优化器诊断,我们比较了第二次试训中的四种配置(表 5)。
第 23 页|优化器比较与评估概览
中文译文 · 对应英文原报告第 23 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
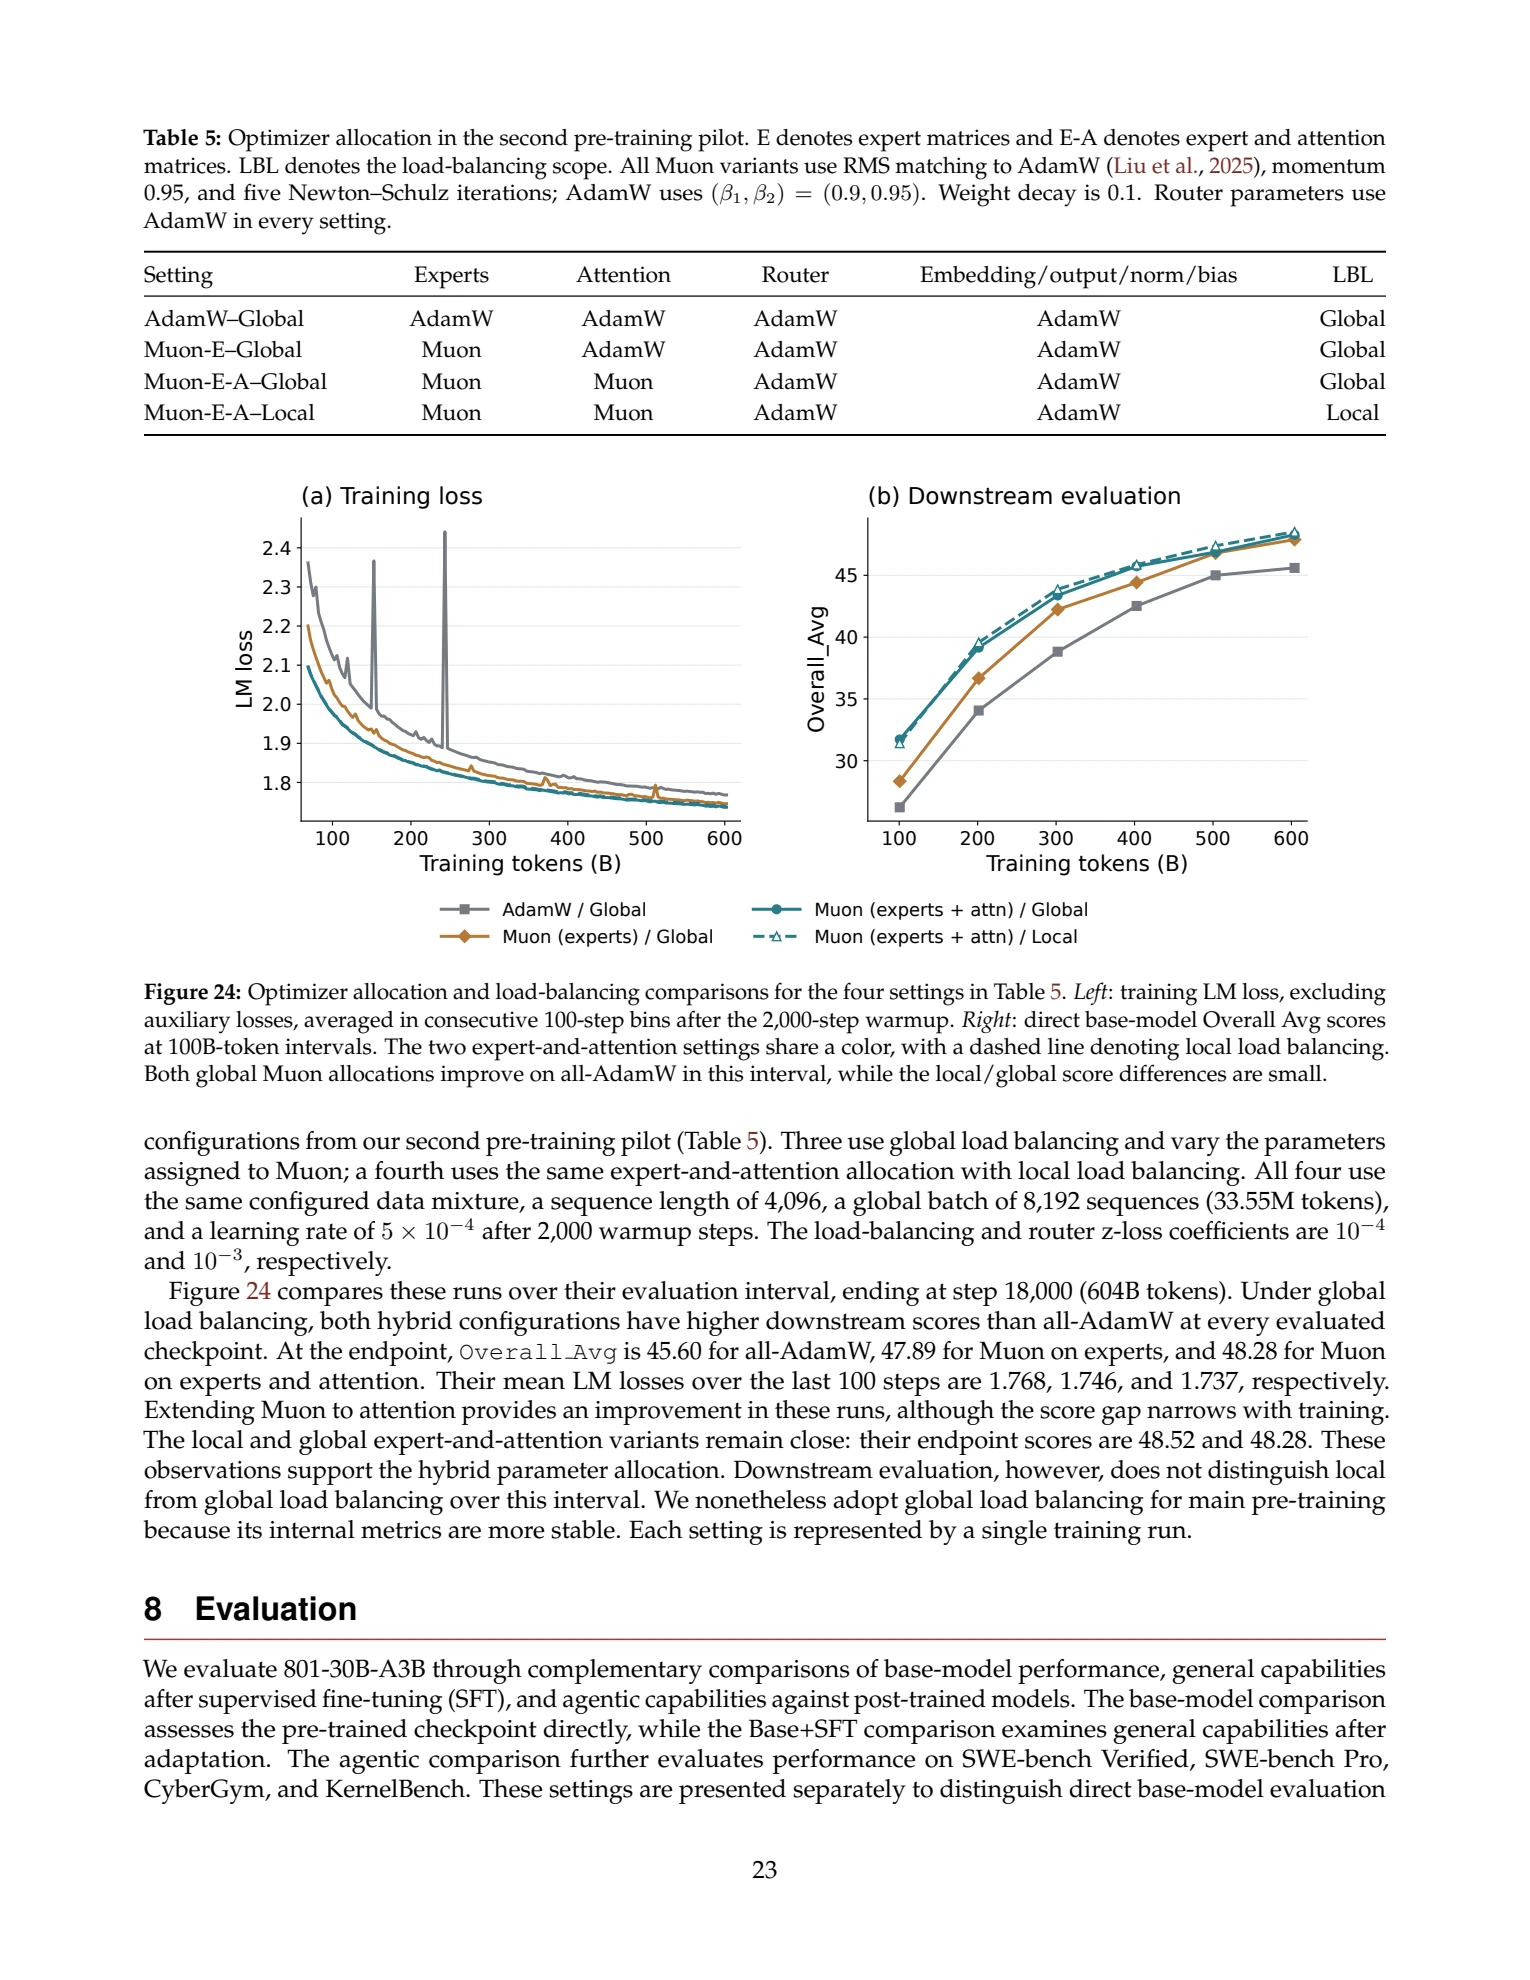
表 5:第二次预训练试训的优化器分配。E 为专家矩阵,E-A 为专家与注意力矩阵,LBL 为负载均衡范围。全部 Muon 变体采用与 AdamW 的 RMS 匹配(Liu 等,2025),动量 0.95,Newton–Schulz 迭代 5 次;AdamW 的 (β₁,β₂)=(0.9,0.95),权重衰减 0.1。所有配置的路由器均用 AdamW。
AdamW–Global:全部参数用 AdamW,全局均衡。
Muon-E–Global:专家用 Muon,其余用 AdamW,全局均衡。
Muon-E-A–Global:专家和注意力用 Muon,其余用 AdamW,全局均衡。
Muon-E-A–Local:专家和注意力用 Muon,其余用 AdamW,局部均衡。
图 24:四种配置的优化器与负载均衡比较。左图为排除辅助损失的 LM 损失,2,000 步预热后按连续 100 步分箱平均;右图为每 100B token 的基础模型 Overall_Avg。专家加注意力的两种配置同色,虚线表示局部均衡。两种全局 Muon 分配在此区间均优于全 AdamW,而局部/全局分数差异较小。
三种配置采用全局均衡并改变 Muon 的参数分配,第四种采用专家加注意力分配与局部均衡。四者数据混合一致,长度 4,096,全局批次 8,192 条序列(33.55M token),预热 2,000 步后学习率 5×10^-4;负载均衡与路由器 z-loss 系数分别为 10^-4、10^-3。
比较区间止于第 18,000 步(604B token)。全局均衡下,两种混合优化器在全部受评检查点的下游分数均高于全 AdamW。终点 Overall_Avg 分别为:全 AdamW 45.60、仅专家 Muon 47.89、专家加注意力 Muon 48.28;最后 100 步平均 LM 损失依次为 1.768、1.746、1.737。将 Muon 扩到注意力矩阵带来改善,但分数差距随训练缩小。
专家加注意力的局部/全局变体接近,终点分数为 48.52/48.28。这些观察支持混合参数分配;但在此区间内,下游评估无法明确区分局部与全局均衡。我们仍在主训练中选用全局均衡,因为其内部指标更稳定。每种设置仅有一次训练运行。
8 评估
我们从基础模型表现、SFT 后通用能力,以及与后训练模型比较的智能体能力三个互补角度评估 801-30B-A3B。基础比较直接测预训练检查点;Base+SFT 比较适应后的通用能力;智能体比较使用 SWE-bench Verified、SWE-bench Pro、CyberGym、KernelBench。分别呈现这些设置,以区分直接基础评估与适应后的下游表现。
第 24 页|基础模型评估设置
中文译文 · 对应英文原报告第 24 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
受当前资源和时间限制,初步评估与优化集中于本节设置,特别是智能体任务。未来将扩大任务覆盖,提供更全面的评估支持。
8.1 评估设置
8.1.1 基础评估设置
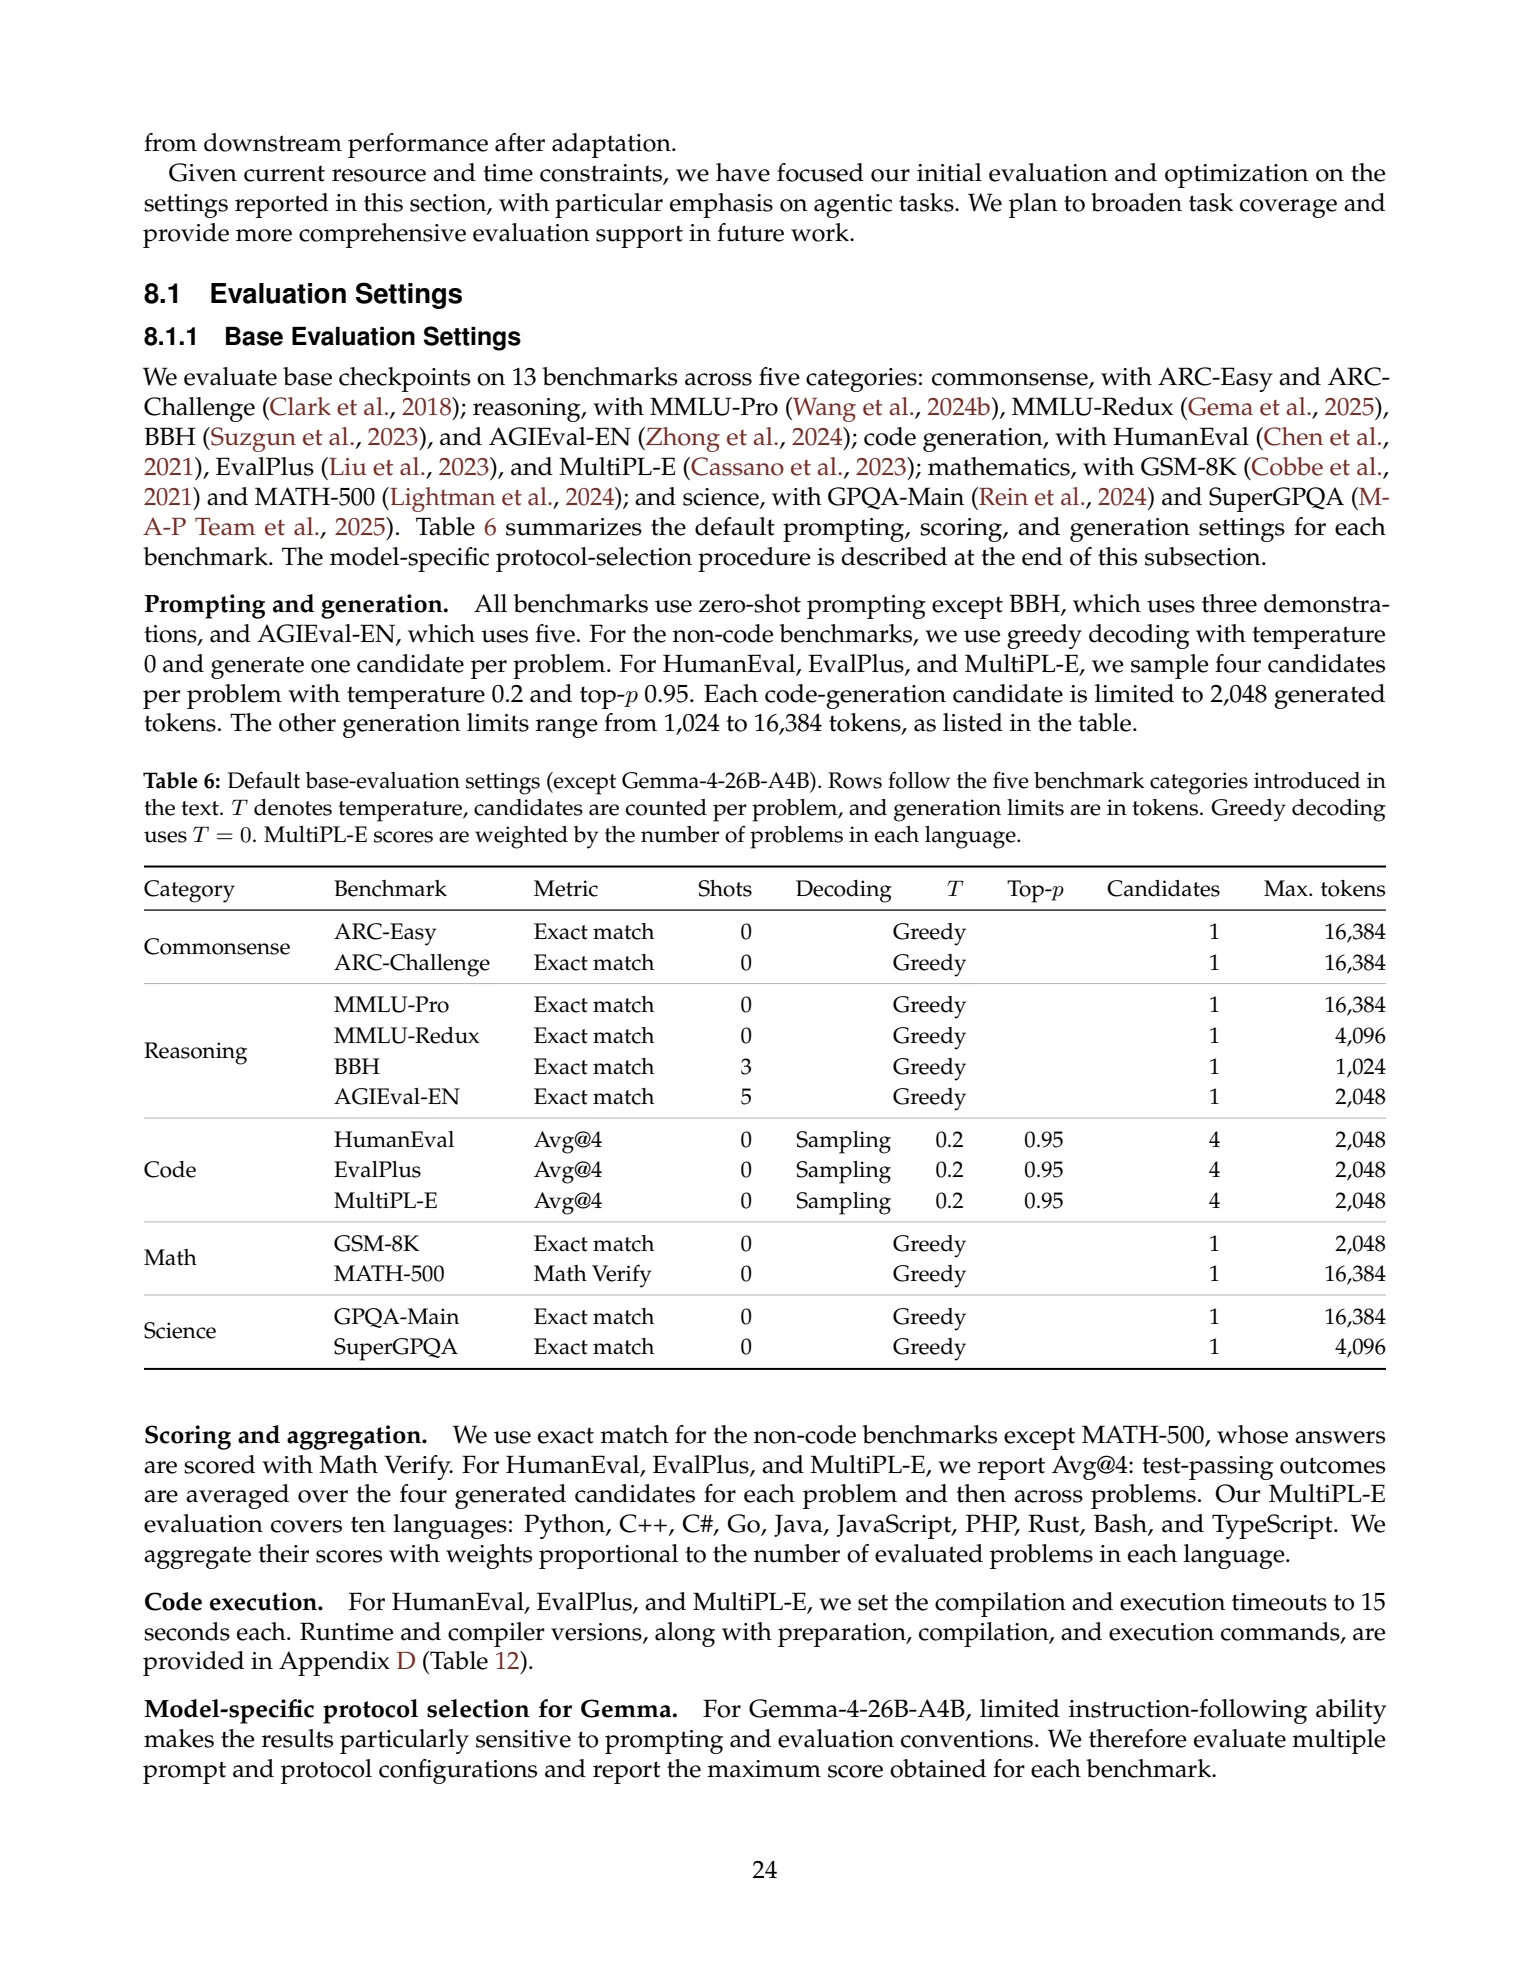
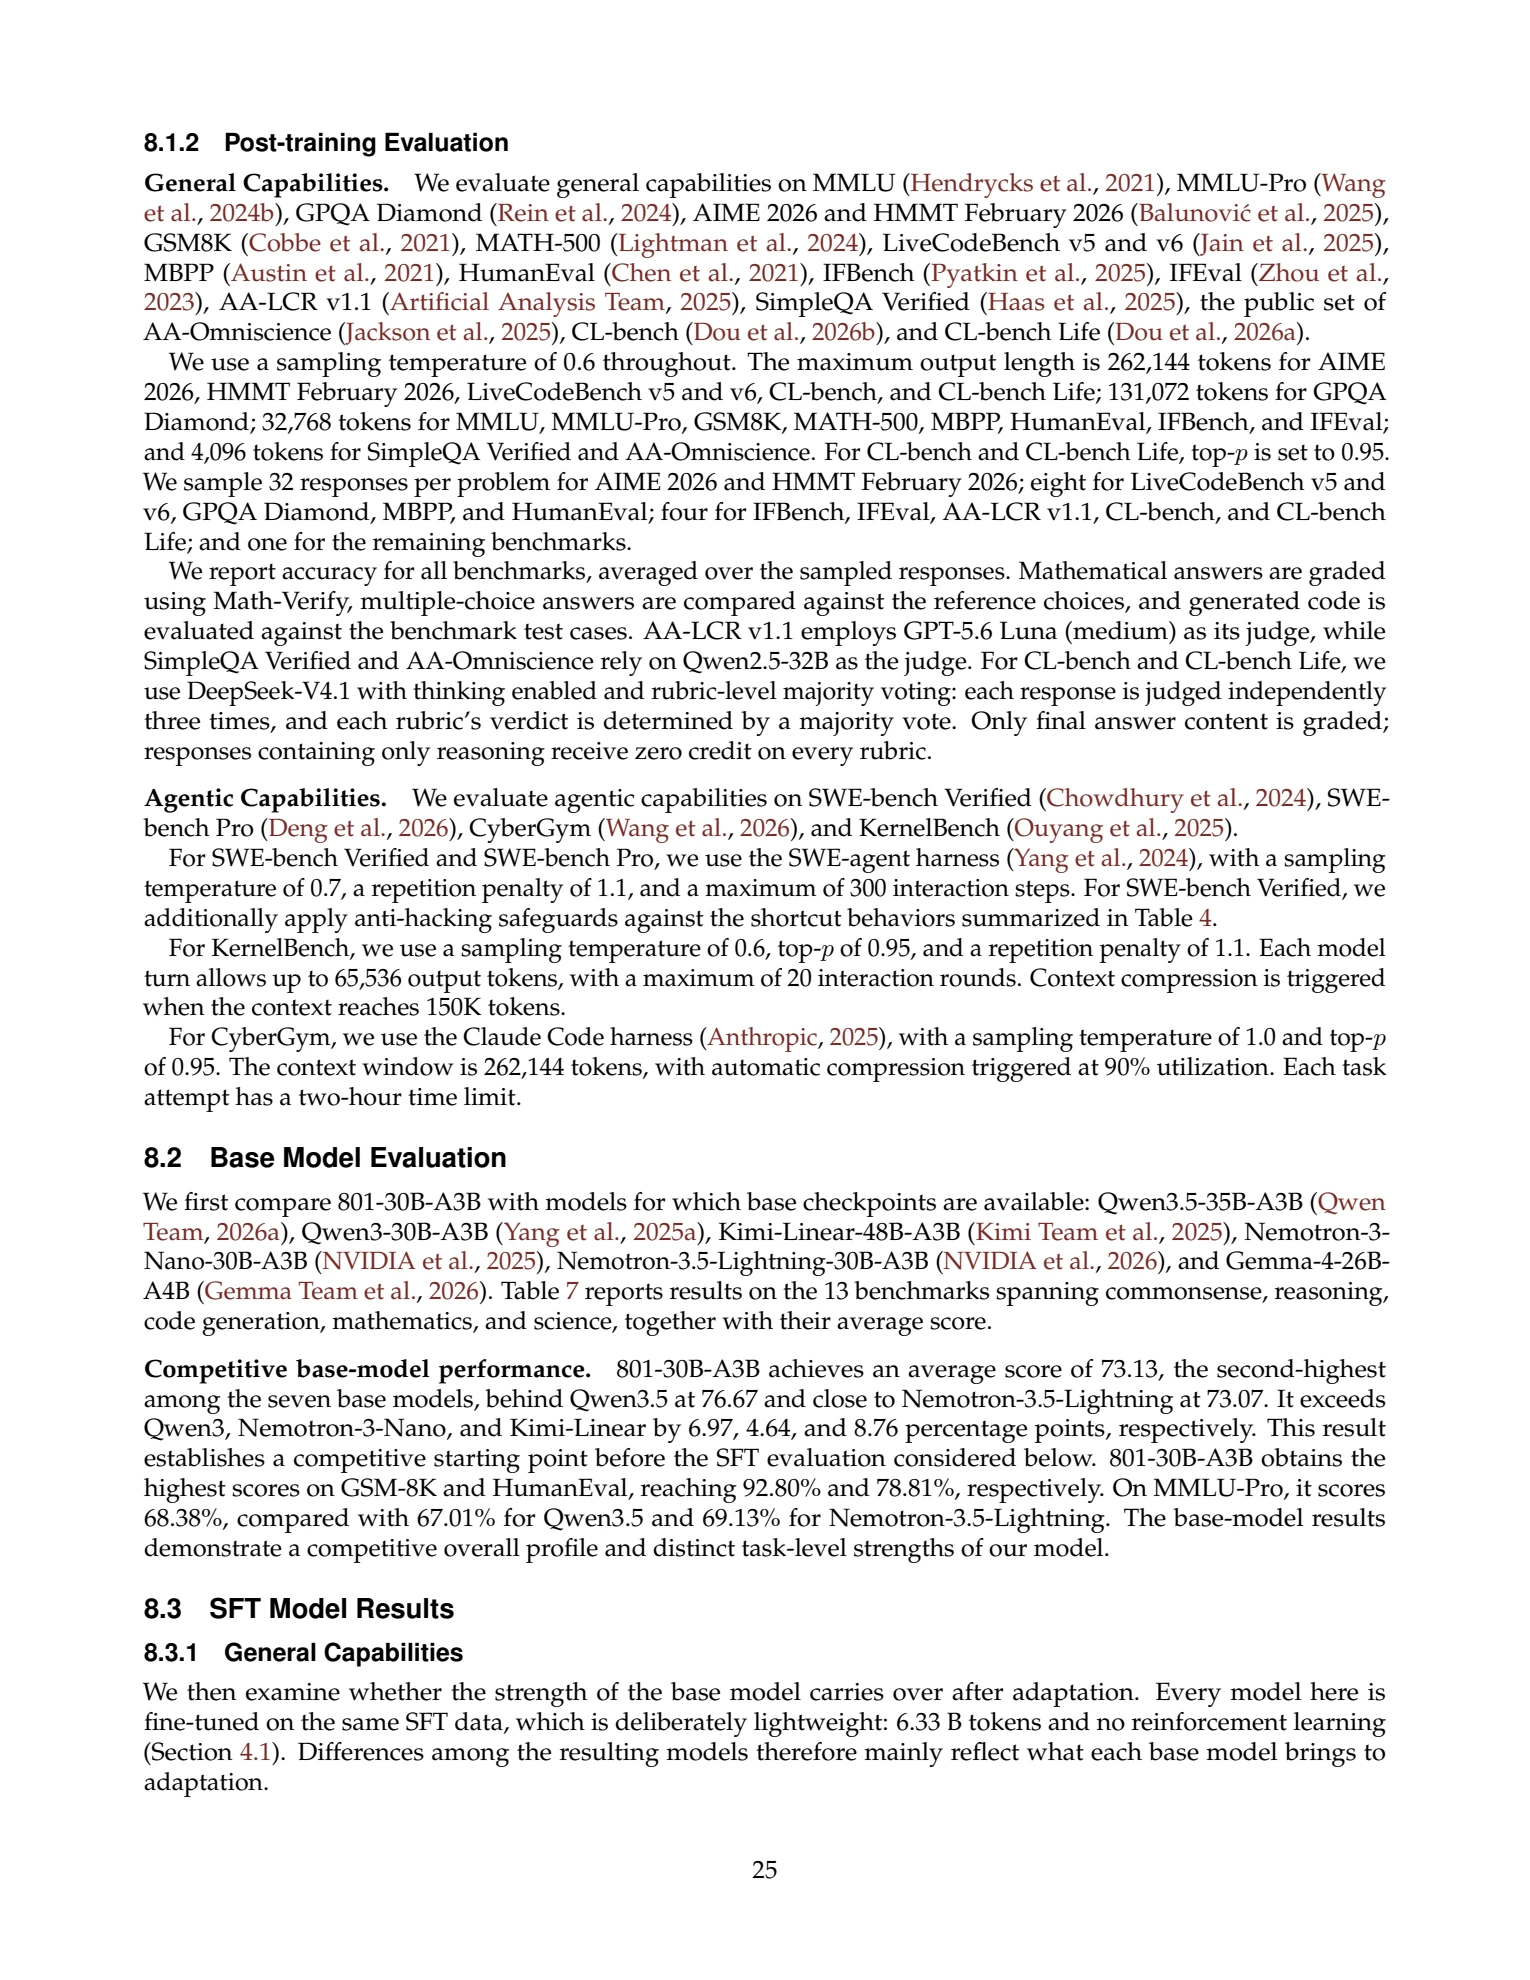
在五类 13 项基准上评估基础检查点:常识类 ARC-Easy、ARC-Challenge(Clark 等,2018);推理类 MMLU-Pro(Wang 等,2024b)、MMLU-Redux(Gema 等,2025)、BBH(Suzgun 等,2023)、AGIEval-EN(Zhong 等,2024);代码类 HumanEval(Chen 等,2021)、EvalPlus(Liu 等,2023)、MultiPL-E(Cassano 等,2023);数学类 GSM8K(Cobbe 等,2021)、MATH-500(Lightman 等,2024);科学类 GPQA-Main(Rein 等,2024)、SuperGPQA(M-A-P Team 等,2025)。表 6 列默认提示、评分和生成设置,模型专属协议选择见本小节末尾。
提示与生成。除 BBH 用 3 个示例、AGIEval-EN 用 5 个示例外,均为零样本。非代码基准采用温度 0 的贪婪解码,每题一个候选。三项代码基准温度 0.2、top-p 0.95,每题采样四个候选,各最多 2,048 个输出 token。其他生成上限为 1,024—16,384,详见表 6。
表 6:默认基础评估设置(Gemma-4-26B-A4B 除外)。表头:类别、基准、指标、示例数、解码方式、温度 T、Top-p、每题候选数、最大 token。贪婪解码 T=0。
ARC-Easy、ARC-Challenge:精确匹配,0-shot,贪婪,1 个候选,16,384。
MMLU-Pro:精确匹配,0-shot,贪婪,1 个,16,384。
MMLU-Redux:精确匹配,0-shot,贪婪,1 个,4,096。
BBH:精确匹配,3-shot,贪婪,1 个,1,024。
AGIEval-EN:精确匹配,5-shot,贪婪,1 个,2,048。
HumanEval、EvalPlus、MultiPL-E:Avg@4,0-shot,采样,T=0.2,top-p=0.95,4 个,2,048。
GSM8K:精确匹配,0-shot,贪婪,1 个,2,048。
MATH-500:MathVerify,0-shot,贪婪,1 个,16,384。
GPQA-Main:精确匹配,0-shot,贪婪,1 个,16,384。
SuperGPQA:精确匹配,0-shot,贪婪,1 个,4,096。
评分与汇总。除 MATH-500 用 MathVerify 外,非代码均精确匹配。代码报告 Avg@4:每题四个候选的测试通过结果先平均,再跨题平均。MultiPL-E 覆盖 Python、C++、C#、Go、Java、JavaScript、PHP、Rust、Bash、TypeScript 十种语言,按各语言受评题数加权。
代码执行。三项代码评估的编译与执行超时分别为 15 秒;运行时、编译器版本及准备、编译、执行命令见附录 D 表 12。
Gemma 的专属协议选择。Gemma-4-26B-A4B 的指令遵循能力有限,结果对提示和评估惯例尤其敏感,因此评估多个提示/协议配置,并对每个基准报告最高分。
第 25 页|后训练评估与采样配置
中文译文 · 对应英文原报告第 25 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
8.1.2 后训练评估
通用能力。评估 MMLU(Hendrycks 等,2021)、MMLU-Pro(Wang 等,2024b)、GPQA Diamond(Rein 等,2024)、AIME 2026 与 HMMT February 2026(Balunović 等,2025)、GSM8K(Cobbe 等,2021)、MATH-500(Lightman 等,2024)、LiveCodeBench v5/v6(Jain 等,2025)、MBPP(Austin 等,2021)、HumanEval(Chen 等,2021)、IFBench(Pyatkin 等,2025)、IFEval(Zhou 等,2023)、AA-LCR v1.1(Artificial Analysis Team,2025)、SimpleQA Verified(Haas 等,2025)、AA-Omniscience 公开集(Jackson 等,2025)、CL-bench(Dou 等,2026b)、CL-bench Life(Dou 等,2026a)。
采样温度均为 0.6。最大输出:AIME、HMMT、LCB v5/v6、CL-bench 和 CL-bench Life 为 262,144 token;GPQA Diamond 为 131,072;MMLU、MMLU-Pro、GSM8K、MATH-500、MBPP、HumanEval、IFBench、IFEval 为 32,768;SimpleQA Verified 和 AA-Omniscience 为 4,096。两项 CL-bench 的 top-p=0.95。
每题响应数:AIME 和 HMMT 为 32;LCB v5/v6、GPQA Diamond、MBPP、HumanEval 为 8;IFBench、IFEval、AA-LCR v1.1、CL-bench、CL-bench Life 为 4;其他为 1。
各基准报告对采样响应取平均的准确率。数学用 Math-Verify,选择题与参考选项比较,代码运行基准测试。AA-LCR v1.1 用 GPT-5.6 Luna(medium)评判;SimpleQA Verified、AA-Omniscience 用 Qwen2.5-32B;两项 CL-bench 用开启思考的 DeepSeek-V4.1,每个响应独立评判三次、逐评分条目多数投票。只评分最终答案;只有推理内容的响应在所有条目上得零分。
智能体能力。在 SWE-bench Verified(Chowdhury 等,2024)、SWE-bench Pro(Deng 等,2026)、CyberGym(Wang 等,2026)、KernelBench(Ouyang 等,2025)上评估。
两项 SWE-bench 用 SWE-agent(Yang 等,2024),温度 0.7,重复惩罚 1.1,最多交互 300 步;Verified 另针对表 4 捷径采取反作弊措施。
KernelBench:温度 0.6,top-p 0.95,重复惩罚 1.1,每轮最多输出 65,536 token,最多 20 轮;上下文达 150K token 时压缩。
CyberGym:Claude Code(Anthropic,2025),温度 1.0,top-p 0.95,上下文 262,144 token,利用率达 90% 自动压缩;每次任务尝试限时两小时。
8.2 基础模型评估
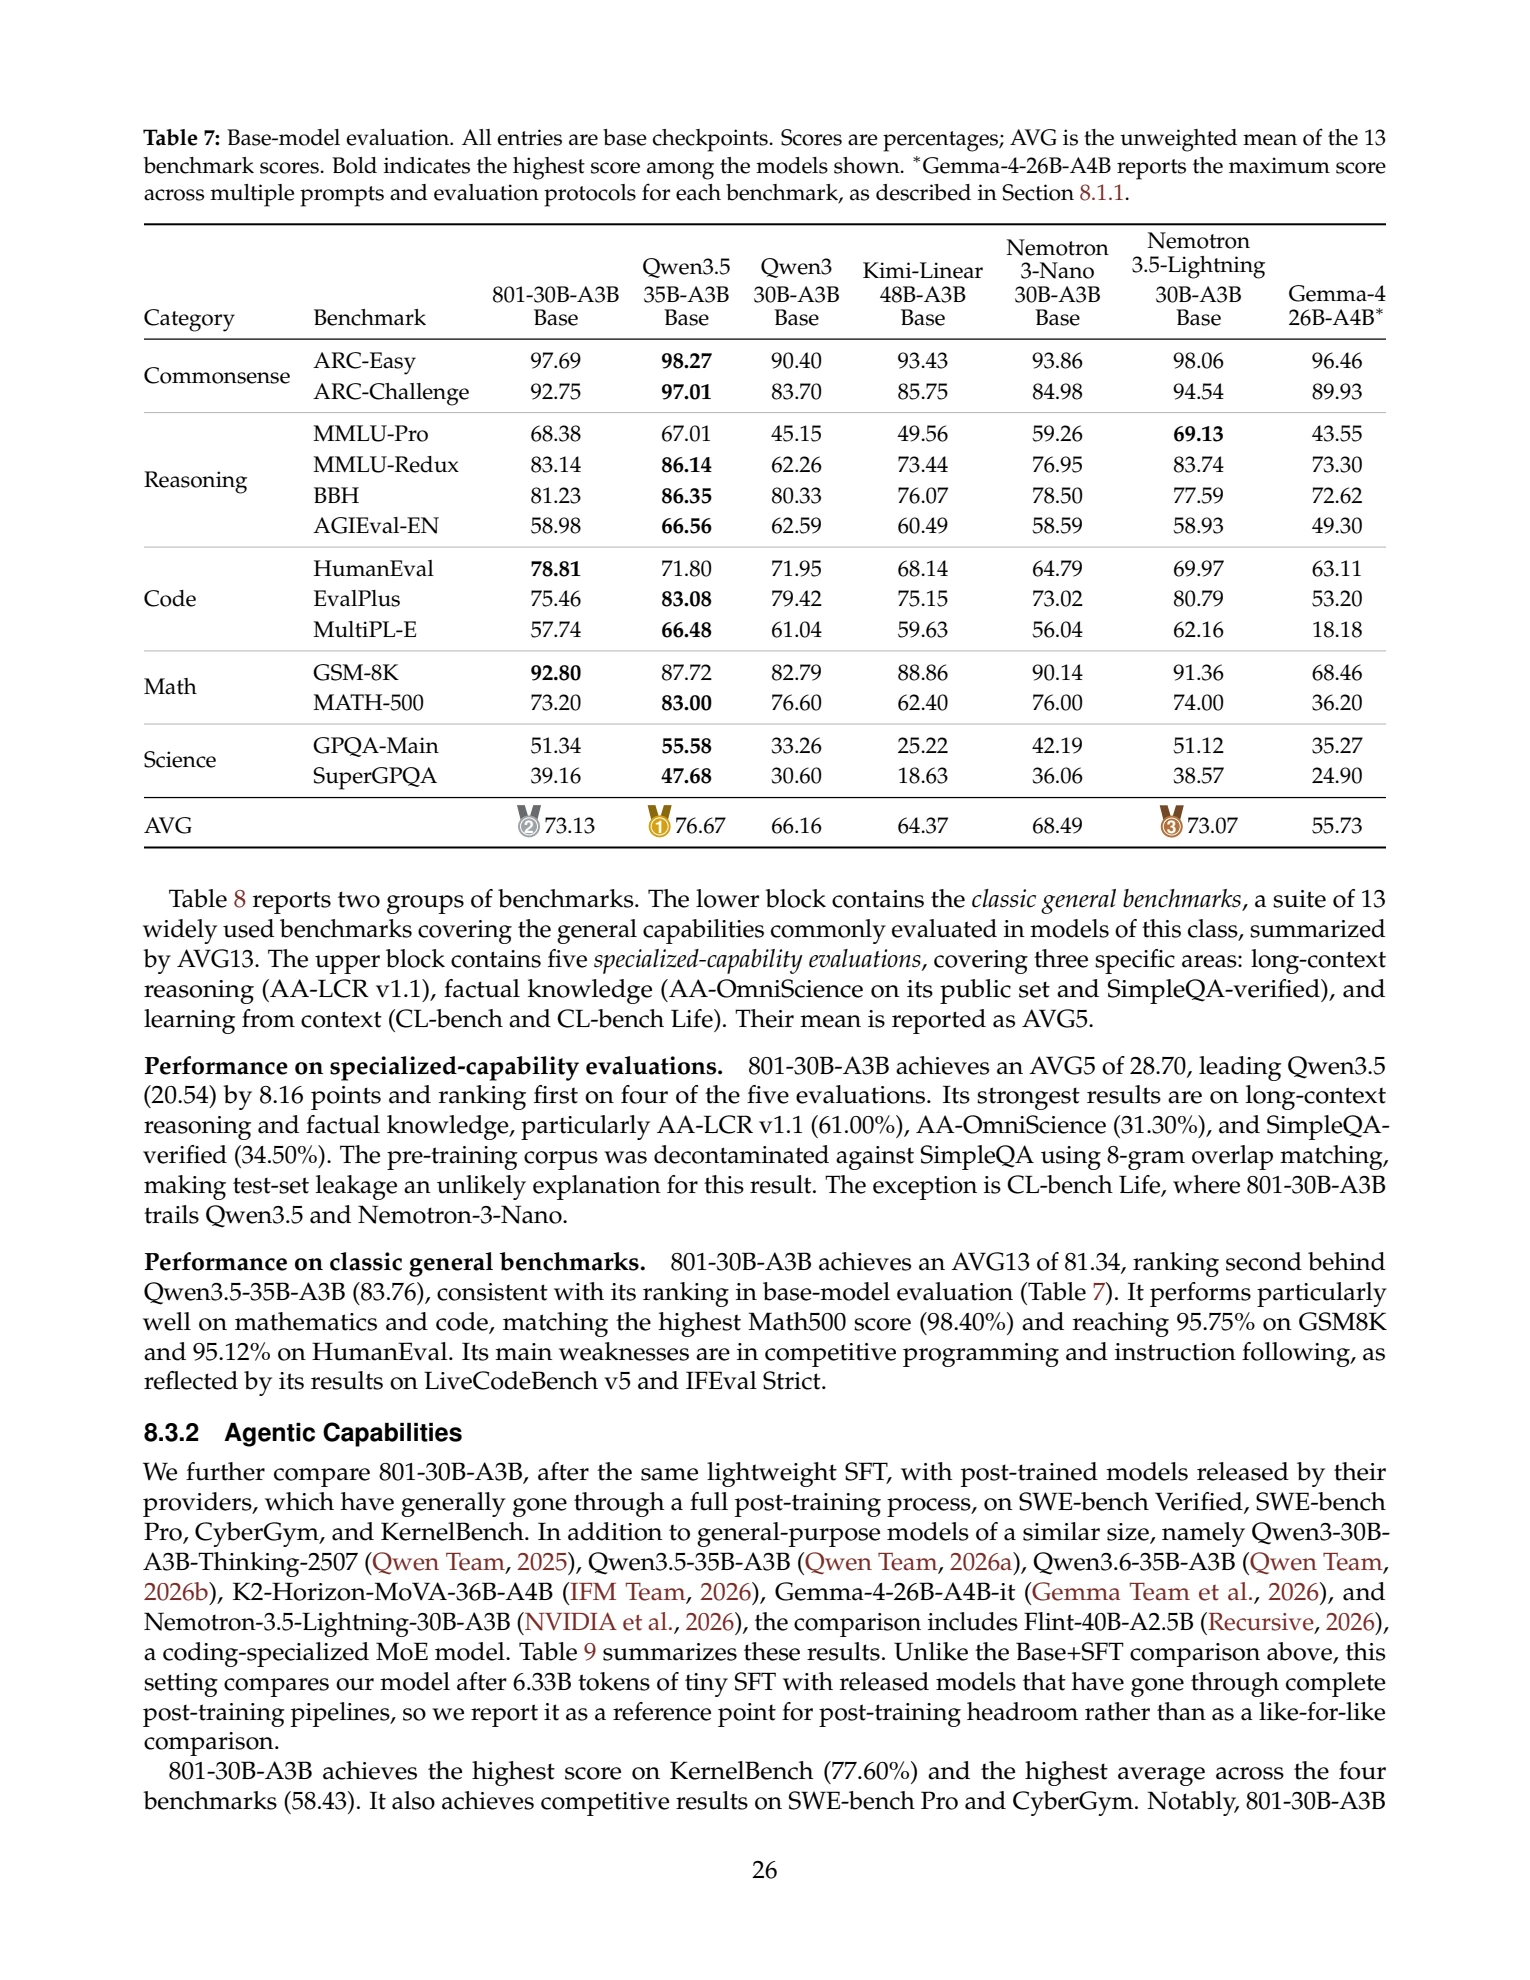
比较有基础检查点的模型:Qwen3.5-35B-A3B、Qwen3-30B-A3B、Kimi-Linear-48B-A3B、Nemotron-3-Nano-30B-A3B、Nemotron-3.5-Lightning-30B-A3B、Gemma-4-26B-A4B。表 7 报告五类 13 项基准及平均分。
有竞争力的基础表现。801 平均 73.13,在七个模型中排第 2,仅次于 Qwen3.5 的 76.67,接近 Nemotron-3.5-Lightning 的 73.07;比 Qwen3、Nemotron-3-Nano、Kimi-Linear 分别高 6.97、4.64、8.76 个百分点。这构成 SFT 前有竞争力的起点。GSM8K 与 HumanEval 获最高分 92.80%、78.81%;MMLU-Pro 为 68.38%,对比 Qwen3.5 的 67.01% 和 Nemotron-3.5-Lightning 的 69.13%。结果显示整体竞争力与不同任务上的优势。
8.3 SFT 模型结果|8.3.1 通用能力
继续检验基础优势是否延续到适应后。所有模型使用相同、刻意保持轻量的 SFT 数据:6.33B token,无 RL(第 4.1 节)。结果差异主要反映各基础模型为适应带来的能力。
第 26 页|基础评估与 SFT 结果
中文译文 · 对应英文原报告第 26 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
表 7:基础模型评估。所有列均为基础检查点,分数单位为百分比;AVG 为 13 项基准的非加权平均,粗体为各行最佳。Gemma* 按第 8.1.1 节逐基准报告多个提示/协议的最大值。原始逐项数据完整保留在左栏原文。
类别依次为常识、推理、代码、数学、科学。模型平均分:801-30B-A3B 73.13(第 2);Qwen3.5-35B-A3B 76.67(第 1);Qwen3-30B-A3B 66.16;Kimi-Linear-48B-A3B 64.37;Nemotron-3-Nano-30B-A3B 68.49;Nemotron-3.5-Lightning-30B-A3B 73.07(第 3);Gemma-4-26B-A4B 55.73。
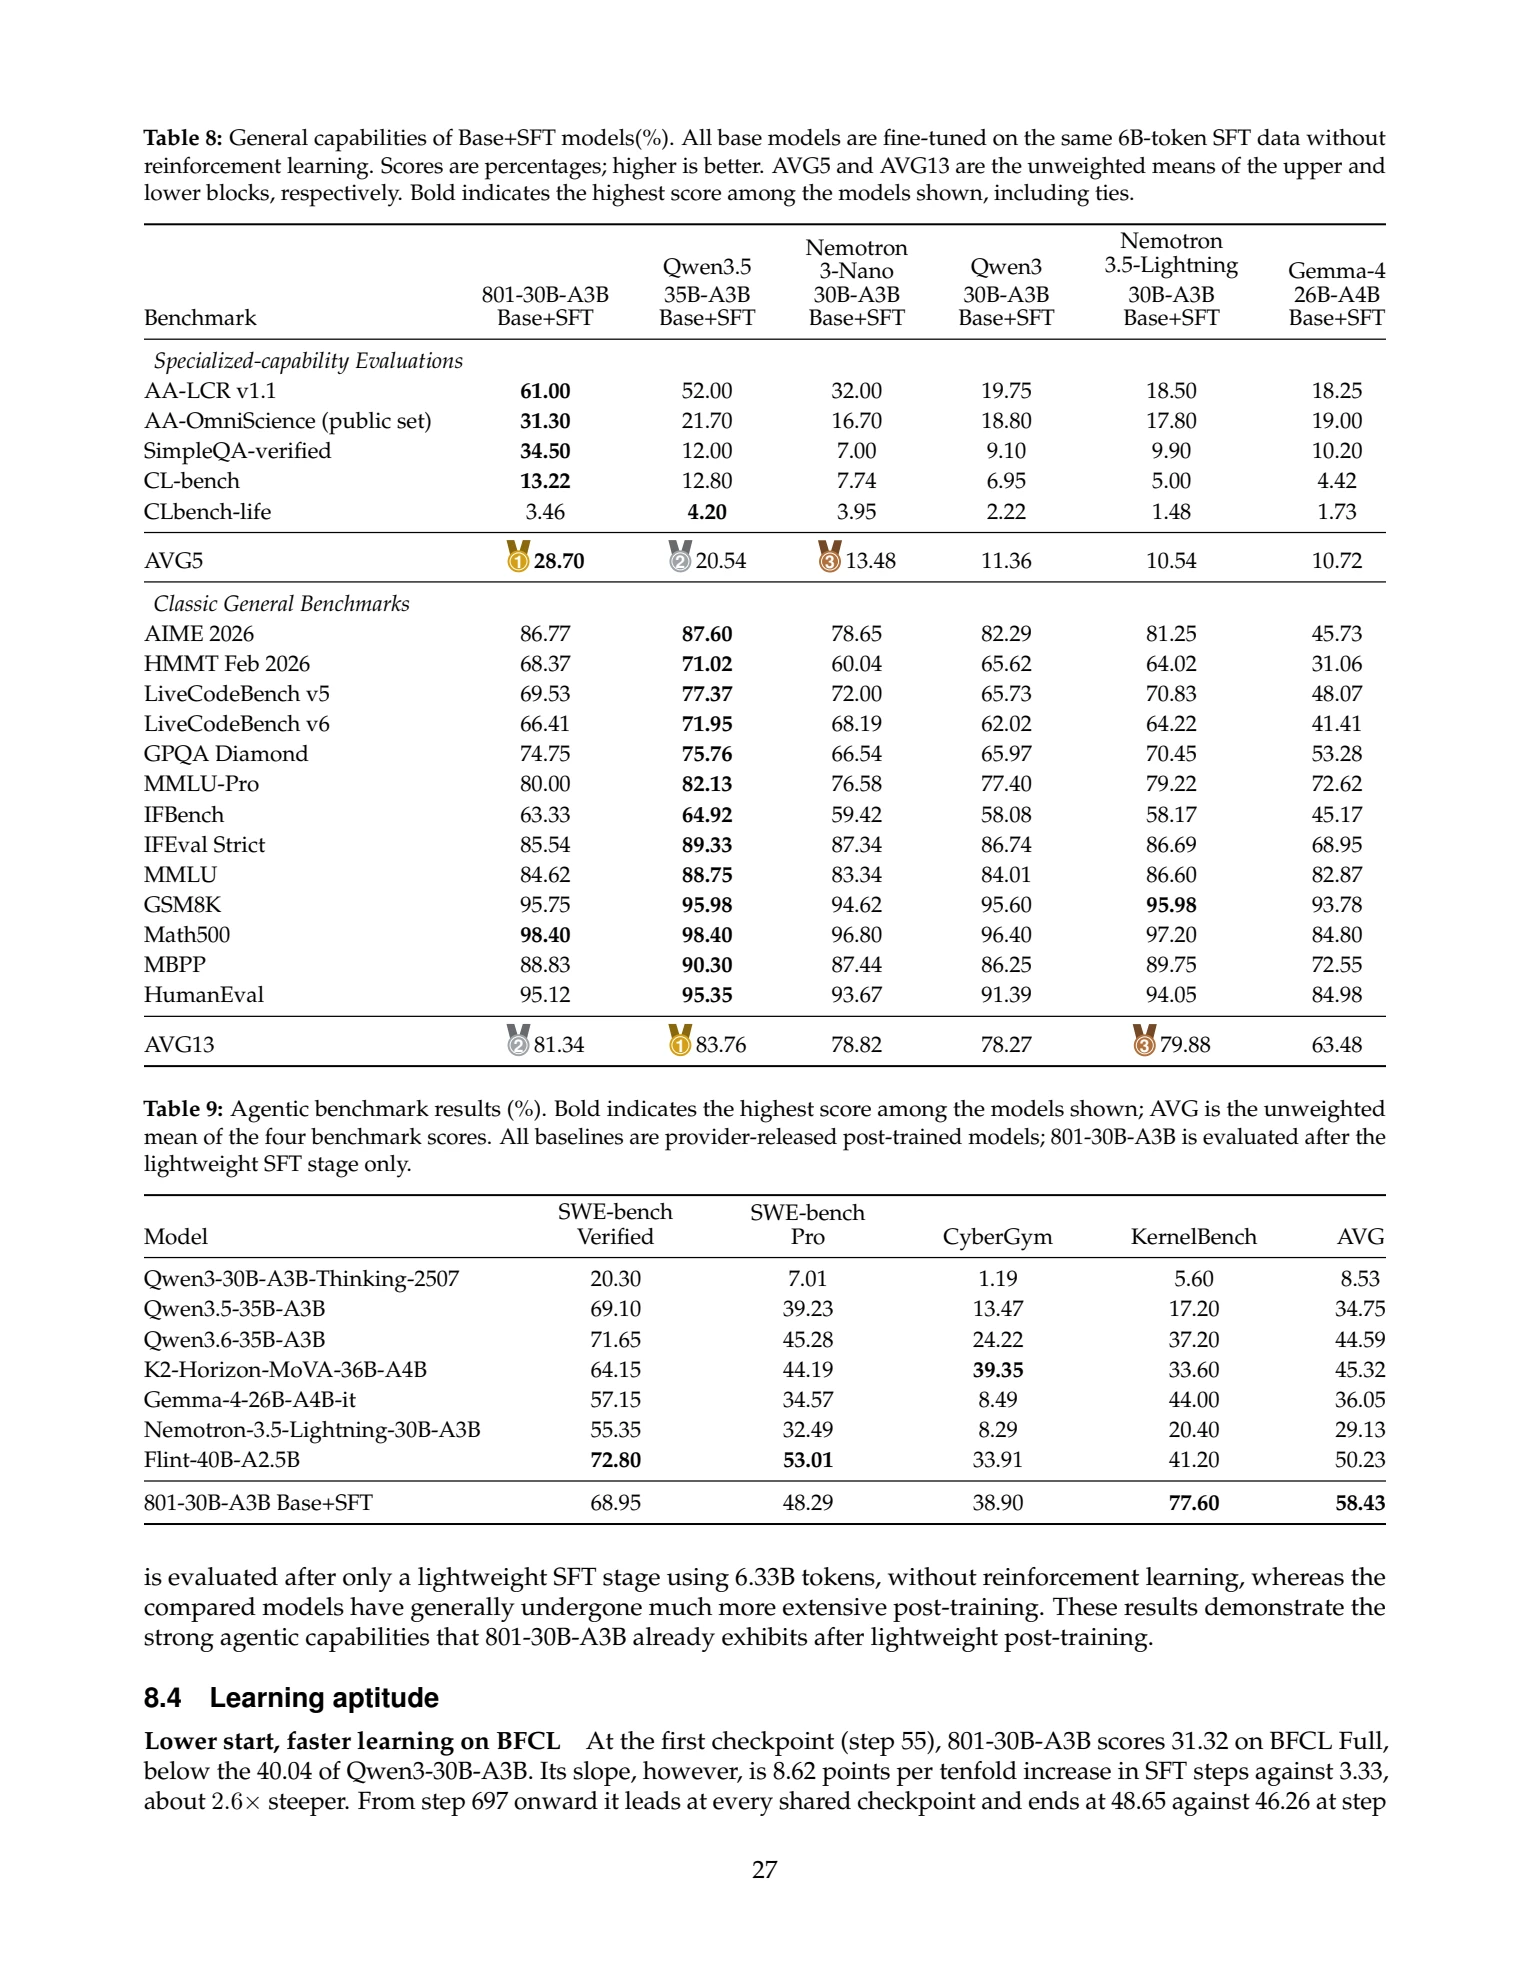
表 8 分为两组。下半部为 13 项常用经典通用基准,以 AVG13 汇总;上半部为五项专项能力评估,覆盖长上下文推理(AA-LCR v1.1)、事实知识(AA-OmniScience 公开集、SimpleQA-verified)、从上下文学习(CL-bench、CL-bench Life),均值为 AVG5。
专项能力表现。801 的 AVG5 为 28.70,比 Qwen3.5 的 20.54 高 8.16 分,五项中四项第 1。优势主要在长上下文推理与事实知识,尤其 AA-LCR v1.1 为 61.00%、AA-OmniScience 为 31.30%、SimpleQA-verified 为 34.50%。预训练语料已依据 SimpleQA 进行 8-gram 重叠去污染,因此测试集泄露不太可能解释该结果。例外是 CL-bench Life,801 落后于 Qwen3.5 与 Nemotron-3-Nano。
经典通用基准表现。801 的 AVG13 为 81.34,排名第 2,次于 Qwen3.5-35B-A3B 的 83.76,与基础评估排名一致(表 7)。数学、代码尤其突出:Math500 达 98.40%,并列最高;GSM8K 95.75%,HumanEval 95.12%。主要弱项是竞赛编程和指令遵循,体现在 LiveCodeBench v5 与 IFEval Strict。
8.3.2 智能体能力
在相同轻量 SFT 后,将 801 与厂商发布、通常经过完整后训练的模型比较,基准为 SWE-bench Verified、SWE-bench Pro、CyberGym、KernelBench。相近规模通用模型包括 Qwen3-30B-A3B-Thinking-2507、Qwen3.5-35B-A3B、Qwen3.6-35B-A3B、K2-Horizon-MoVA-36B-A4B、Gemma-4-26B-A4B-it、Nemotron-3.5-Lightning-30B-A3B;另含代码专用 MoE Flint-40B-A2.5B。结果见表 9。
不同于此前 Base+SFT 同条件比较,这里用仅经过 6.33B token Tiny-SFT 的本模型,对比经历完整后训练流程的发布模型。因此它是后训练潜力的参照,不是同条件比较。
801 获得最高 KernelBench 分数 77.60%,以及四项最高平均分 58.43。SWE-bench Pro 与 CyberGym 结果也具有竞争力。
第 27 页|通用与智能体基准结果
中文译文 · 对应英文原报告第 27 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
表 8:Base+SFT 模型通用能力(%)。所有基础模型在相同约 6B token SFT 数据上微调,不使用 RL。越高越好,AVG5/AVG13 分别为上、下半部的非加权均值,粗体表示最高分(含并列)。完整逐项数值保留在左栏原文。
列顺序:801、Qwen3.5、Nemotron-3-Nano、Qwen3、Nemotron-3.5-Lightning、Gemma-4,均为 Base+SFT。
专项 AVG5 依次为 28.70、20.54、13.48、11.36、10.54、10.72。
经典通用 AVG13 依次为 81.34、83.76、78.82、78.27、79.88、63.48。
表 9:智能体基准结果(%)。粗体表示最高,AVG 为四项非加权均值。全部基线均为厂商发布的后训练模型;801 只经过轻量 SFT。以下按“SWE-bench Verified / SWE-bench Pro / CyberGym / KernelBench / AVG”排列:
Qwen3-30B-A3B-Thinking-2507:20.30 / 7.01 / 1.19 / 5.60 / 8.53。
Qwen3.5-35B-A3B:69.10 / 39.23 / 13.47 / 17.20 / 34.75。
Qwen3.6-35B-A3B:71.65 / 45.28 / 24.22 / 37.20 / 44.59。
K2-Horizon-MoVA-36B-A4B:64.15 / 44.19 / 39.35 / 33.60 / 45.32。
Gemma-4-26B-A4B-it:57.15 / 34.57 / 8.49 / 44.00 / 36.05。
Nemotron-3.5-Lightning-30B-A3B:55.35 / 32.49 / 8.29 / 20.40 / 29.13。
Flint-40B-A2.5B:72.80 / 53.01 / 33.91 / 41.20 / 50.23。
801-30B-A3B Base+SFT:68.95 / 48.29 / 38.90 / 77.60 / 58.43。
值得强调,801 仅用 6.33B token 轻量 SFT,不含强化学习;对比模型一般经历了远更广泛的后训练。结果说明,801 在轻量后训练后已展现出较强智能体能力。
8.4 学习能力
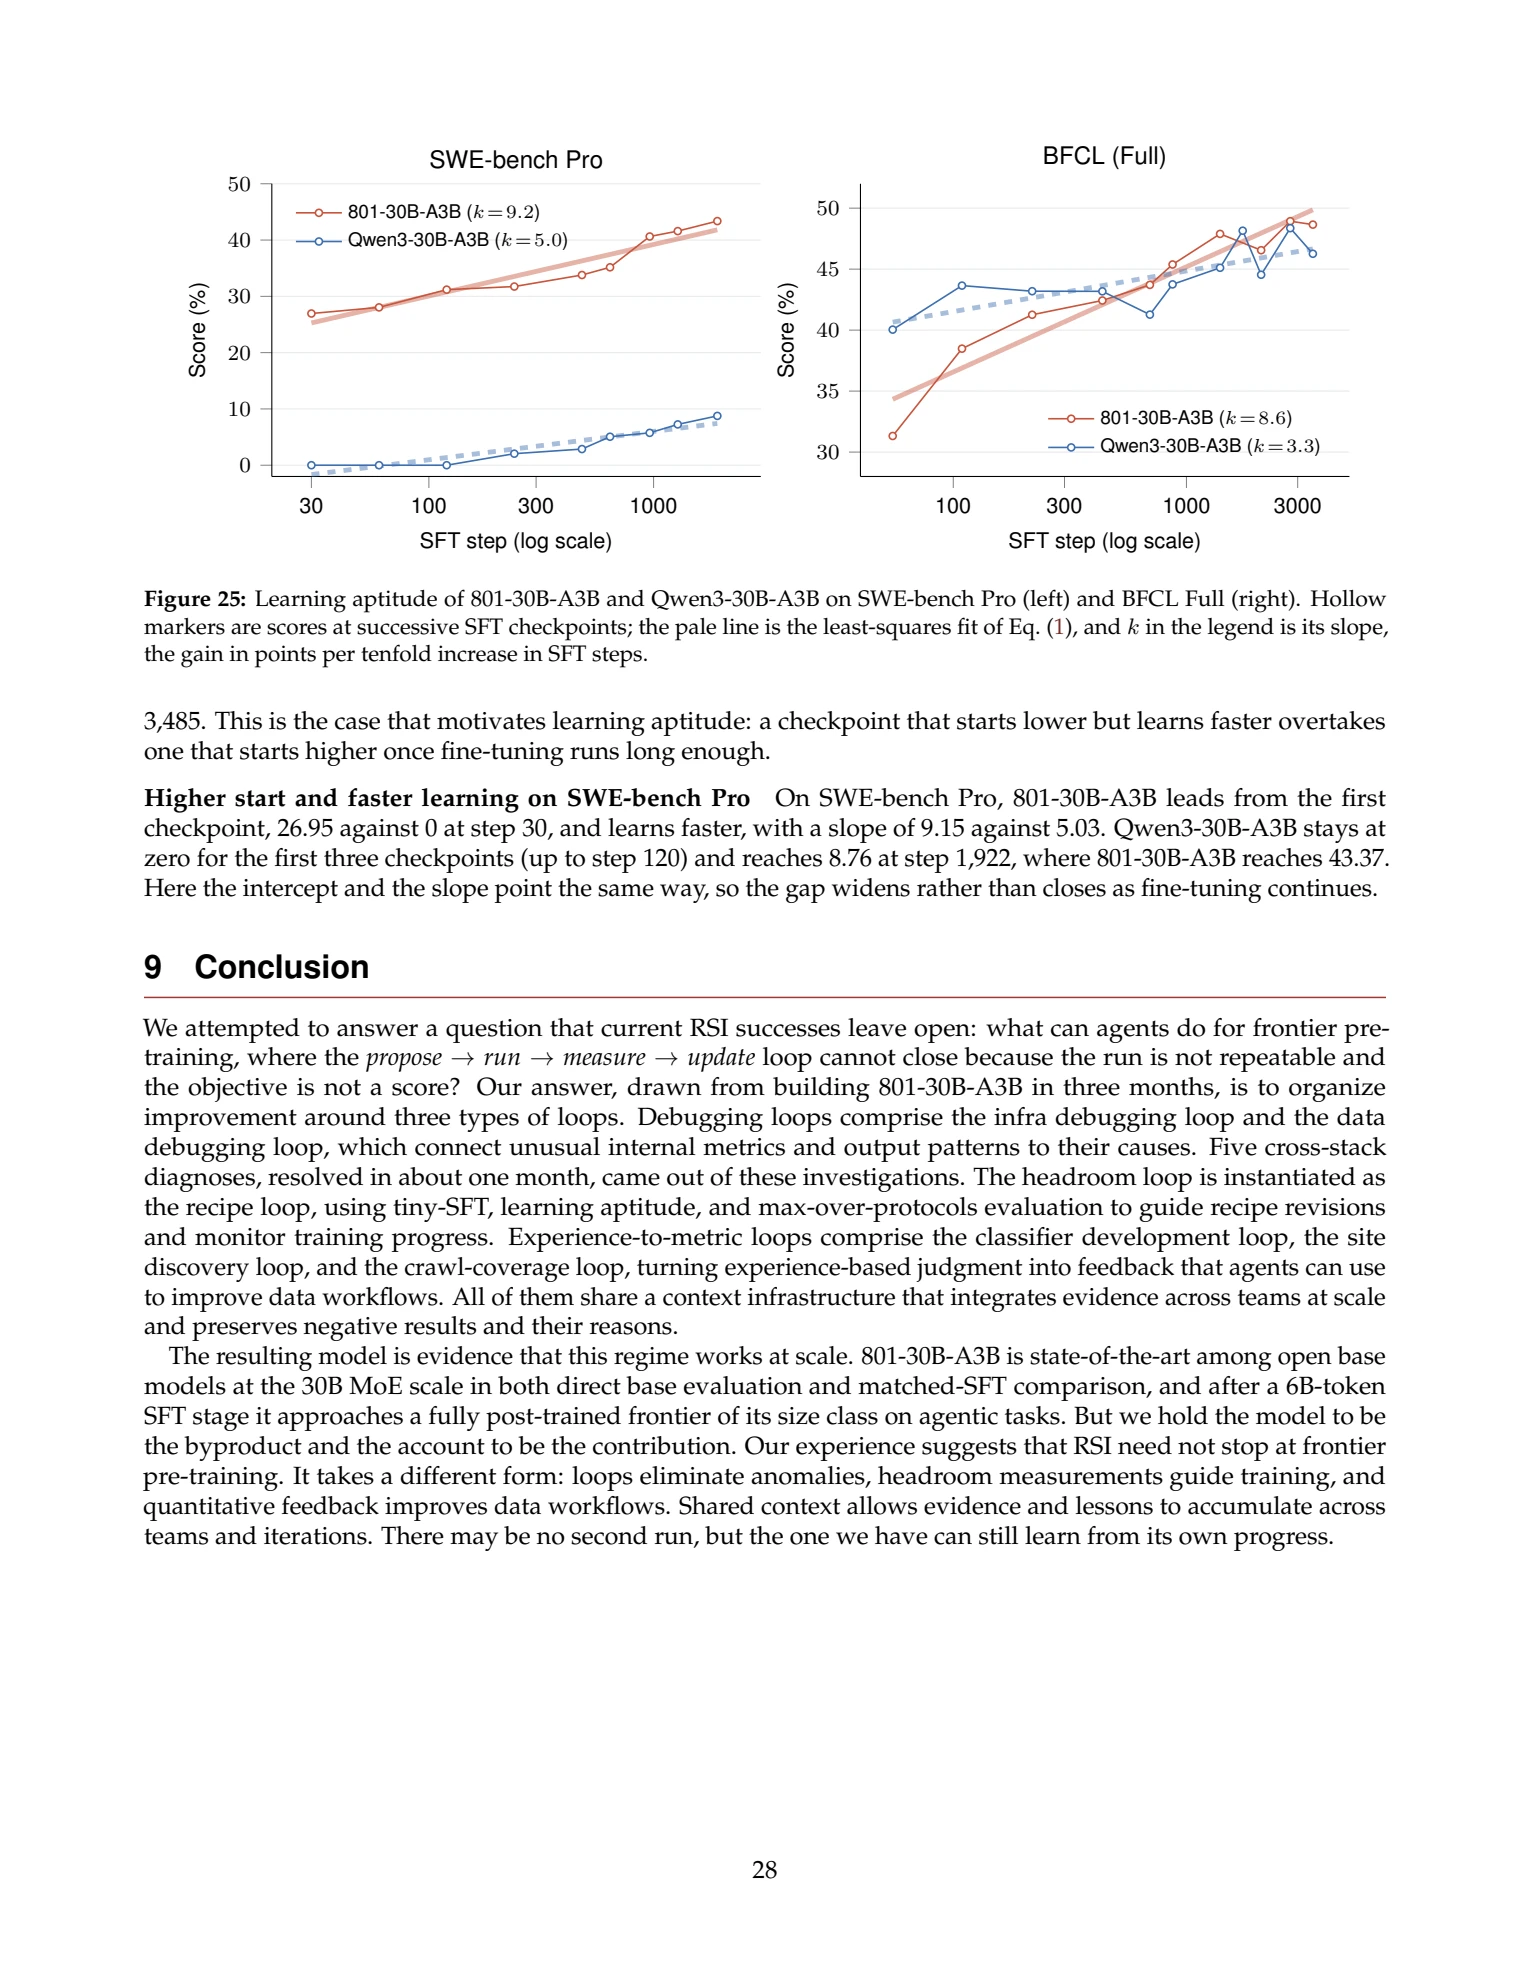
BFCL 上起点较低、学习更快。首个检查点(第 55 步),801 在 BFCL Full 上为 31.32,低于 Qwen3-30B-A3B 的 40.04;但其斜率为每十倍 SFT 步数提升 8.62 分,对方为 3.33,约陡 2.6 倍。从第 697 步开始,801 在每个共同检查点均领先,最终第 3,485 步达到 48.65,对方为 46.26。
第 28 页|学习能力与结论
中文译文 · 对应英文原报告第 28 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
图 25:801-30B-A3B 与 Qwen3-30B-A3B 在 SWE-bench Pro(左)和 BFCL Full(右)上的学习能力。空心点为连续 SFT 检查点分数,浅色直线为公式 (1) 的最小二乘拟合;图例 k 是斜率,表示 SFT 步数每增加十倍的分数增益。SWE-bench Pro 的 k 约为 9.2/5.0;BFCL Full 约为 8.6/3.3。横轴为对数尺度 SFT 步数,纵轴为分数(%)。
(接上页)这正是引入学习能力概念的原因:起点低但学习快的检查点,在微调足够久后,会超过起点高的模型。
SWE-bench Pro 上起点更高、学习也更快。第 30 步首个检查点,801 为 26.95,对方为 0;斜率 9.15 对 5.03。Qwen3 在前三个检查点(直到第 120 步)一直为零,第 1,922 步达到 8.76,而 801 达到 43.37。此时截距和斜率方向一致,随着微调继续,差距扩大而非缩小。
9 结论
现有 RSI 成功实践留下一个问题:前沿预训练不可重复、目标又不是一个分数,“提出→执行→测量→更新”无法闭合,智能体还能发挥什么作用?从三个月构建 801 的实践中,我们得出的回答是围绕三类循环组织改进。
调试循环包括基础设施调试与数据调试,将内部指标和输出模式的异常连接到根因,约一个月完成五项跨系统诊断。潜力循环具体化为配方循环,用 Tiny-SFT、学习能力、跨协议最大值指导配方修订并监控进展。经验量化循环包括分类器开发、站点发现和抓取覆盖,将经验判断变成智能体可用来改进数据工作流的反馈。所有循环共享上下文基础设施,大规模整合跨团队证据,并保留负面结果及原因。
最终模型表明这种范式能够在大规模场景运行。在 30B MoE 规模开放基础模型中,801 在直接基础评估和同条件 SFT 比较中达到领先水平;经过 6B token SFT 后,其智能体任务表现接近同规模完整后训练模型的前沿水平。
但我们认为,模型是副产品,实践记录才是贡献。经验说明 RSI 不必止步于前沿预训练,而是以不同形式出现:循环消除异常,潜力测量指导训练,定量反馈改进数据工作流。共享上下文让证据与经验跨团队、跨迭代累积。也许没有第二次完整训练,但我们拥有的这一次,依然能够从自身进展中学习。
第 29 页|作者贡献
中文译文 · 对应英文原报告第 29 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
作者贡献
作者按姓氏字母顺序排列。
贡献者:Xiaojie Cai、Jiayi Chen、Junwei Chen、Yu Chen、Sikai Cheng、Jinquan Dai、Siyuan Feng、Bin Fu、Dayuan Fu、Guosheng Gao、Qipeng Guo、Chenwei He、Zhulin Hu、Yaxing Huang、Shuomeng Jia、Mohan Jiang、Keyang Lei、Hongliang Li、Xuefeng Li、Zhaocheng Li、Jifan Lin、Pengfei Liu、Xinghan Liu、Yixiu Liu、Pengrui Lu、Siyuan Lu、Kai Lv、Tiantian Mi、Yang Nan、Yu Qiao、Yiwei Qin、Xipeng Qiu、Junhao Shi、Runzhou Shi、Jiadi Su、Bohao Tang、Hanning Wang、Keqi Wang、Pan Wang、Ran Wang、Shaojing Wang、Yishuo Wang、Zhixin Wang、Shenyu Wu、Muhang Xie、Tianze Xu、Hang Yan、Lvmanshan Ye、Hongche Yu、Junjie Yu、Lantian Zhang、Ruihang Zhang、Bin Zhao、Chenyang Zhou、Zijin Zhou、Wenhong Zhu、Zemu Zhu、Yumin Zhuang、Haoyang Zou。
机构:Shanghai Innovation Institute(上海创智学院)、XinxuAI。
人名与机构英文名保留原文,以便准确检索。
第 30 页|参考文献(一)
中文译文 · 对应英文原报告第 30 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
参考文献
本页及后续五页保留原始参考文献条目,包括作者、原始题名、年份、出版信息、链接和访问日期,便于检索与核对。
正文中的作者—年份引用与原始参考文献对应;此处不对书目信息进行改写。
第 31 页|参考文献(二)
中文译文 · 对应英文原报告第 31 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
参考文献(续)
原始作者、题名、年份、出版信息和链接见左栏原文。
第 32 页|参考文献(三)
中文译文 · 对应英文原报告第 32 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
参考文献(续)
原始作者、题名、年份、出版信息和链接见左栏原文。
第 33 页|参考文献(四)
中文译文 · 对应英文原报告第 33 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
参考文献(续)
原始作者、题名、年份、出版信息和链接见左栏原文。
第 34 页|参考文献(五)
中文译文 · 对应英文原报告第 34 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
参考文献(续)
原始作者、题名、年份、出版信息和链接见左栏原文。
第 35 页|参考文献(六)
中文译文 · 对应英文原报告第 35 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
参考文献(续)
本页为第 100 条参考文献:Zoph 等(2022),ST-MoE: Designing stable and transferable sparse expert models,arXiv:2202.08906。中文题意为“ST-MoE:设计稳定且可迁移的稀疏专家模型”。完整书目信息见左栏原文。
第 36 页|附录 A:逐层 MaxVio
中文译文 · 对应英文原报告第 36 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
附录 A:逐层 MaxVio 监测
图 26 报告训练过程中全部 48 个 MoE 层的 MaxVio 轨迹。多数层保持在相对稳定范围内,少数层则出现显著较大的违背值,尤其是图 7 已讨论的第 15 层明显上升。
竖直虚线表示训练阶段边界,横轴是以万亿为单位的训练 token 数。
图 26:全部 48 个 MoE 层的逐层 MaxVio 轨迹。
图内 Layer 1—Layer 48 对应第 1—48 层;Training tokens (T) 为训练 token 数(万亿)。MaxVio 越高表示负载越不均衡。
第 37 页|附录 B:监控基准
中文译文 · 对应英文原报告第 37 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
附录 B:预训练监控基准
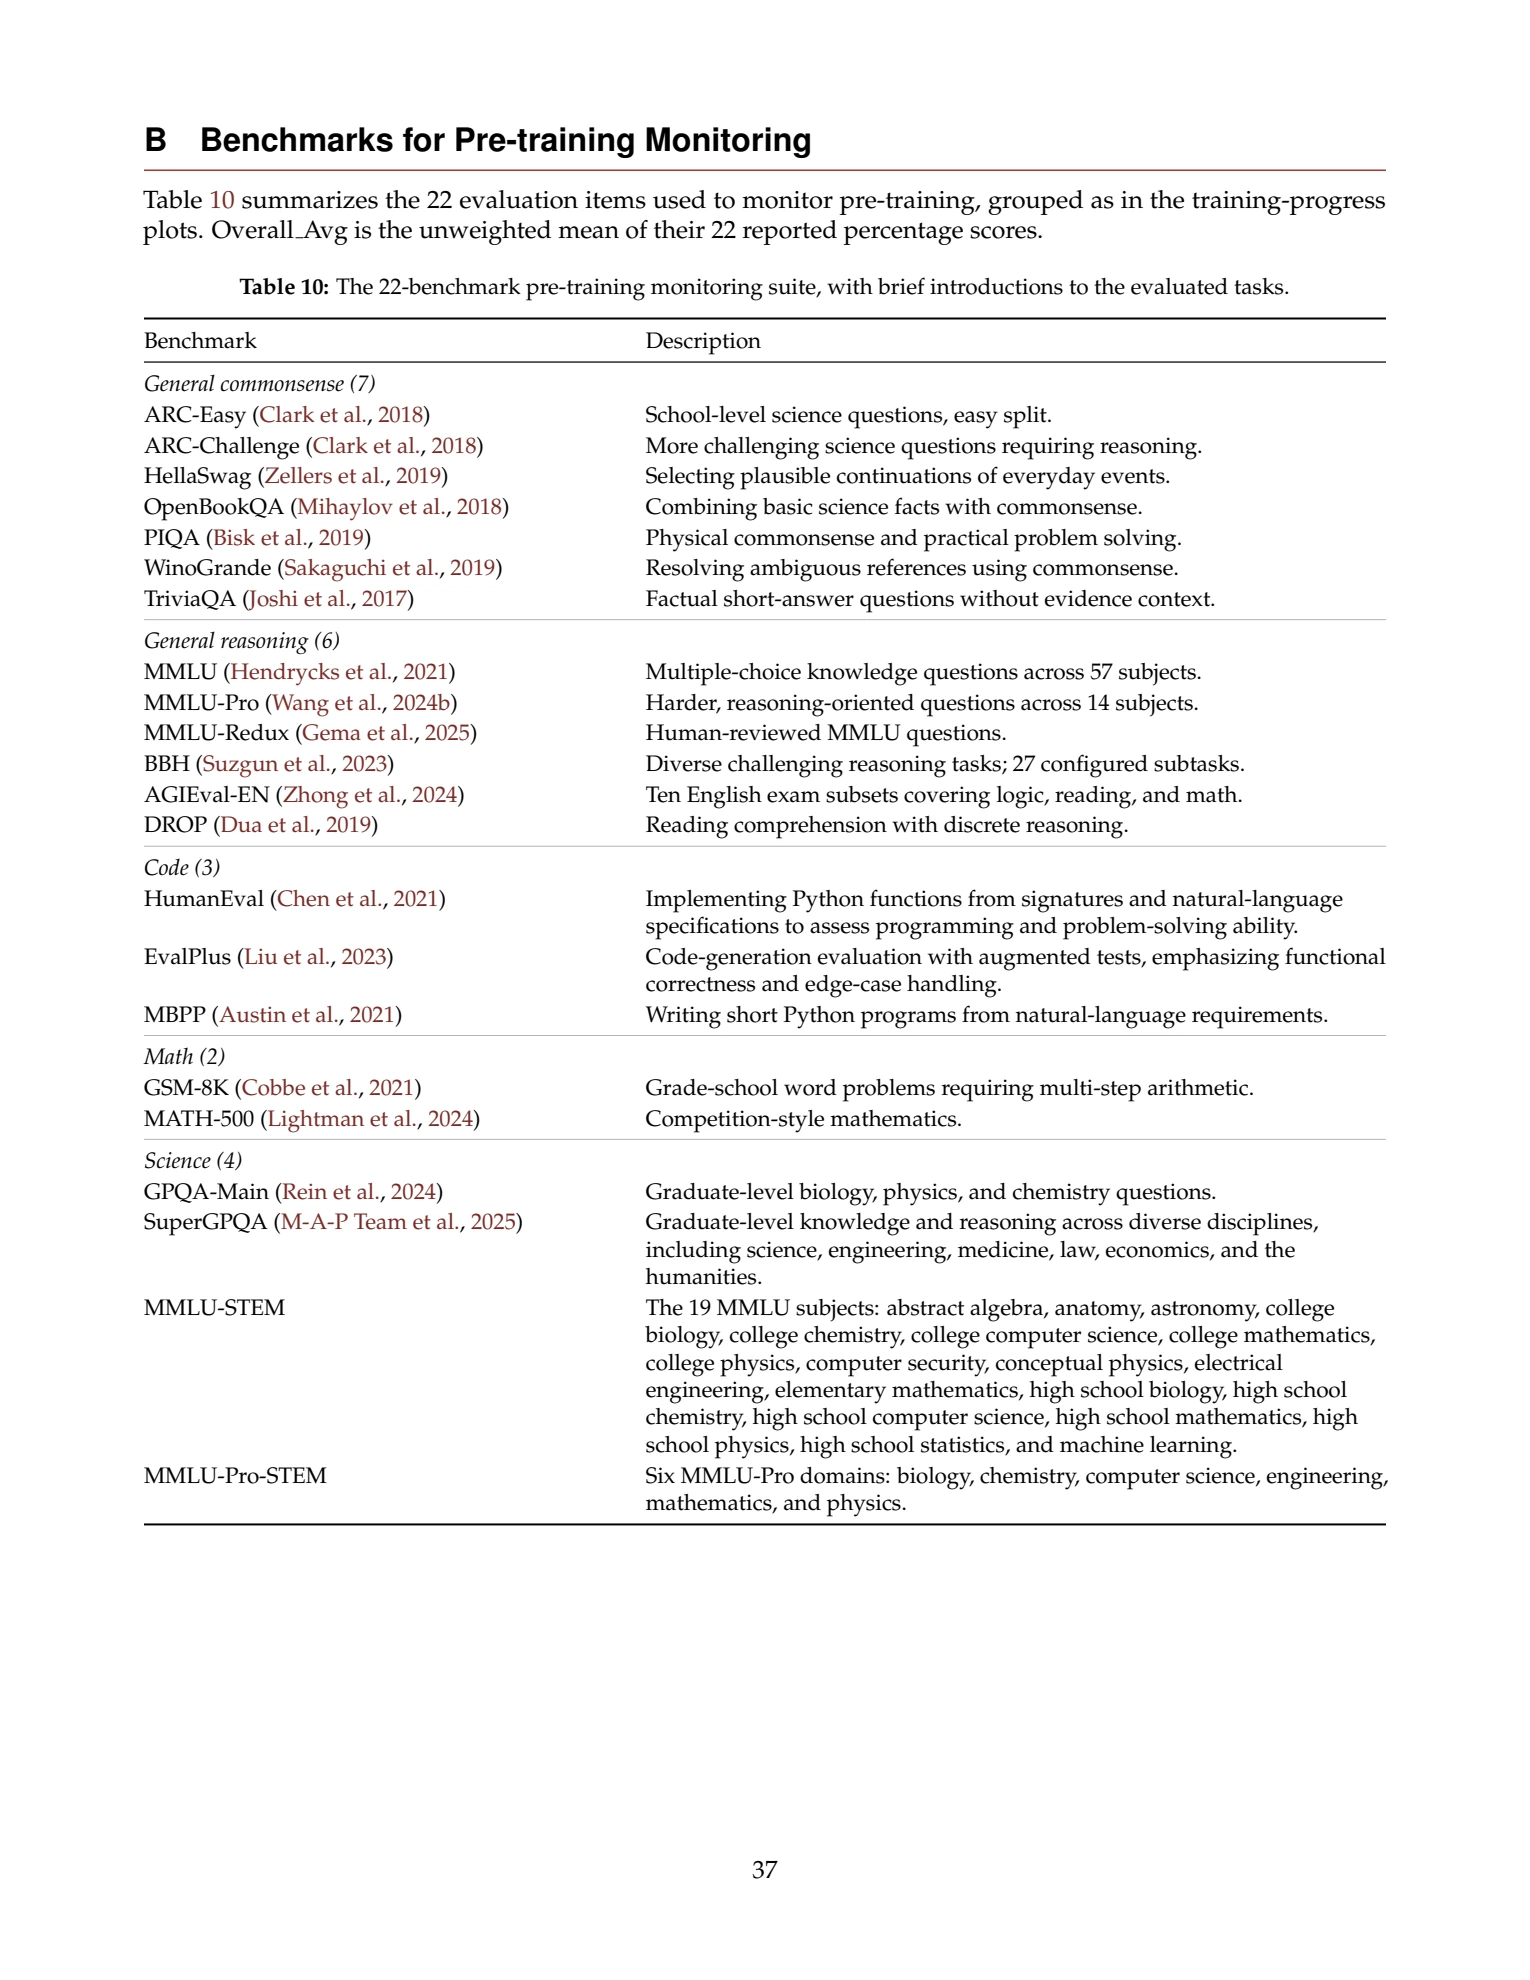
表 10 汇总用于监控预训练的 22 个评估项目,分组与训练进展图一致。Overall_Avg 是这 22 项百分比分数的非加权均值。
表 10:22 项预训练监控基准及任务简介。
通用常识(7 项)
ARC-Easy:学校层次科学问题,简单子集。
ARC-Challenge:需要推理的更难科学问题。
HellaSwag:为日常事件选择合理后续。
OpenBookQA:结合基础科学事实与常识。
PIQA:物理常识及实际问题求解。
WinoGrande:利用常识消解有歧义的指代。
TriviaQA:不提供证据上下文的事实简答题。
通用推理(6 项)
MMLU:覆盖 57 个学科的知识选择题。
MMLU-Pro:覆盖 14 个学科、更难且更强调推理的问题。
MMLU-Redux:经人工审查的 MMLU 题目。
BBH:多样高难推理任务,本配置包含 27 个子任务。
AGIEval-EN:10 个英语考试子集,涉及逻辑、阅读、数学。
DROP:需要离散推理的阅读理解。
代码(3 项)
HumanEval:依据函数签名和自然语言说明实现 Python 函数,评估编程与问题求解能力。
EvalPlus:采用扩充测试的代码生成评估,强调功能正确性和边界情况处理。
MBPP:根据自然语言需求编写简短 Python 程序。
数学(2 项)
GSM8K:需要多步算术的小学应用题。
MATH-500:竞赛式数学。
科学(4 项)
GPQA-Main:研究生层次的生物、物理和化学题。
SuperGPQA:跨科学、工程、医学、法学、经济、人文等学科的研究生层次知识与推理。
MMLU-STEM:MMLU 的 19 个学科,分别为抽象代数、解剖学、天文学、大学生物、大学化学、大学计算机科学、大学数学、大学物理、计算机安全、概念物理、电气工程、初等数学、高中生物、高中化学、高中计算机科学、高中数学、高中物理、高中统计、机器学习。
MMLU-Pro-STEM:MMLU-Pro 的六个领域,分别为生物、化学、计算机科学、工程、数学和物理。
各基准的作者—年份引用见左栏原表。
第 38 页|附录 C:评估协议
中文译文 · 对应英文原报告第 38 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
附录 C:基础模型的评估协议
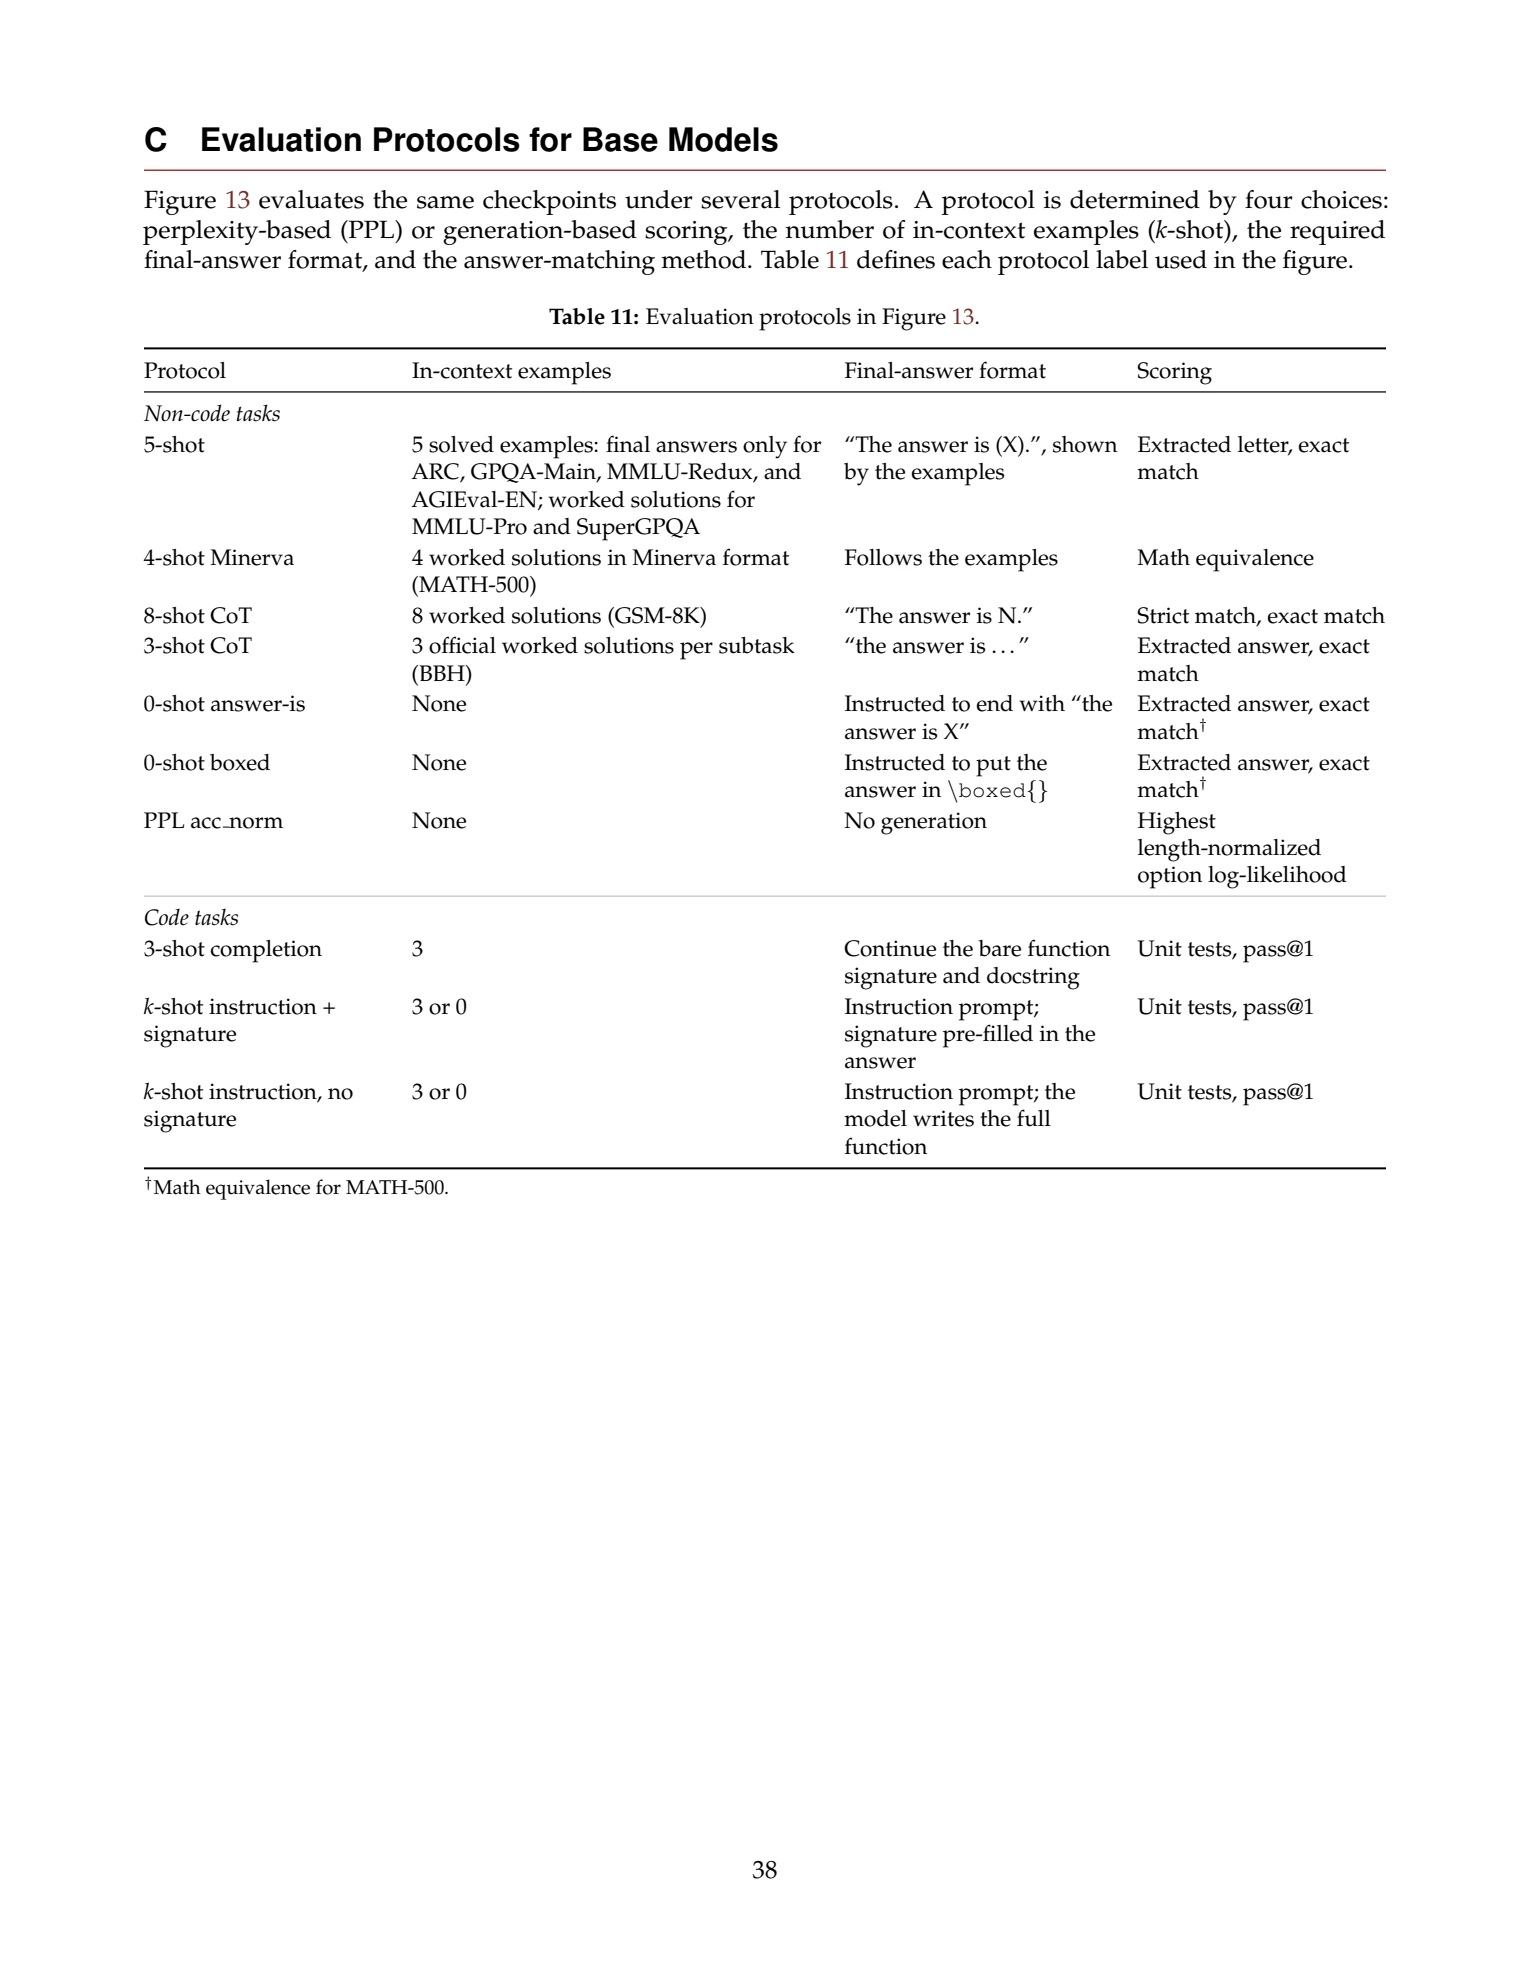
图 13 使用多个协议评估同一批检查点。协议由四项选择确定:困惑度(PPL)或生成式评分、上下文示例数(k-shot)、最终答案格式、答案匹配方法。表 11 定义图中各标签。
表 11:图 13 中的评估协议。
非代码任务
5-shot:5 个已解示例。ARC、GPQA-Main、MMLU-Redux、AGIEval-EN 示例只有最终答案;MMLU-Pro、SuperGPQA 提供解题过程。示例展示最终格式“The answer is (X).”;提取选项字母,精确匹配。
4-shot Minerva:4 个 Minerva 格式的完整解答(MATH-500);答案跟随示例格式;按数学等价评分。
8-shot CoT:8 个完整解答(GSM8K);最终格式“The answer is N.”;严格匹配、精确匹配。
3-shot CoT:每个 BBH 子任务使用 3 个官方完整解答;格式“the answer is ...”;提取答案后精确匹配。
0-shot answer-is:无示例;要求以“the answer is X”结尾;提取答案、精确匹配†。
0-shot boxed:无示例;要求将答案放入 \boxed{};提取答案、精确匹配†。
PPL acc_norm:无示例,无生成;选择长度归一化对数似然最高的选项。
代码任务
3-shot completion:3 个示例;接续裸函数签名和文档字符串;以单元测试评定 pass@1。
k-shot instruction + signature:3 或 0 个示例;指令式提示,答案预填函数签名;单元测试、pass@1。
k-shot instruction, no signature:3 或 0 个示例;指令式提示,模型自行编写完整函数;单元测试、pass@1。
† MATH-500 使用数学等价判断。
第 39 页|附录 D:代码执行环境
中文译文 · 对应英文原报告第 39 页。原始图表和公式完整保留在左栏;参考文献保留原始条目。
附录 D:代码评估环境
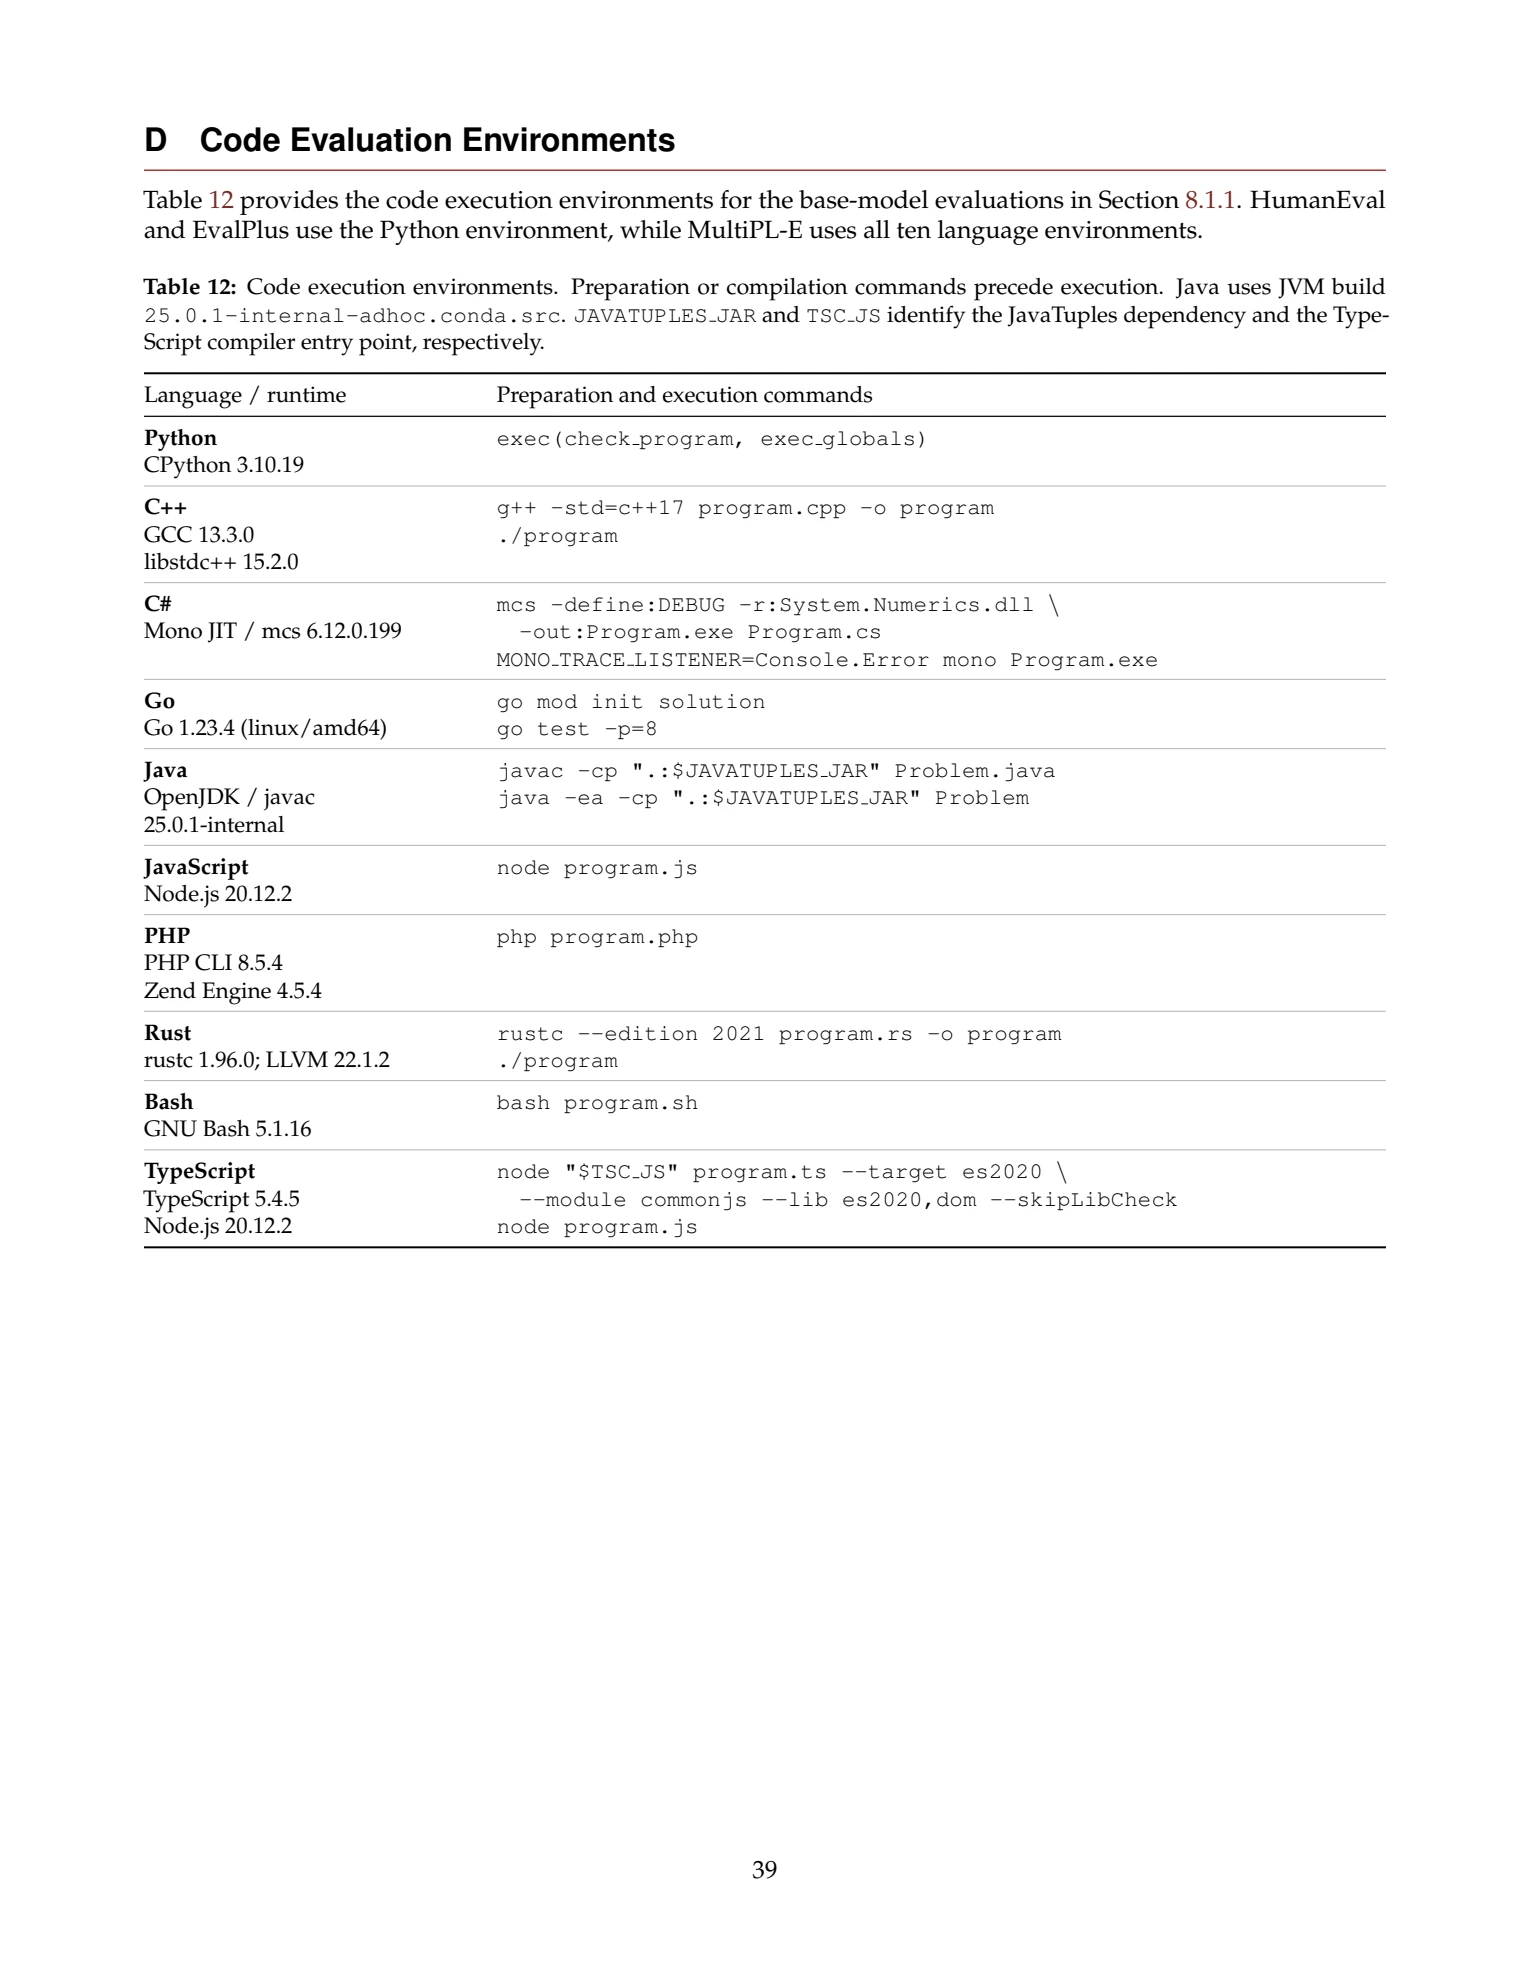
表 12 提供第 8.1.1 节基础模型评估的代码执行环境。HumanEval 和 EvalPlus 使用 Python;MultiPL-E 使用全部十种语言。
表 12:代码执行环境。准备或编译命令先于执行。Java 使用 JVM 构建 25.0.1-internal-adhoc.conda.src。JAVATUPLES_JAR 和 TSC_JS 分别表示 JavaTuples 依赖与 TypeScript 编译器入口。代码与命令保留原文:
Python|CPython 3.10.19
exec(check_program, exec_globals)
C++|GCC 13.3.0;libstdc++ 15.2.0
g++ -std=c++17 program.cpp -o program
./program
C#|Mono JIT/mcs 6.12.0.199
mcs -define:DEBUG -r:System.Numerics.dll \
-out:Program.exe Program.cs
MONO_TRACE_LISTENER=Console.Error mono Program.exe
Go|Go 1.23.4(linux/amd64)
go mod init solution
go test -p=8
Java|OpenJDK/javac 25.0.1-internal
javac -cp ".:$JAVATUPLES_JAR" Problem.java
java -ea -cp ".:$JAVATUPLES_JAR" Problem
JavaScript|Node.js 20.12.2
node program.js
PHP|PHP CLI 8.5.4;Zend Engine 4.5.4
php program.php
Rust|rustc 1.96.0;LLVM 22.1.2
rustc --edition 2021 program.rs -o program
./program
Bash|GNU Bash 5.1.16
bash program.sh
TypeScript|TypeScript 5.4.5;Node.js 20.12.2
node "$TSC_JS" program.ts --target es2020 \
--module commonjs --lib es2020,dom --skipLibCheck
node program.js